

Versione 1.0.0-alpha.1ultima
Capitolo 1.4
L'IA alle vostre condizioni
Come Nexus utilizza l'intelligenza artificiale (IA) alle condizioni dell'organizzazione stessa. L'organizzazione fornisce e possiede le proprie chiavi dei modelli, un unico centralino instrada ogni chiamata ai modelli verso i fornitori scelti, i modelli locali vengono eseguiti sui propri server e nulla viene inviato ad Adverant a sua insaputa.
Questa pagina è stata tradotta dall'IA a partire dall'originale in inglese. In caso di dubbi, fa fede la pagina in inglese. Legga questa pagina in inglese
L'installazione operativa della Harrow Port Authority non utilizza alcun provider di IA in hosting. Non ha alcun accesso a Internet, pertanto ogni modello utilizzato viene eseguito sulle schede grafiche nella propria sala macchine: un Qwen3-32B per la maggior parte del lavoro, affiancato da un Llama 3.3 70B e da un Gemma 3 27B. Quando Aoife Brennan, responsabile IT di Harrow, apre la pagina del centralino IA, visualizza esattamente questi modelli, il compito svolto da ciascuno e il luogo verso cui è consentito indirizzare ogni chiamata. Quel luogo è l'edificio stesso.
La maggior parte delle organizzazioni combinerà modelli in hosting e locali. Il principio non cambia: l'organizzazione decide quale intelligenza artificiale (IA) utilizzare, dove possono transitare i propri dati e quanto spendere, e Nexus applica tali decisioni a ogni chiamata.
La chiave appartiene all'organizzazione
Quando un'organizzazione utilizza un modello in hosting, fornisce la propria chiave. Nexus conserva le chiavi nel pool IA dell'organizzazione. Esse appartengono all'organizzazione e non a una singola persona al suo interno. I proprietari e gli amministratori le aggiungono e le revocano. Il pool accetta chiavi per Anthropic, Google Gemini, OpenRouter e Scaleway, e può puntare a qualsiasi server gestito dall'organizzazione che utilizzi il comune protocollo compatibile con OpenAI.
Una chiave viene digitata una sola volta. Nexus la crittografa al momento della ricezione e non la mostra mai più, in nessun luogo. Da quel momento in poi, la chiave appare solo come un breve indizio accompagnato da una dicitura come "impostata da Aoife il 3 set". Quando una chiave viene revocata, il centralino interrompe immediatamente l'invio di chiamate verso di essa e la chiave rimane elencata come revocata, in modo da preservare l'integrità dello storico di chi ha utilizzato cosa. Nulla viene eliminato.
Ogni organizzazione ha il proprio account presso il provider e la propria fatturazione. Non esiste alcuna chiave condivisa di Adverant dietro l'IA di un tenant, quindi la spesa di un'organizzazione non si mescola mai con quella di un'altra, e un'organizzazione che cambia provider si limita a revocare una chiave e ad aggiungerne un'altra.
Le chiavi per le fonti di dati esterne sono tenute separate dalle chiavi dei modelli. Harrow, ad esempio, conserva una chiave per il feed delle posizioni delle navi che legge, in una pagina separata dedicata alle chiavi per dati esterni. Tale pagina rifiuta categoricamente una chiave di modello, poiché le chiavi dei modelli appartengono esclusivamente al pool.
Il centralino instrada ogni chiamata
Le app e gli agenti in Nexus non chiamano mai direttamente un modello, e nemmeno i flussi di lavoro. Si rivolgono al centralino IA. Quest'ultimo detiene le chiavi ed effettua la scelta finale del provider e del modello. Un'app può indicare cosa preferirebbe, ad esempio un modello veloce per risposte brevi, e il centralino asseconda tale richiesta quando l'organizzazione ha configurato quel provider. In caso contrario, il centralino ne sceglie un altro tra quelli consentiti dall'organizzazione. Un'app non può mai imporre un modello che l'organizzazione non ha scelto.
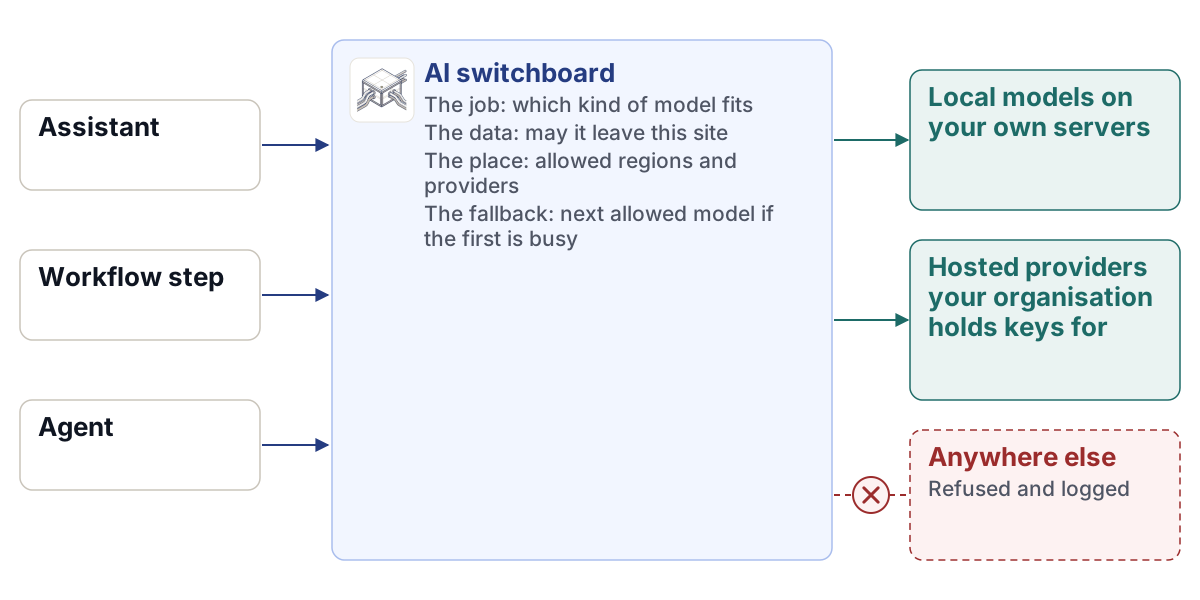
Prima che una chiamata parta, l'app la etichetta con l'unità e il ruolo richiedenti e con il livello di sensibilità dei dati. Il centralino instrada la chiamata in base a tale etichetta e non apre mai la chiamata stessa. Prende quattro decisioni.
La prima riguarda il compito. La lettura di un modulo scansionato richiede un modello diverso rispetto alla stesura di una lettera, pertanto l'organizzazione associa ciascun tipo di compito (predefinito, veloce, ragionamento, codice e contesto lungo) ai modelli che preferisce. La seconda riguarda i dati. I dati personali o segreti possono essere vincolati ai modelli sull'hardware dell'organizzazione, mentre il materiale pubblico può utilizzarne altri. La terza riguarda il luogo. Le chiamate sono indirizzate solo alle regioni e ai provider consentiti dall'unità, e una chiamata diretta altrove viene rifiutata, con la registrazione del rifiuto a sistema. La quarta riguarda il fallback. Se un modello è lento o non disponibile, il modello consentito successivo prende in carico la chiamata. Una chiave che genera un errore viene messa in pausa per 60 secondi e ignorata; dopo cinque errori consecutivi viene disattivata. La chiamata raggiunge un modello consentito oppure attende e, se nessuna delle due opzioni funziona, restituisce un errore con una motivazione chiara. Non viene mai indirizzata verso destinazioni vietate dalle regole.
Le regole partono a livello di organizzazione e possono essere ristrette per ciascuna unità e app, e per ciascun tipo di dati. Un'unità può essere vincolata a modelli locali sul proprio hardware mentre un'altra utilizza un modello in hosting nell'Unione Europea. Un'unità non può mai avere regole meno restrittive rispetto all'organizzazione.

Ogni chiamata viene conteggiata, mai letta
Il centralino conteggia ogni chiamata per persona e team, nonché per app e giorno. Misura anche la durata e il costo di ciascuna chiamata. Non memorizza né legge mai ciò che è stato chiesto o ciò che è stato restituito. Ogni budget ha un responsabile designato e un limite. I budget possono essere impostati su quattro livelli, dall'organizzazione fino alla singola persona, passando per le unità e le competenze. Quando un budget viene raggiunto, si applica la regola scelta dal suo responsabile. Il lavoro può proseguire o passare a un modello più economico, oppure può fermarsi fino all'approvazione di un amministratore. Il reparto finanziario riceve un unico rendiconto che copre sia i modelli in hosting sia quelli locali.
Modelli sui vostri server
Qualsiasi modello eseguito dall'organizzazione sul proprio hardware può essere collegato al centralino, purché utilizzi il protocollo compatibile con OpenAI. Il Suo team IT fornisce al centralino l'indirizzo del server, visualizza i modelli rilevati e sceglie quale compito assegnare a ciascuno. Al termine dell'operazione, la pagina di connessione conferma "Nulla esce da questo sito". Per impostazione predefinita, all'interno dell'installazione viene eseguito anche un modello di piccole dimensioni su processori standard che trasforma il testo in formato ricercabile, in modo che la ricerca stessa non necessiti di alcun servizio esterno. L'utilizzo di un servizio in hosting a tale scopo è una scelta che spetta all'organizzazione.
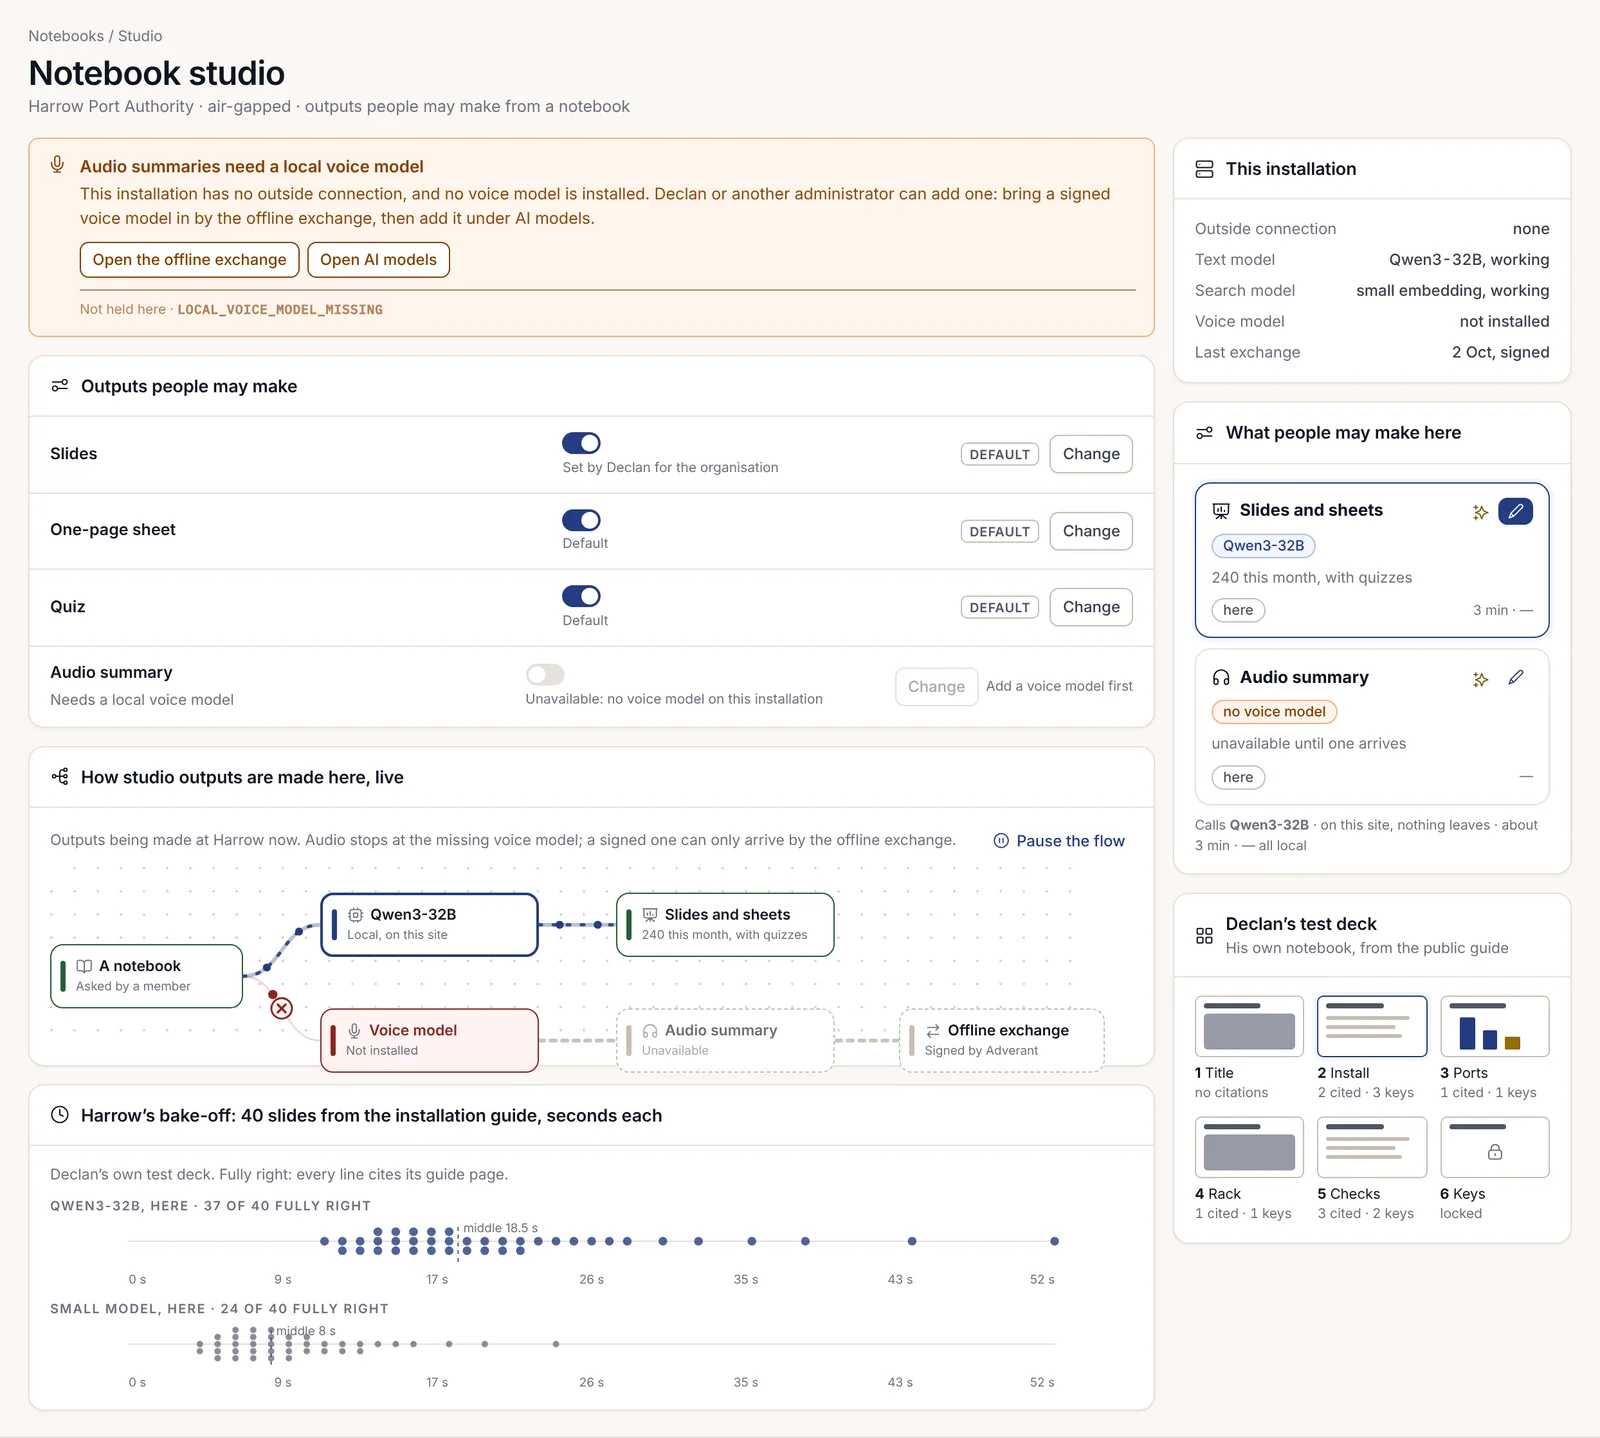
In un sito isolato dalla rete (air-gapped) come Harrow, i modelli locali sono gli unici disponibili. Ciò funziona bene per la maggior parte delle attività svolte dalle persone, ma comporta un limite oggettivo: una funzionalità richiede che il relativo modello sia installato in loco. Il notebook studio di Harrow può creare presentazioni e riepiloghi di una pagina a partire dai modelli locali, ma un riepilogo audio necessita di un modello vocale; finché questo non viene installato, lo studio lo segnala chiaramente e indica chi può aggiungerlo.
I modelli locali possono anche verificarsi a vicenda. Presso Harrow, il lavoro svolto da una famiglia di modelli viene revisionato da un'altra (ad esempio, Qwen3-32B da Llama 3.3 70B), in modo che un punto cieco in una famiglia non venga controllato dalla stessa famiglia.
Per le organizzazioni che desiderano spingersi oltre, il componente aggiuntivo Model factory addestra e ottimizza i modelli sulle schede grafiche dell'organizzazione, impiegando esclusivamente i dati che l'organizzazione è autorizzata a utilizzare.
Nessuna chiave significa nessuna IA, e Nexus lo dichiara
Un'organizzazione senza alcun modello connesso non ottiene risposte dall'IA. Si tratta di un limite progettuale intenzionale, non di un malfunzionamento. Nexus non prende in prestito silenziosamente una chiave condivisa per colmare la lacuna, poiché in tal caso i dati dell'organizzazione finirebbero in un luogo mai scelto dall'organizzazione stessa.
Ciò che le persone vedono invece è un semplice riquadro informativo. L'assistente spiega che non può rispondere perché non c'è alcun modello connesso, riporta il codice MODEL_NOT_CONNECTED in caratteri piccoli e propone l'opzione "Connetti un modello" a chi dispone dei relativi permessi. I lavori in attesa di un modello vengono eseguiti non appena ne torna disponibile uno.
Nulla va ad Adverant a vostra insaputa
Un'istanza di Nexus in self-hosting non invia dati sul Suo personale ad Adverant. Quando un'informazione deve effettivamente uscire, Lei può leggerla prima di inviarla.
Un'installazione sulla Sua infrastruttura prepara un rendiconto annuale di utilizzo contenente esclusivamente dei contatori: quanti posti utente e dispositivi sono in uso e quali gruppi di funzionalità. Il Suo amministratore lo legge riga per riga prima di caricarlo o di esportarlo su un disco. Un sito isolato dalla rete che richiede una nuova funzionalità invia un file di richiesta che indica il nome dell'installazione e la funzionalità, insieme all'impronta digitale dell'installazione. Nessuna informazione riguardante le persone o il loro lavoro viene allegata. Quando ha bisogno di assistenza, un pacchetto di supporto mostra cosa raccoglierà e un'anteprima di ciò che viene oscurato prima che qualsiasi dato venga inviato.
Il personale di Adverant non può ispezionare l'installazione di un cliente di propria iniziativa. Se il supporto tecnico ha necessità di farlo, la richiesta avviene tramite un ticket di assistenza e il Suo amministratore può accettare o rifiutare. L'accettazione ha una durata prestabilita di massimo otto ore e un ambito definito, come ad esempio i log del motore. Non copre mai i messaggi o i file delle persone, né la loro posta o la loro memoria.
L'abbonamento personale di un utente non diventa mai dell'organizzazione
Alcune persone pagano in proprio un abbonamento per l'IA, come un piano Claude Max. Nexus non lo considera mai come appartenente all'organizzazione. Un abbonamento personale non può essere aggiunto al pool dell'organizzazione (il pool lo rifiuta espressamente) e nessuna pagina che mostra la configurazione IA dell'organizzazione ne elenca mai uno.
Le ragioni sono pratiche. Un piano personale viene acquistato a condizioni per i consumatori valide per una sola persona, quindi instradare il lavoro dei colleghi attraverso di esso violerebbe tali condizioni. L'organizzazione non può vederne l'utilizzo né impostarvi un budget, e l'abbonamento sparisce quando quella persona lascia l'azienda. L'IA dell'organizzazione dovrebbe basarsi su chiavi di proprietà dell'organizzazione stessa, e in Nexus è così.