

Ogni chiamata ai modelli, instradata dove consentite.
Le piattaforme su Nexus non chiamano mai un modello direttamente: interrogano il centralino. Questo sceglie il modello più adatto al compito, invia la chiamata in una sede consentita dalle vostre regole e la addebita su un budget con un responsabile definito.
Una domanda. Quattro decisioni, in millisecondi.
Prima che una chiamata parta, la piattaforma la etichetta: quale unità la richiede, per quale ruolo e quanto sono sensibili i dati. Il centralino instrada la chiamata in base a quell'etichetta senza mai aprirne il contenuto. Se la prima opzione è occupata o non disponibile, subentra la successiva opzione consentita.
Il compito
Leggere un modulo scansionato, redigere una lettera e verificare una decisione richiedono modelli diversi. Ogni applicazione indica di che tipo di compito si tratta.
I dati
I dati personali o riservati possono essere vincolati ai vostri modelli sul vostro hardware. I dati pubblici possono utilizzare più opzioni.
La sede
Le chiamate raggiungono solo le aree geografiche e i fornitori consentiti dall'unità. Una chiamata destinata all'esterno del perimetro viene rifiutata e il rifiuto viene registrato.
Il ripiego
Se un modello è lento o non disponibile, risponde il modello successivo consentito. Nessuno aspetta e nessuna regola viene infranta.
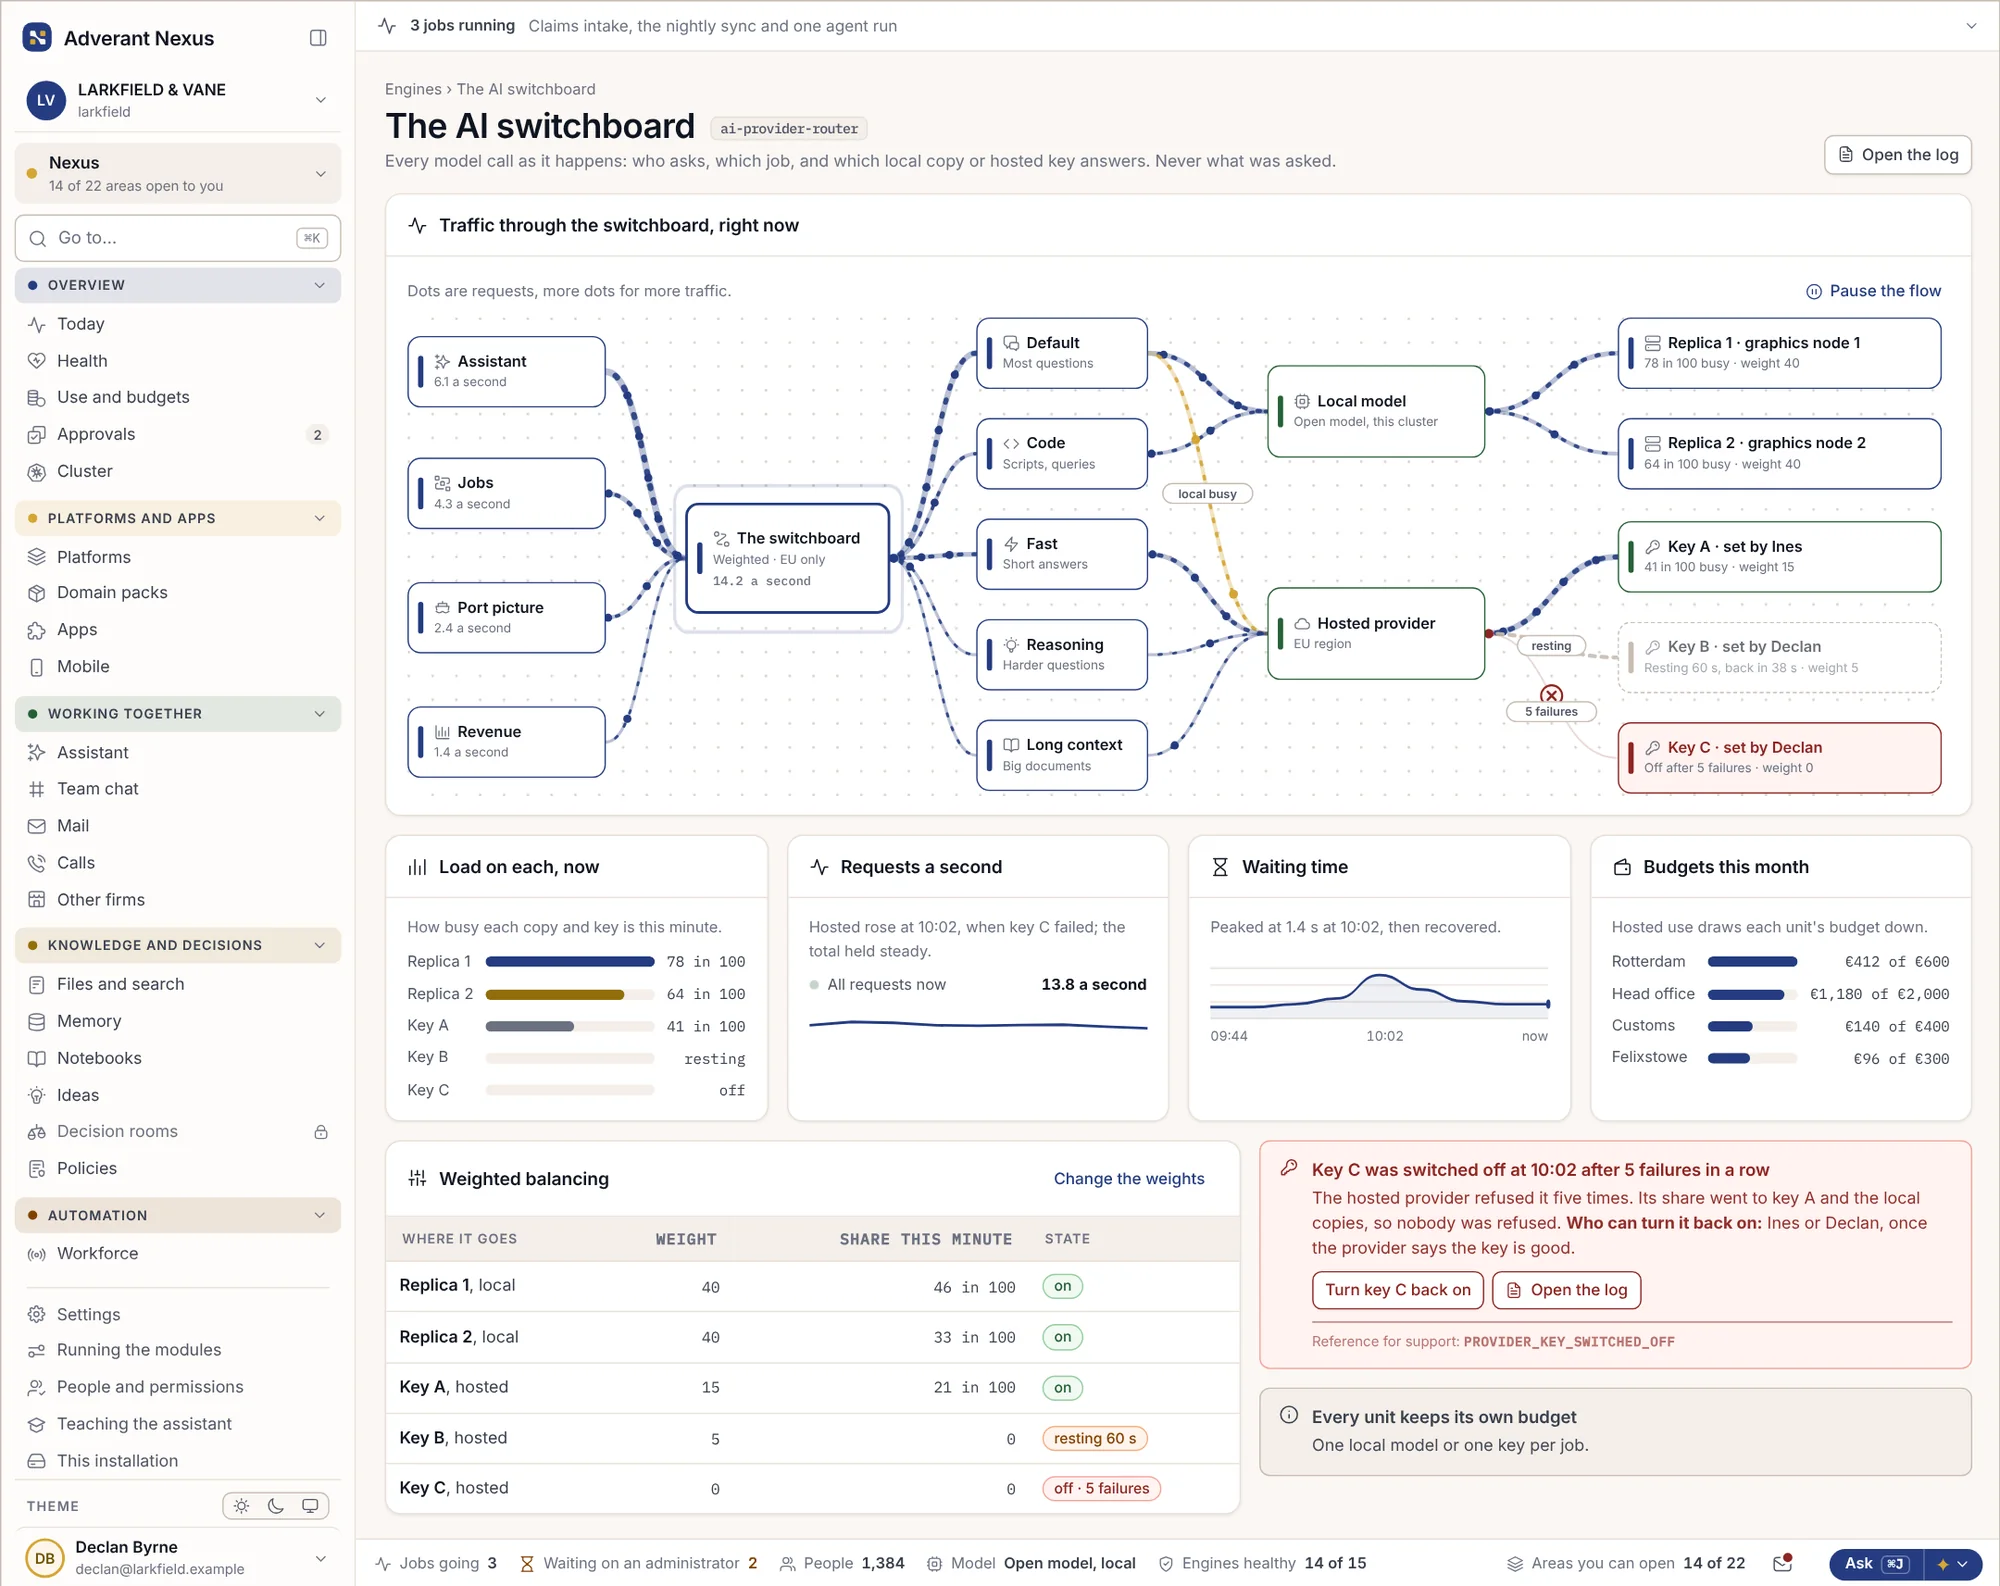
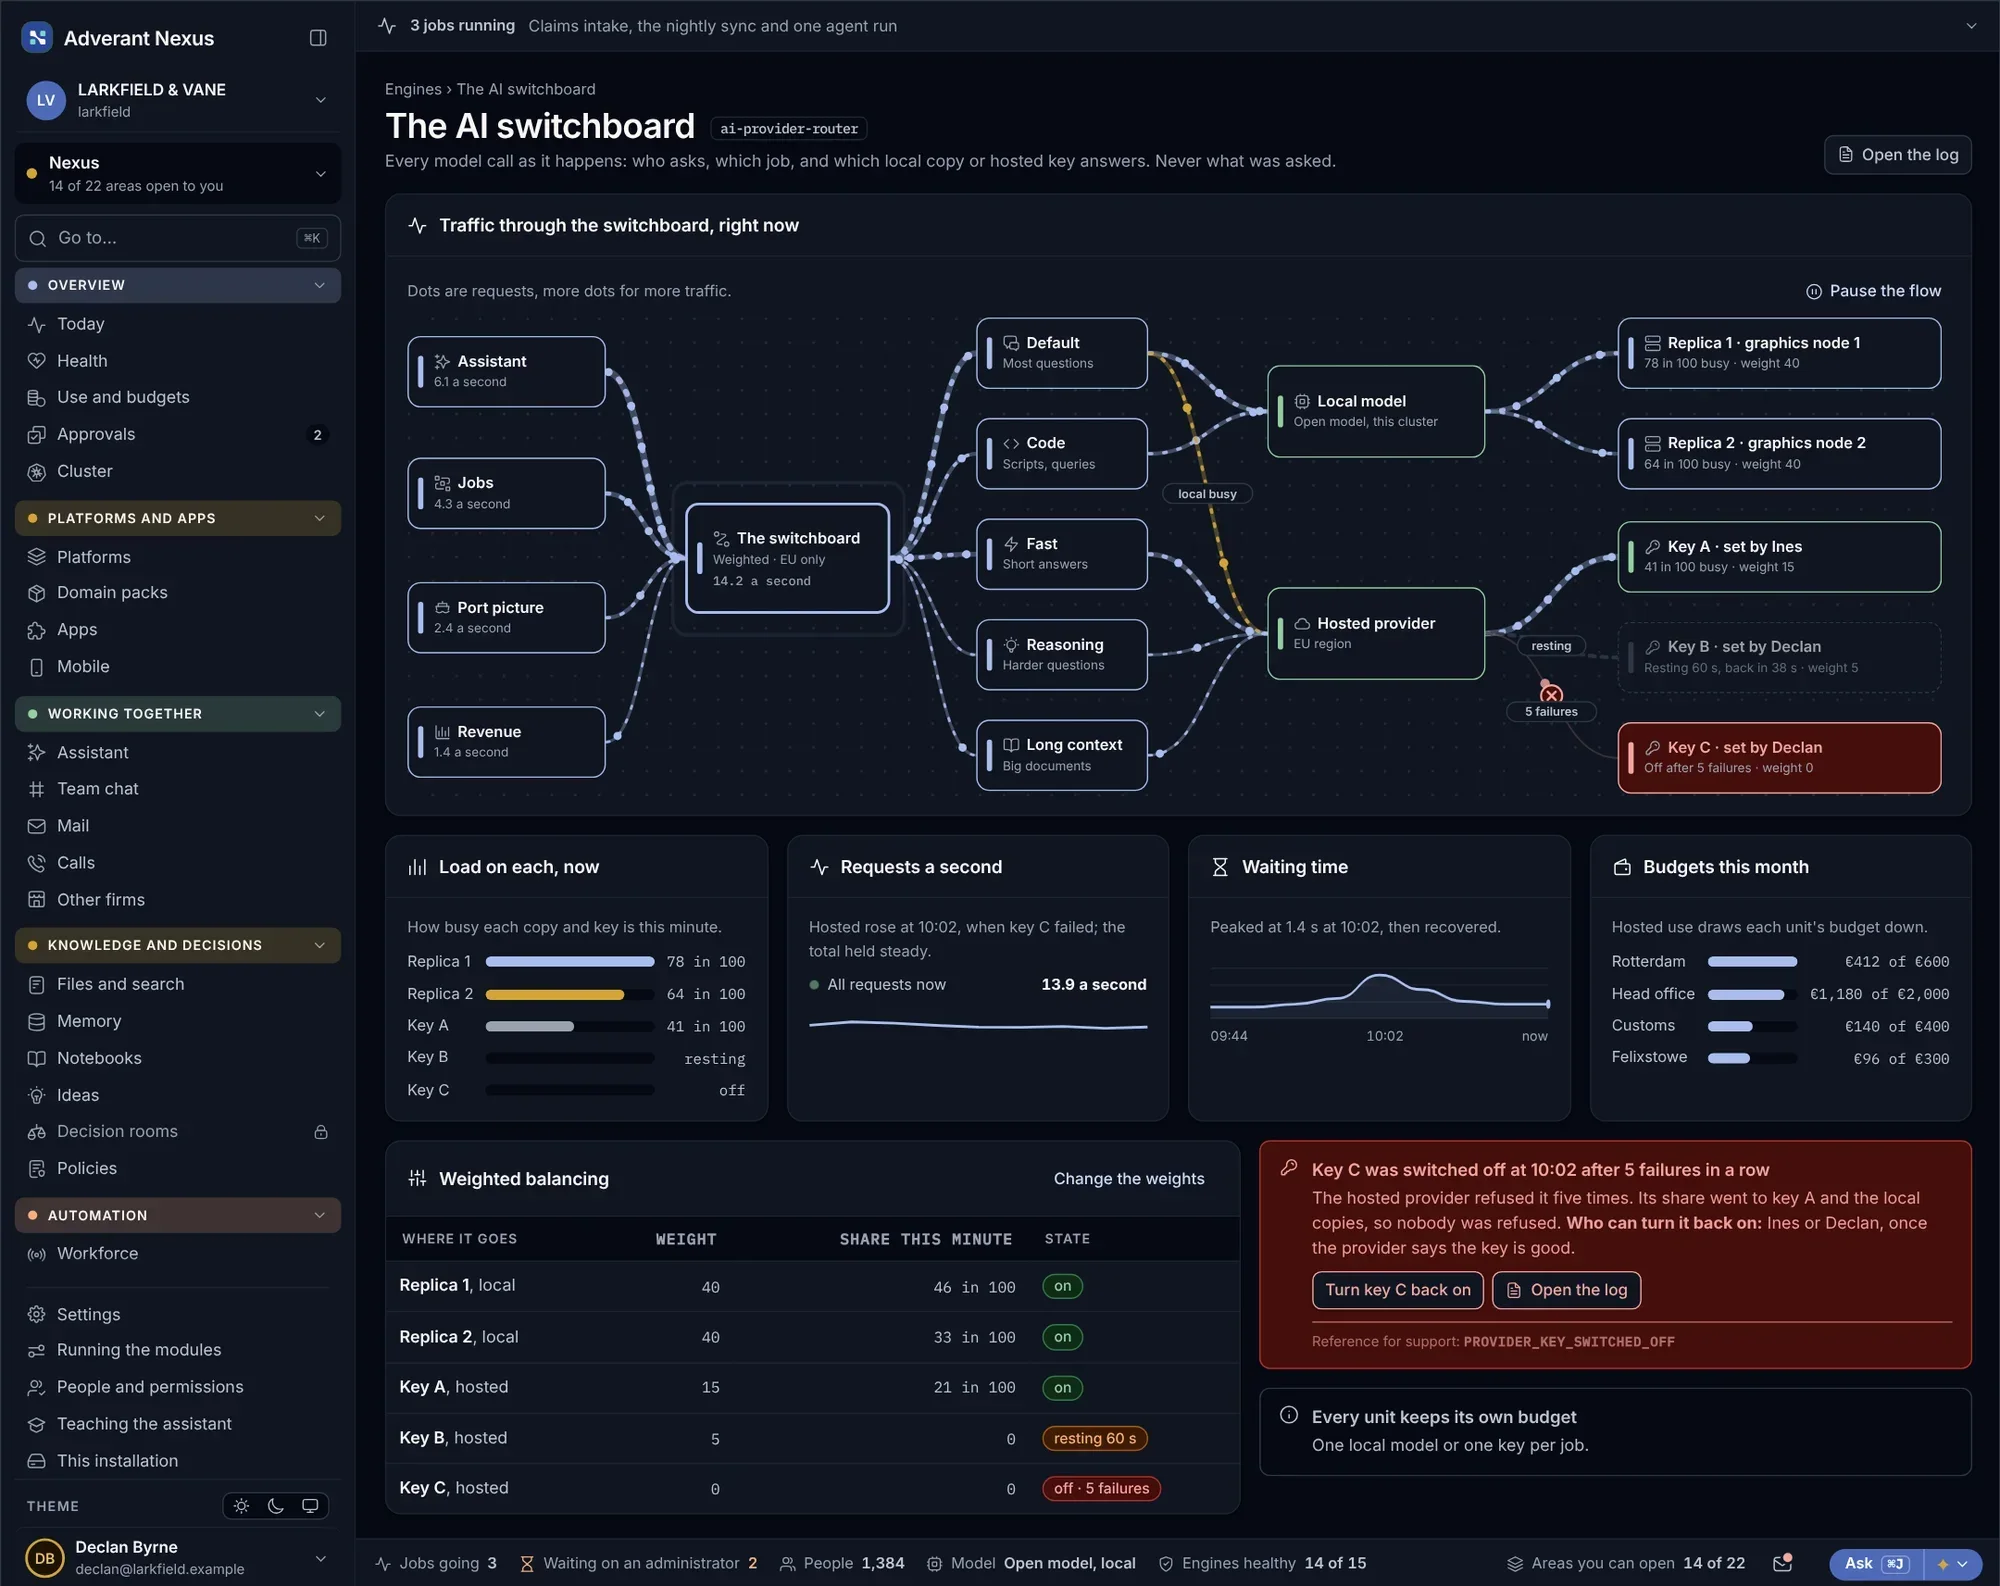
Le vostre regole decidono verso dove può uscire una chiamata.
Impostatele una volta per l'intera organizzazione, poi restringetele per una singola unità o piattaforma. Un'unità di difesa può essere vincolata ai modelli sul proprio hardware, mentre il team di marketing utilizza un modello in hosting nell'UE.
- Prima i vostri modelli sulle vostre GPU
- Modelli in hosting approvati, per area geografica
- Per unità, per piattaforma e per tipo di dati
- Ogni chiamata rifiutata messa a registro
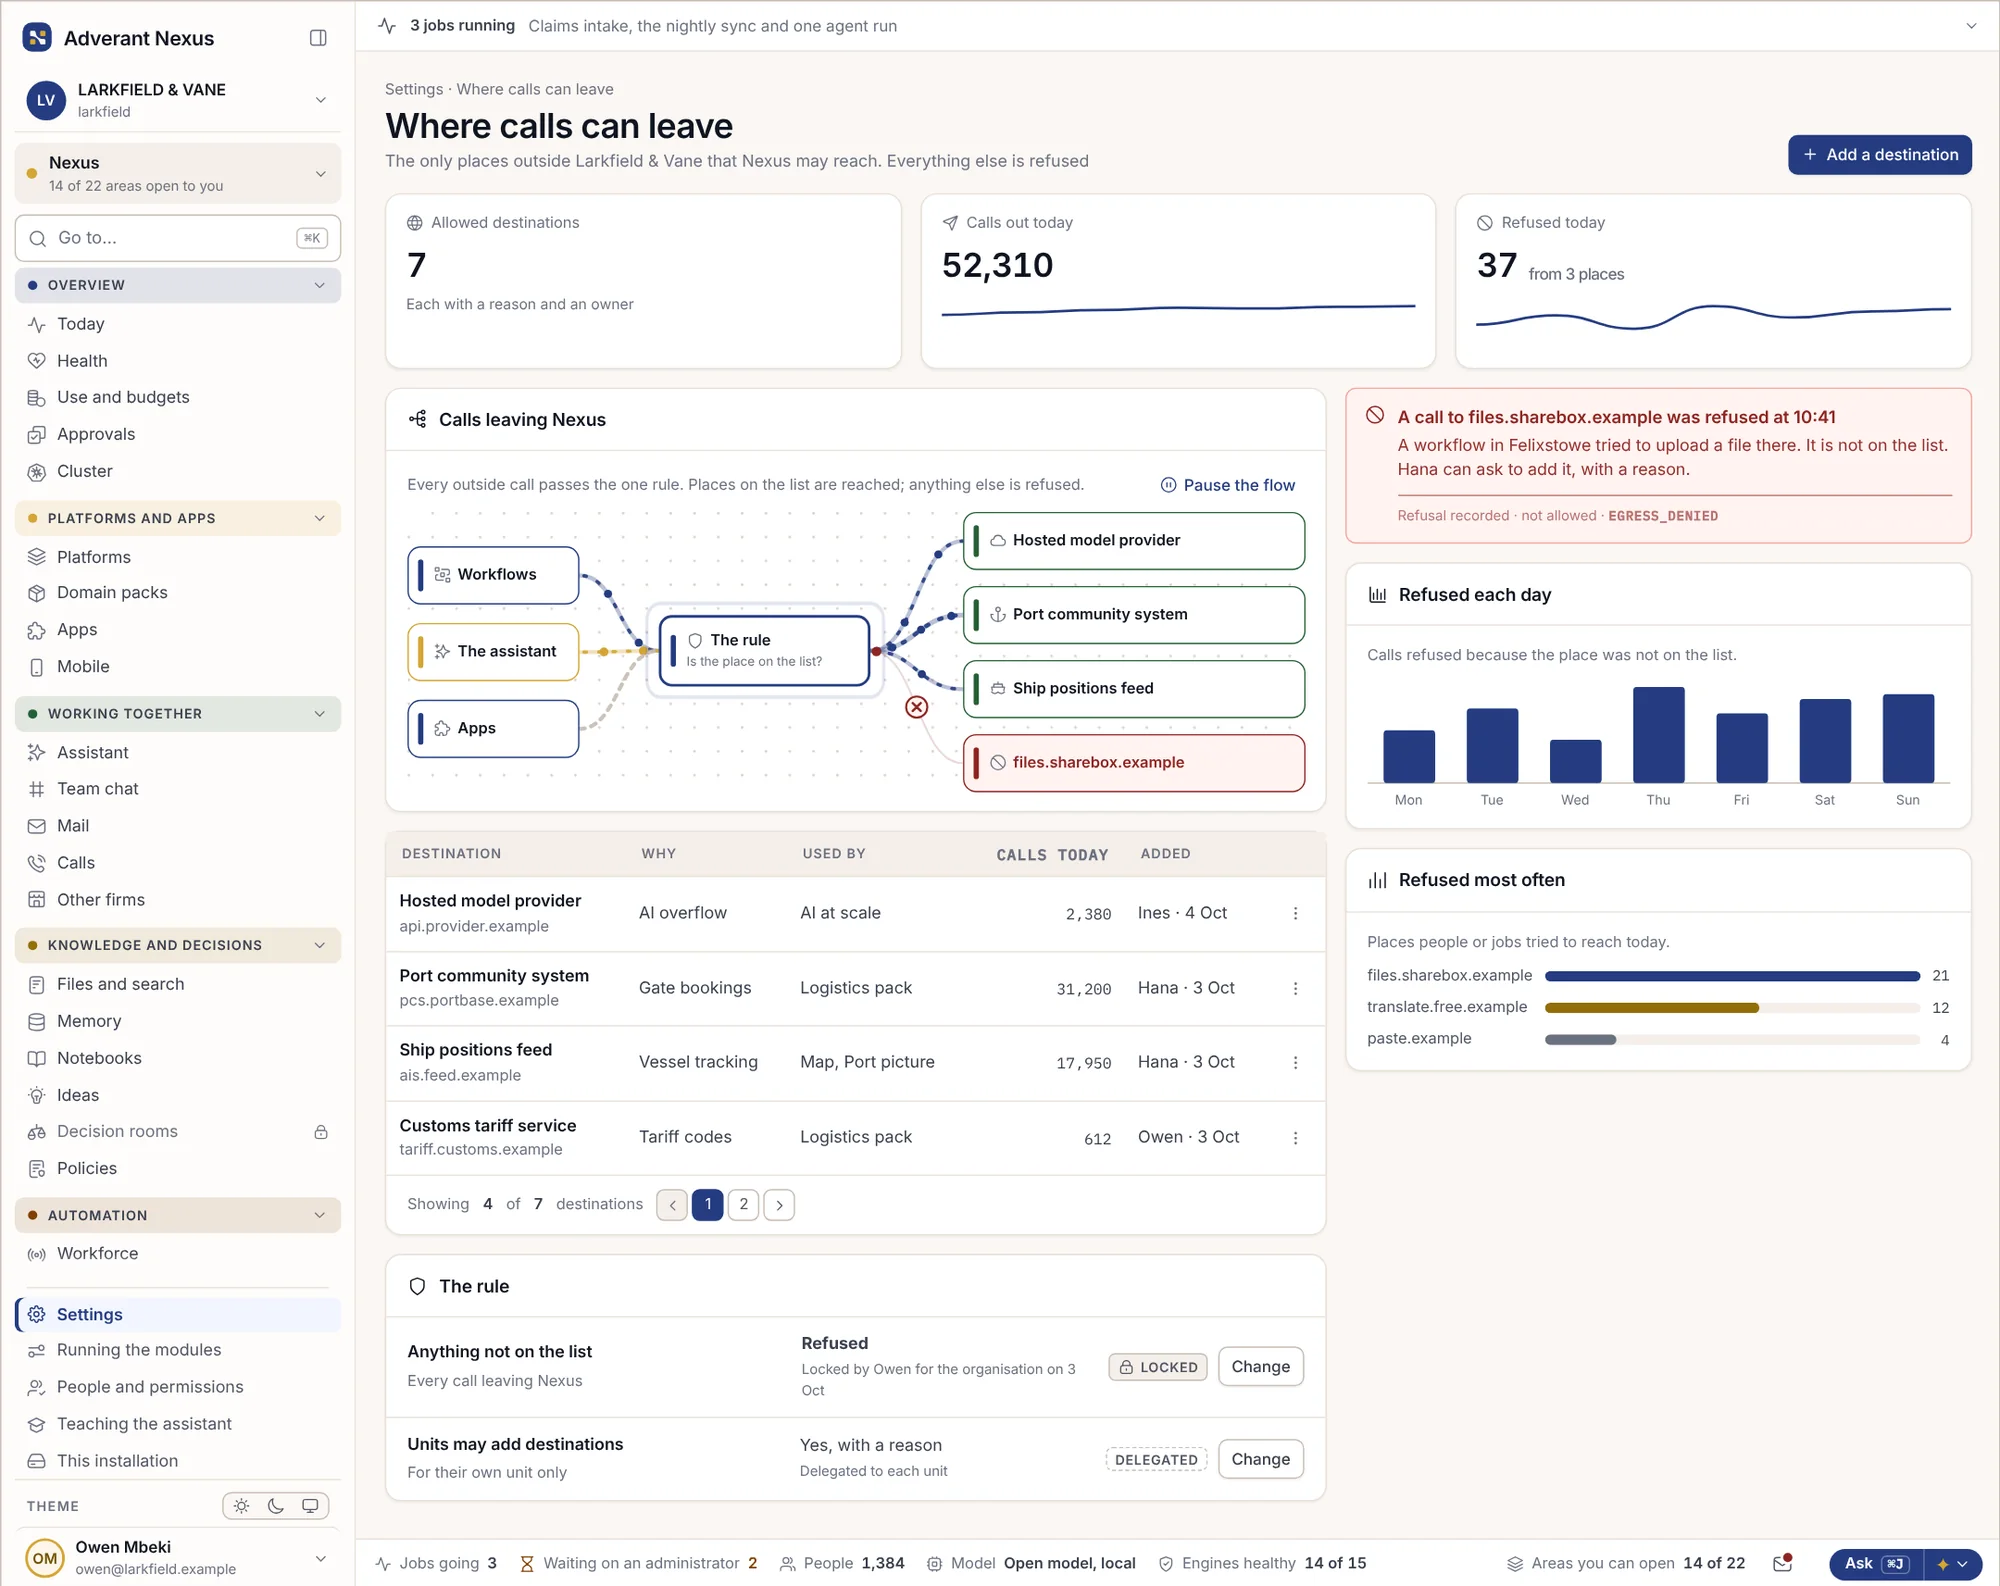
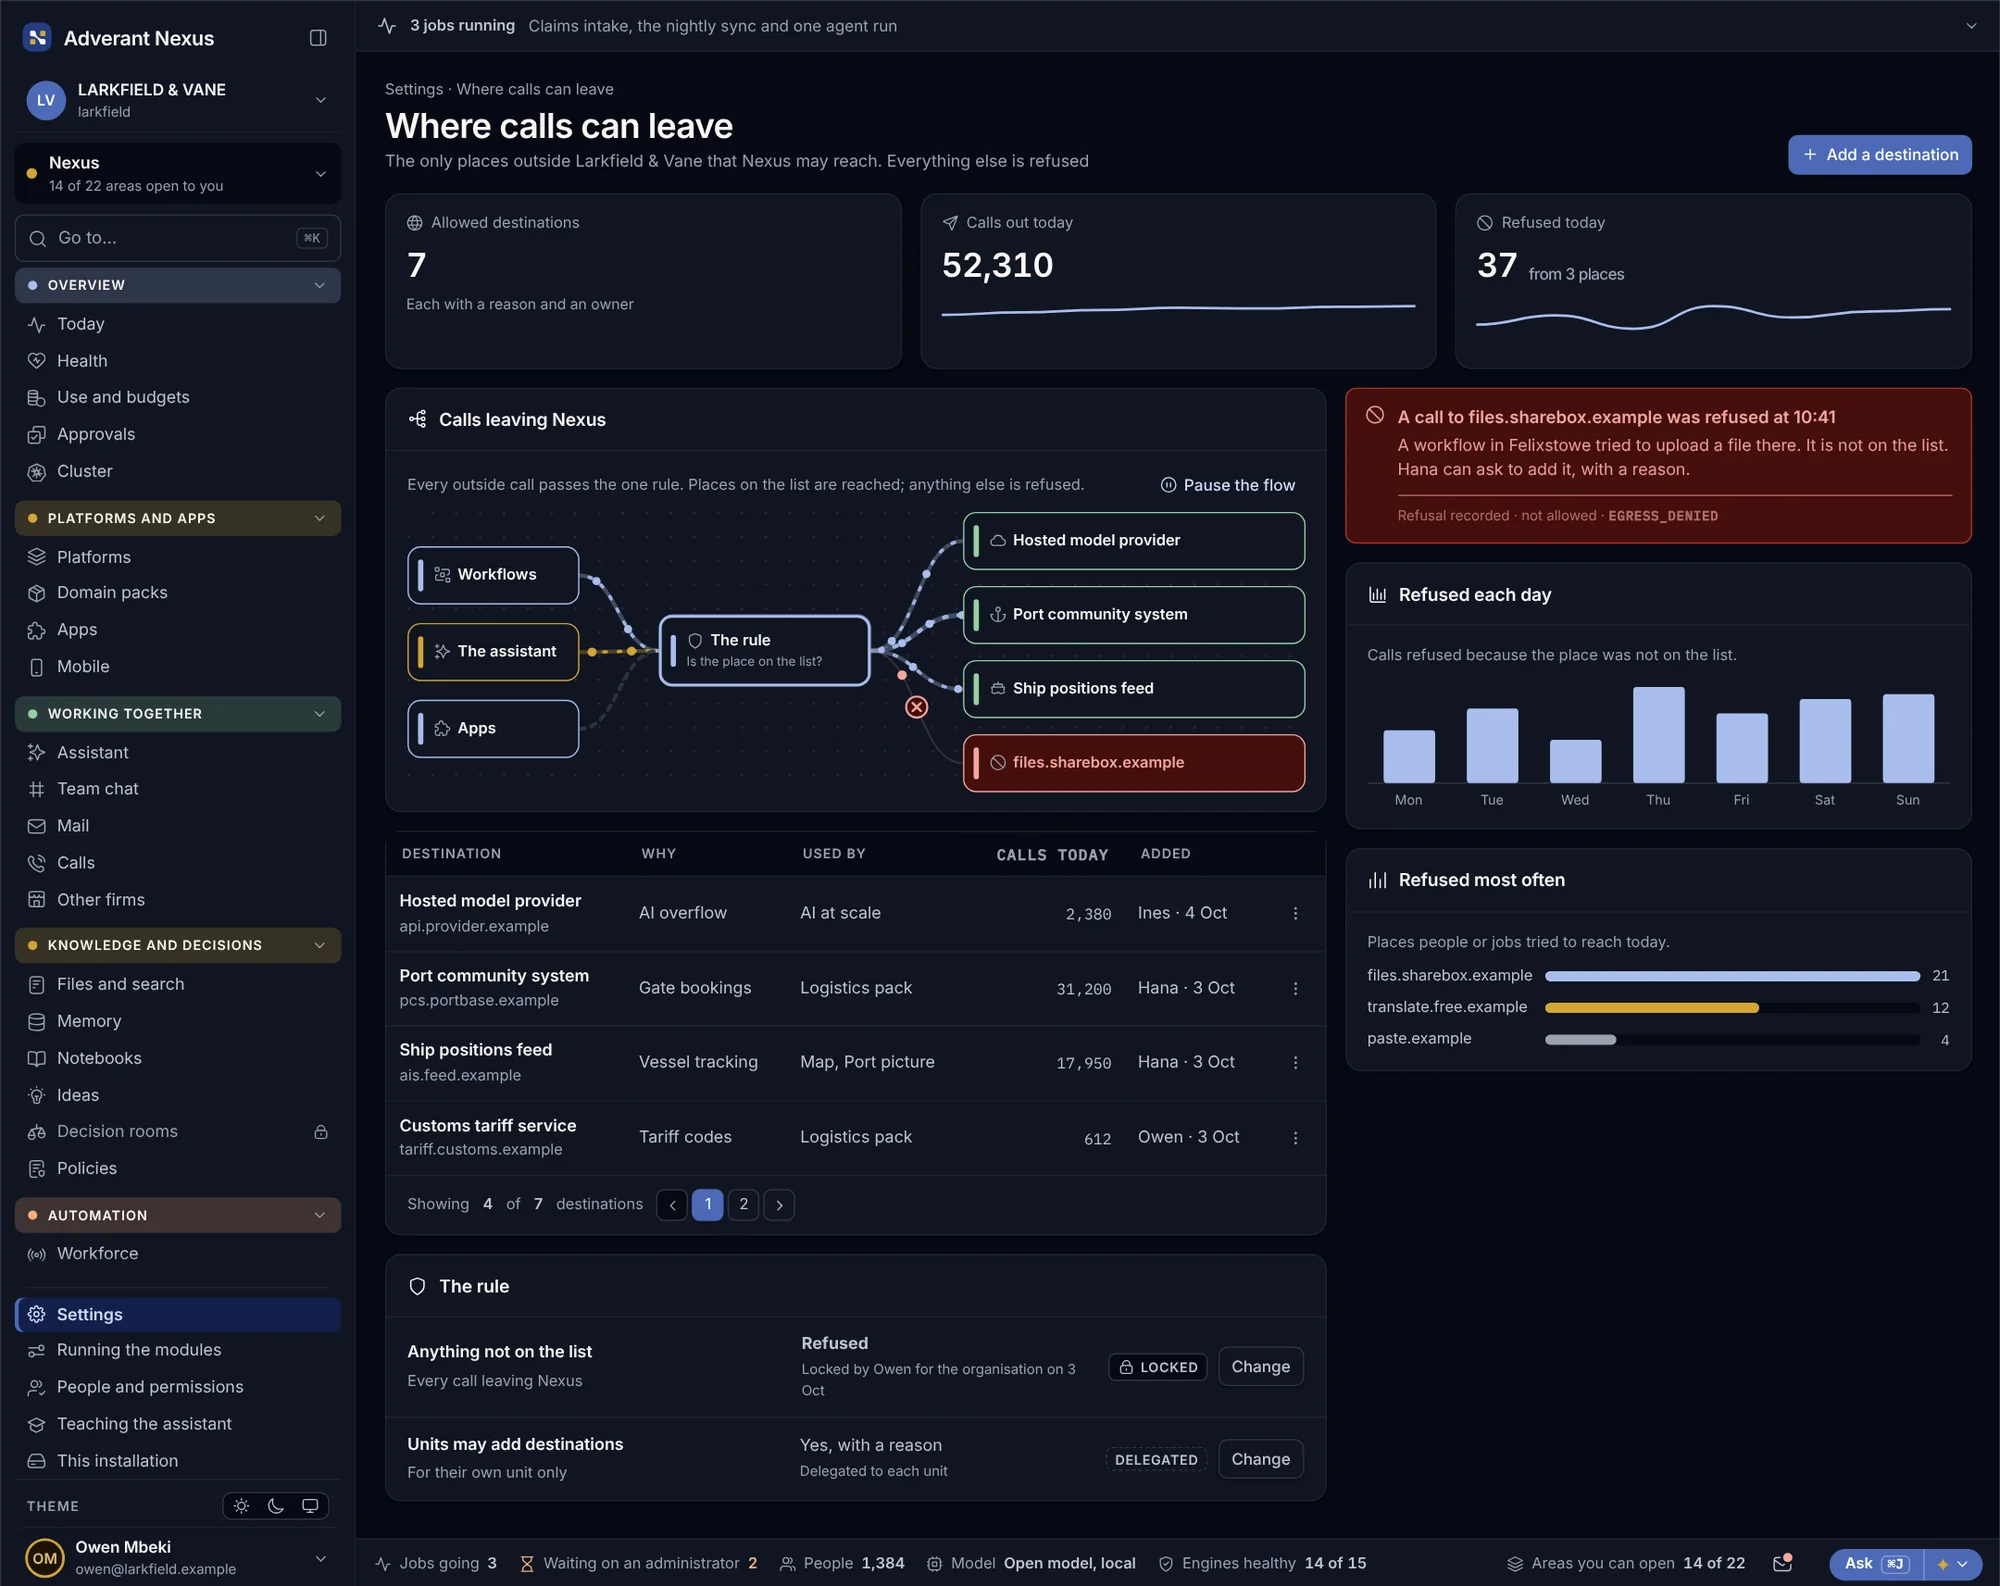
Ogni chiamata viene conteggiata su un budget con un responsabile.
L'utilizzo è conteggiato per persona, team, applicazione e giorno. Ogni budget ha un titolare nominativo e un limite, e l'amministrazione riceve un'unica fattura. Conteggiamo l'utilizzo. Non leggiamo mai i contenuti.
- Budget
Per unità e per applicazione, con un avviso prima del limite e un responsabile autorizzato a innalzarlo.
- Un'unica fattura
Ogni modello, in hosting o vostro, in un unico rendiconto chiaro per l'amministrazione.
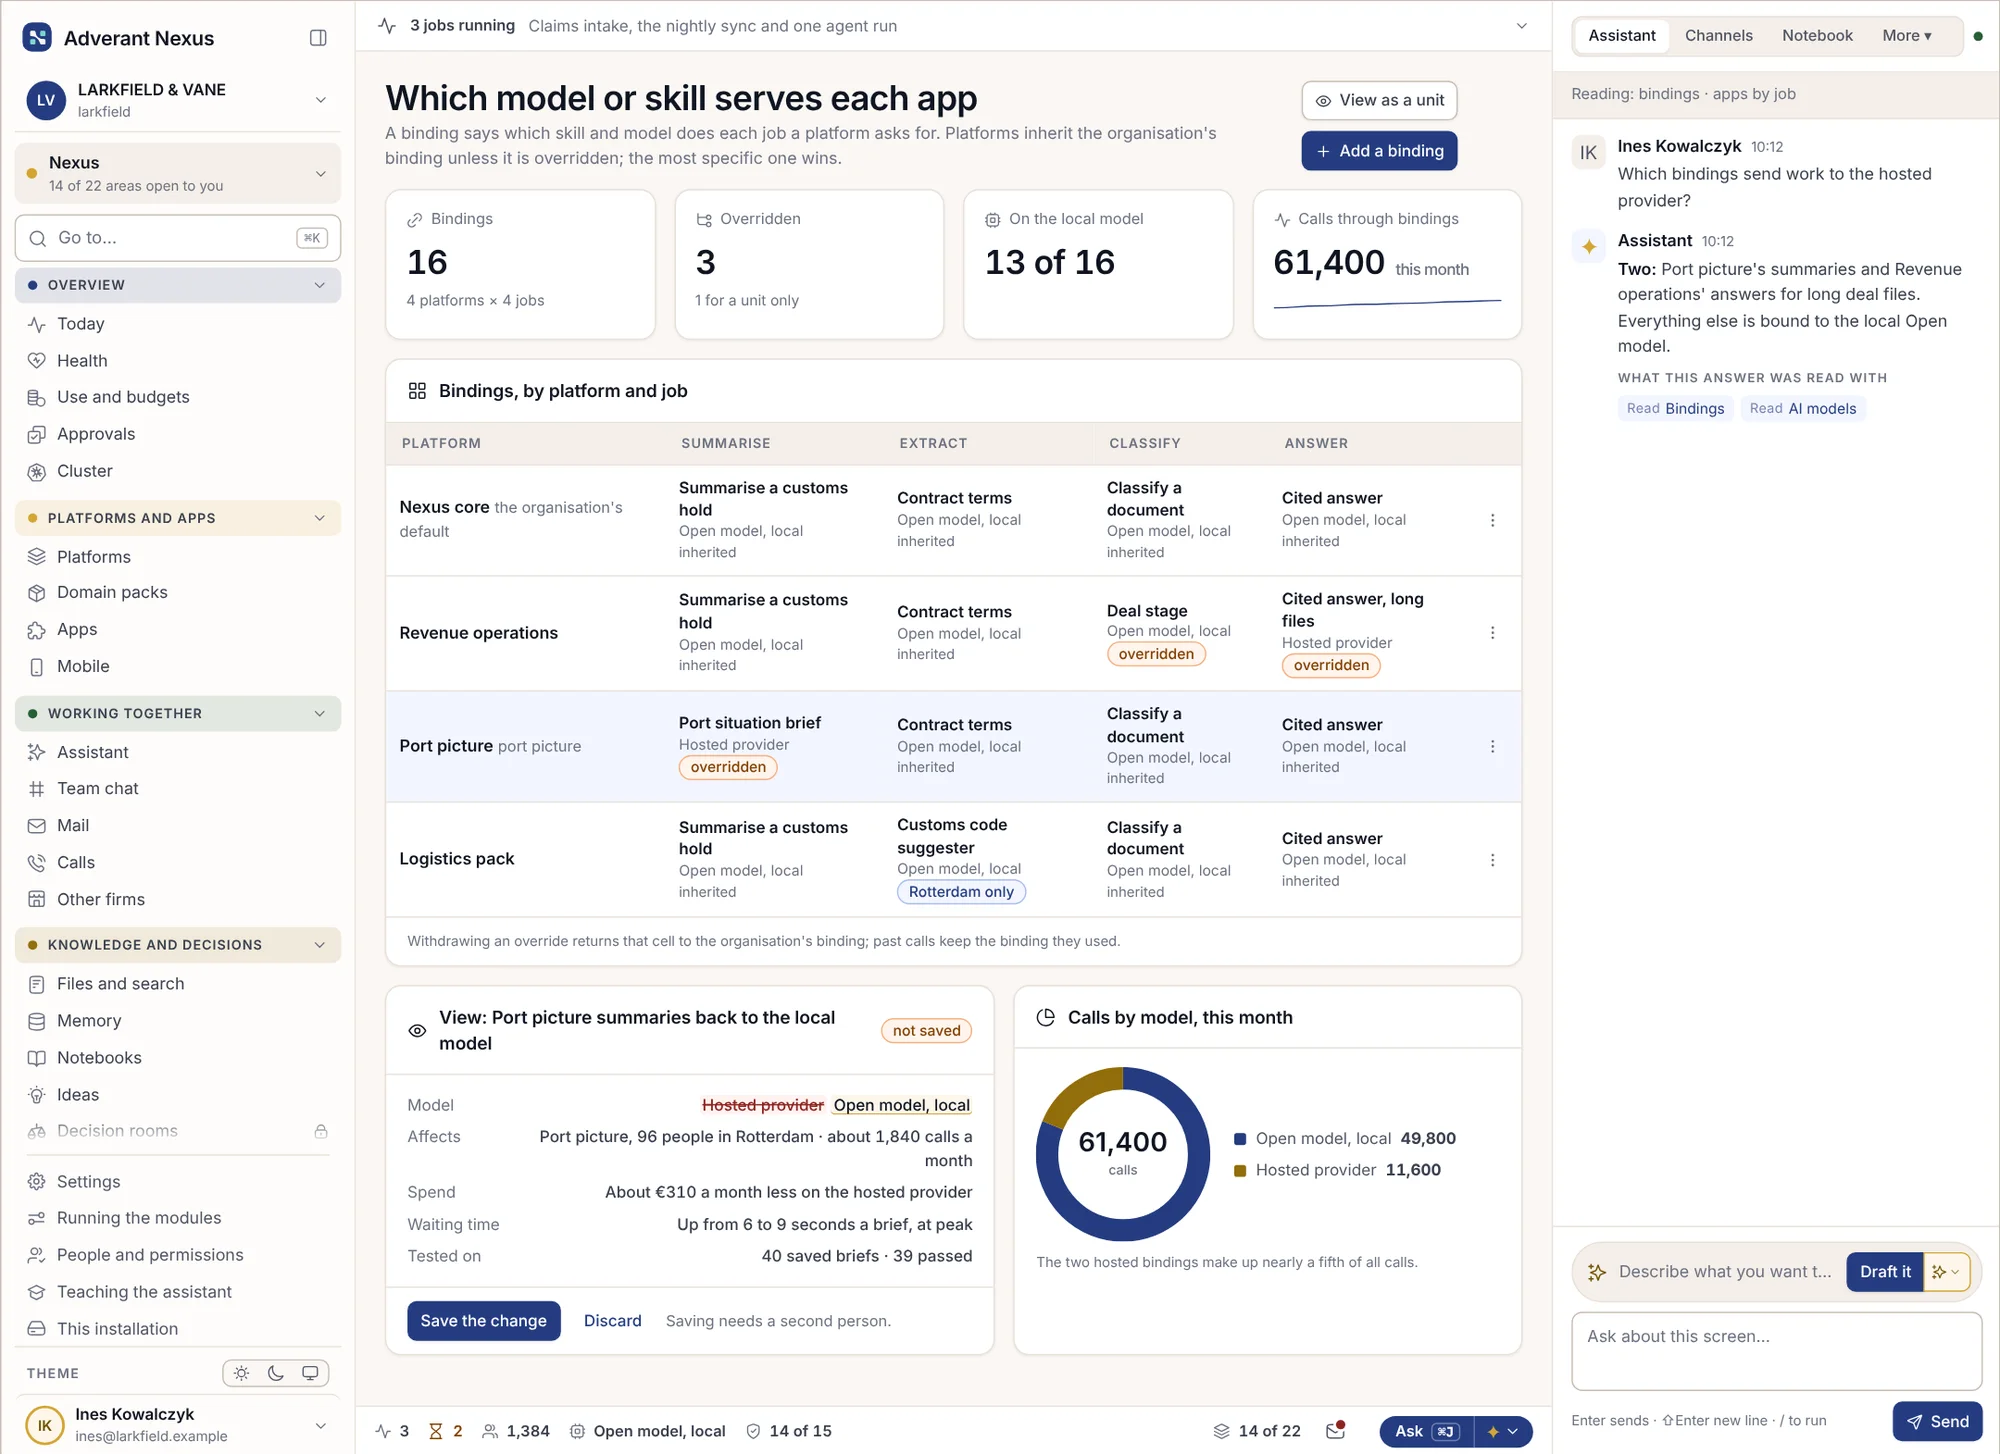
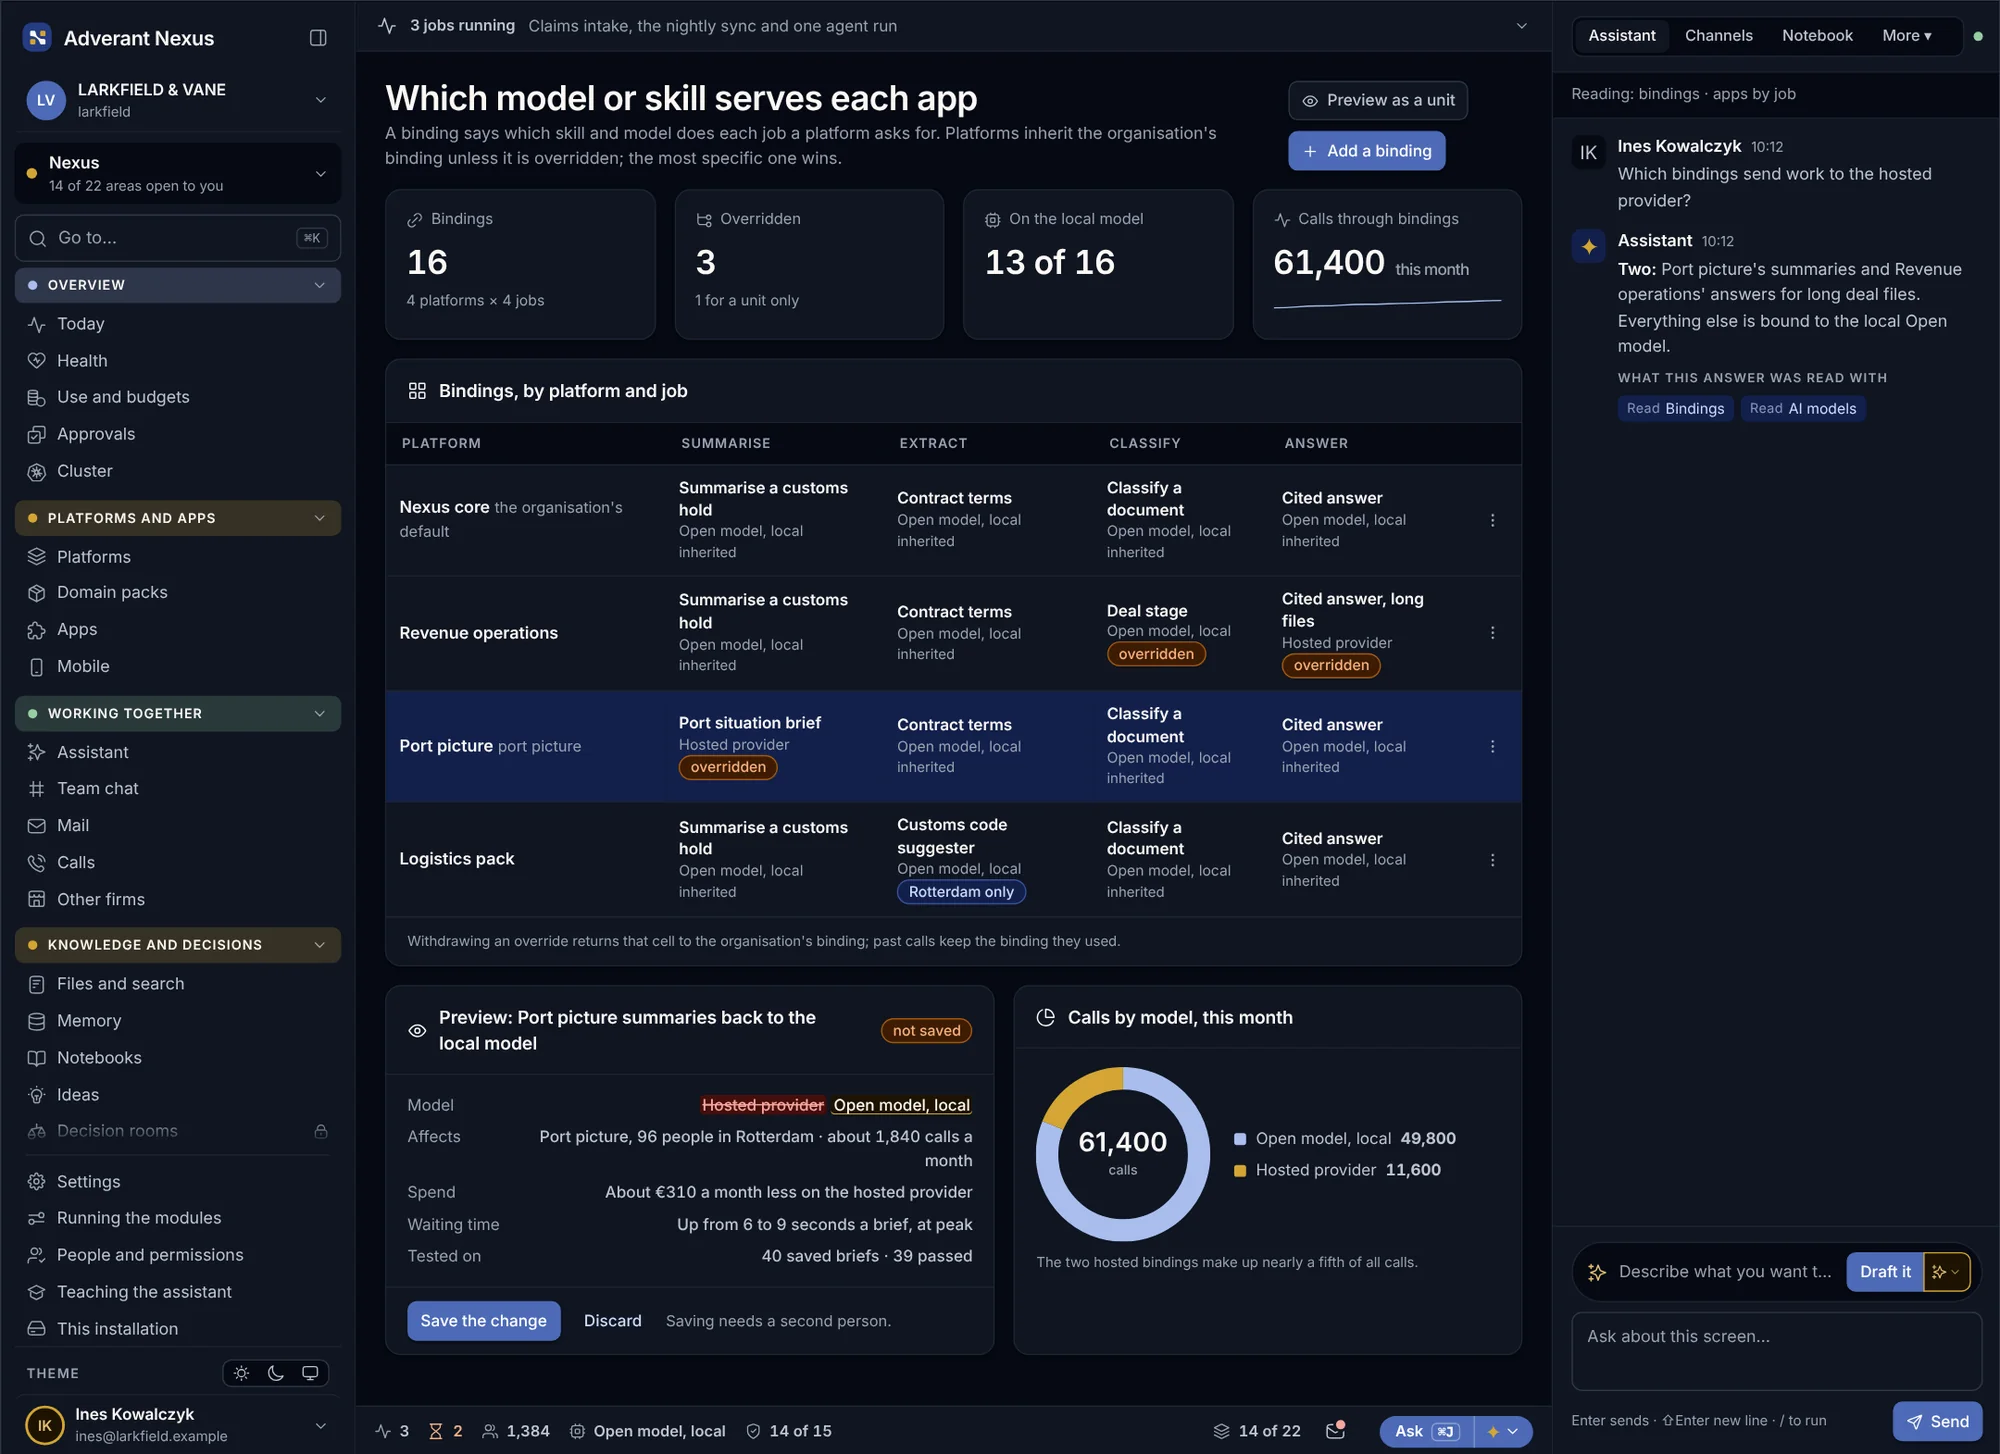
- Quale modello serve cosa
Vedete quale modello o competenza risponde a ciascuna applicazione e modificatelo da un unico posto.
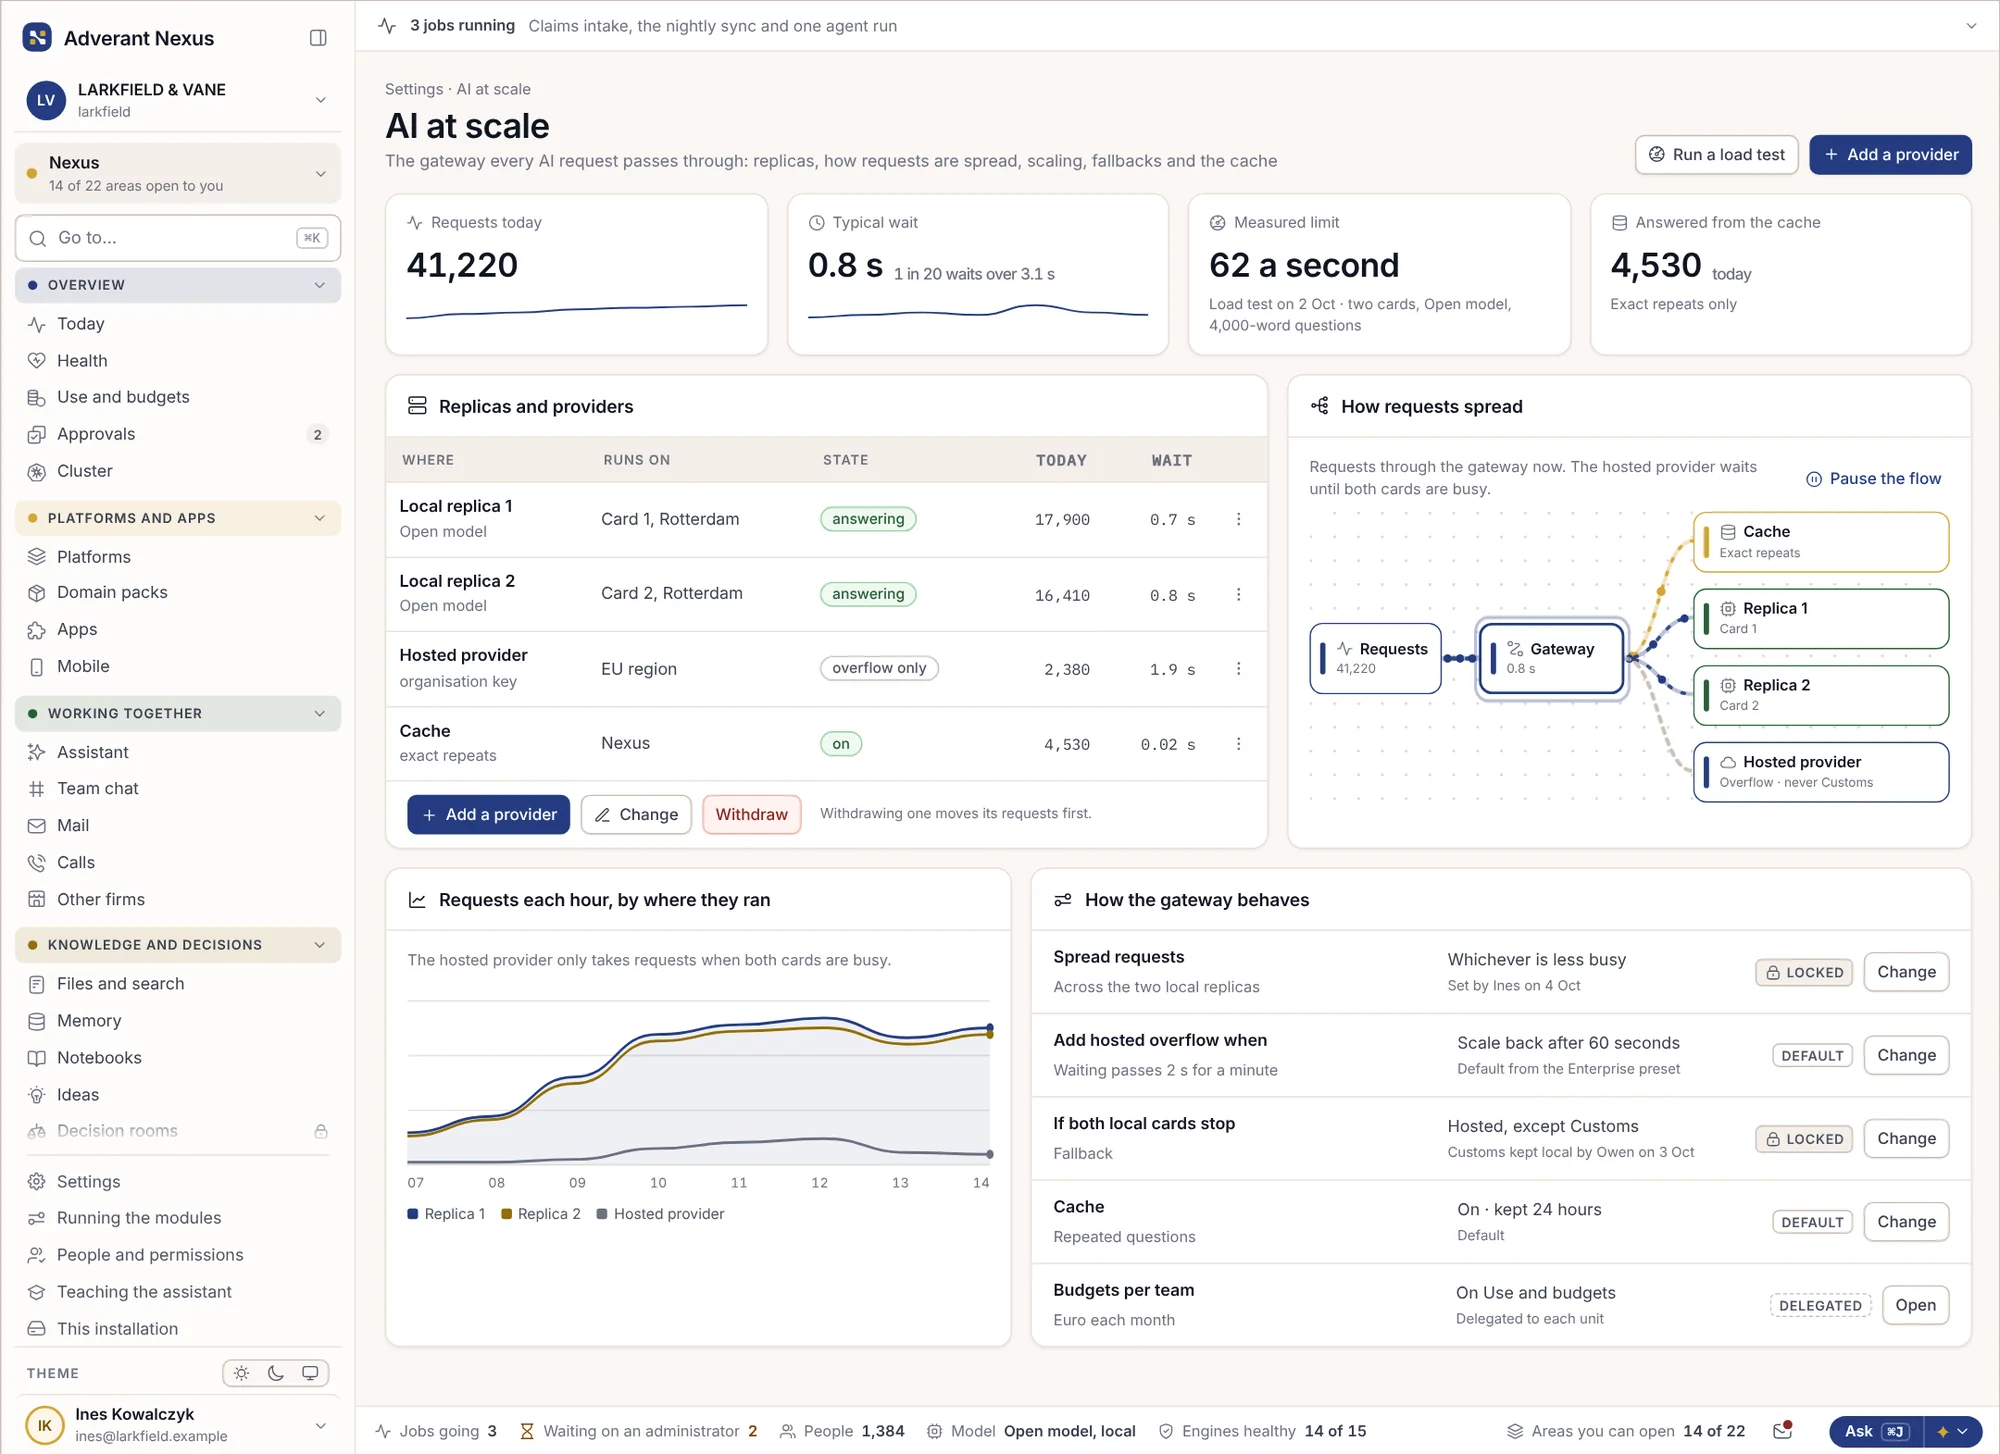
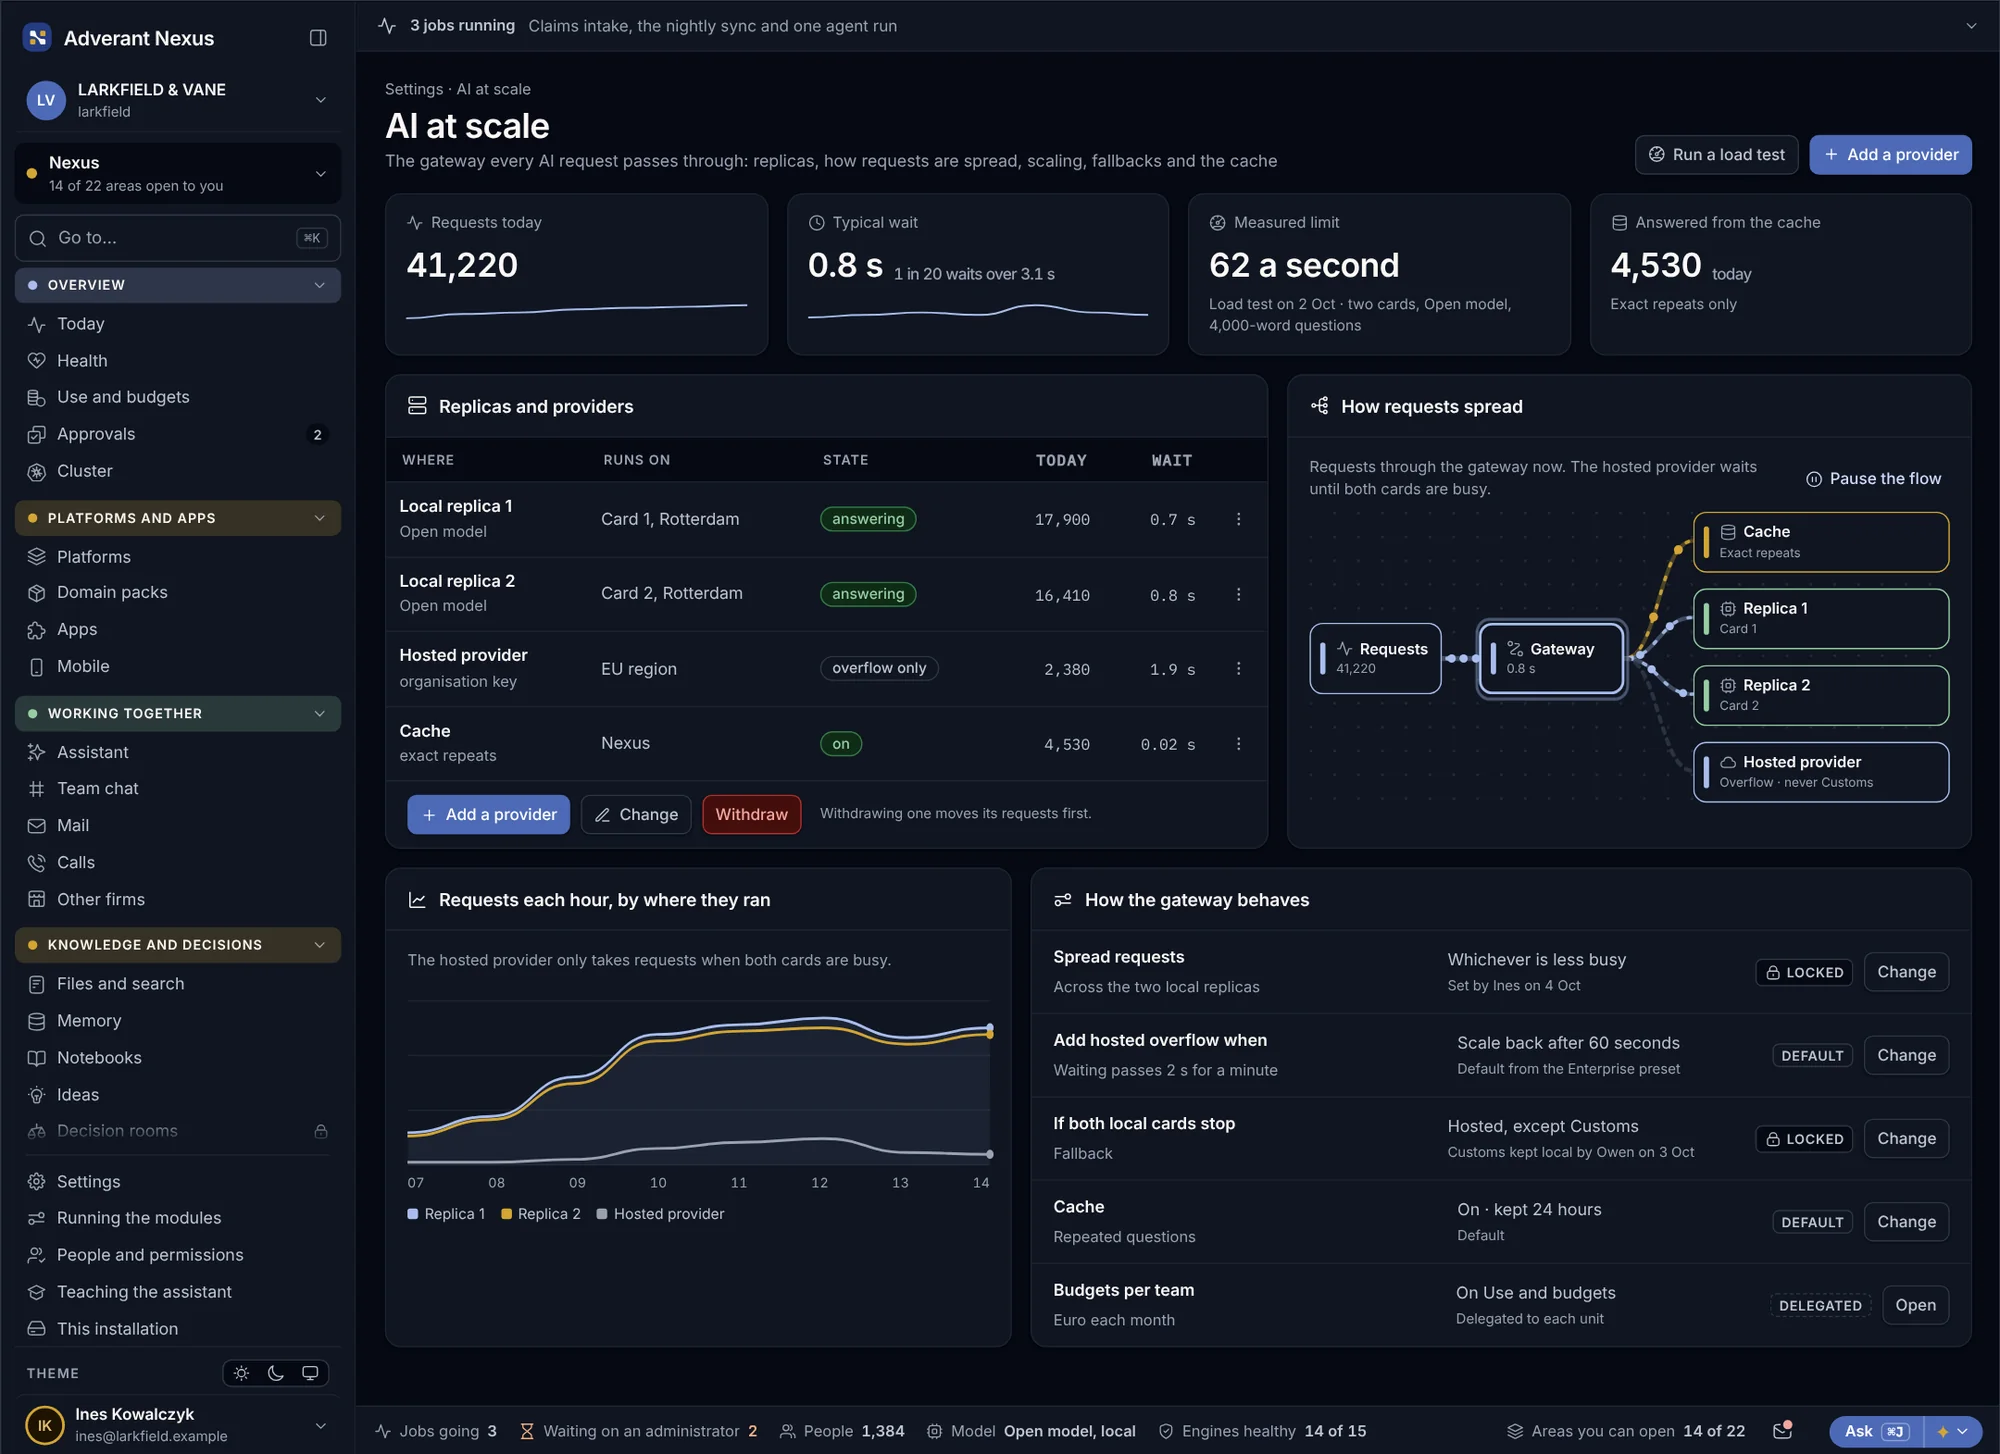
Da un solo team a ogni unità.
Quando l'utilizzo cresce, il centralino distribuisce le chiamate su più copie dei vostri modelli, mette in cache ciò che è possibile e garantisce una quota equa a ciascuna unità, così un team molto attivo non può rallentare tutti gli altri.
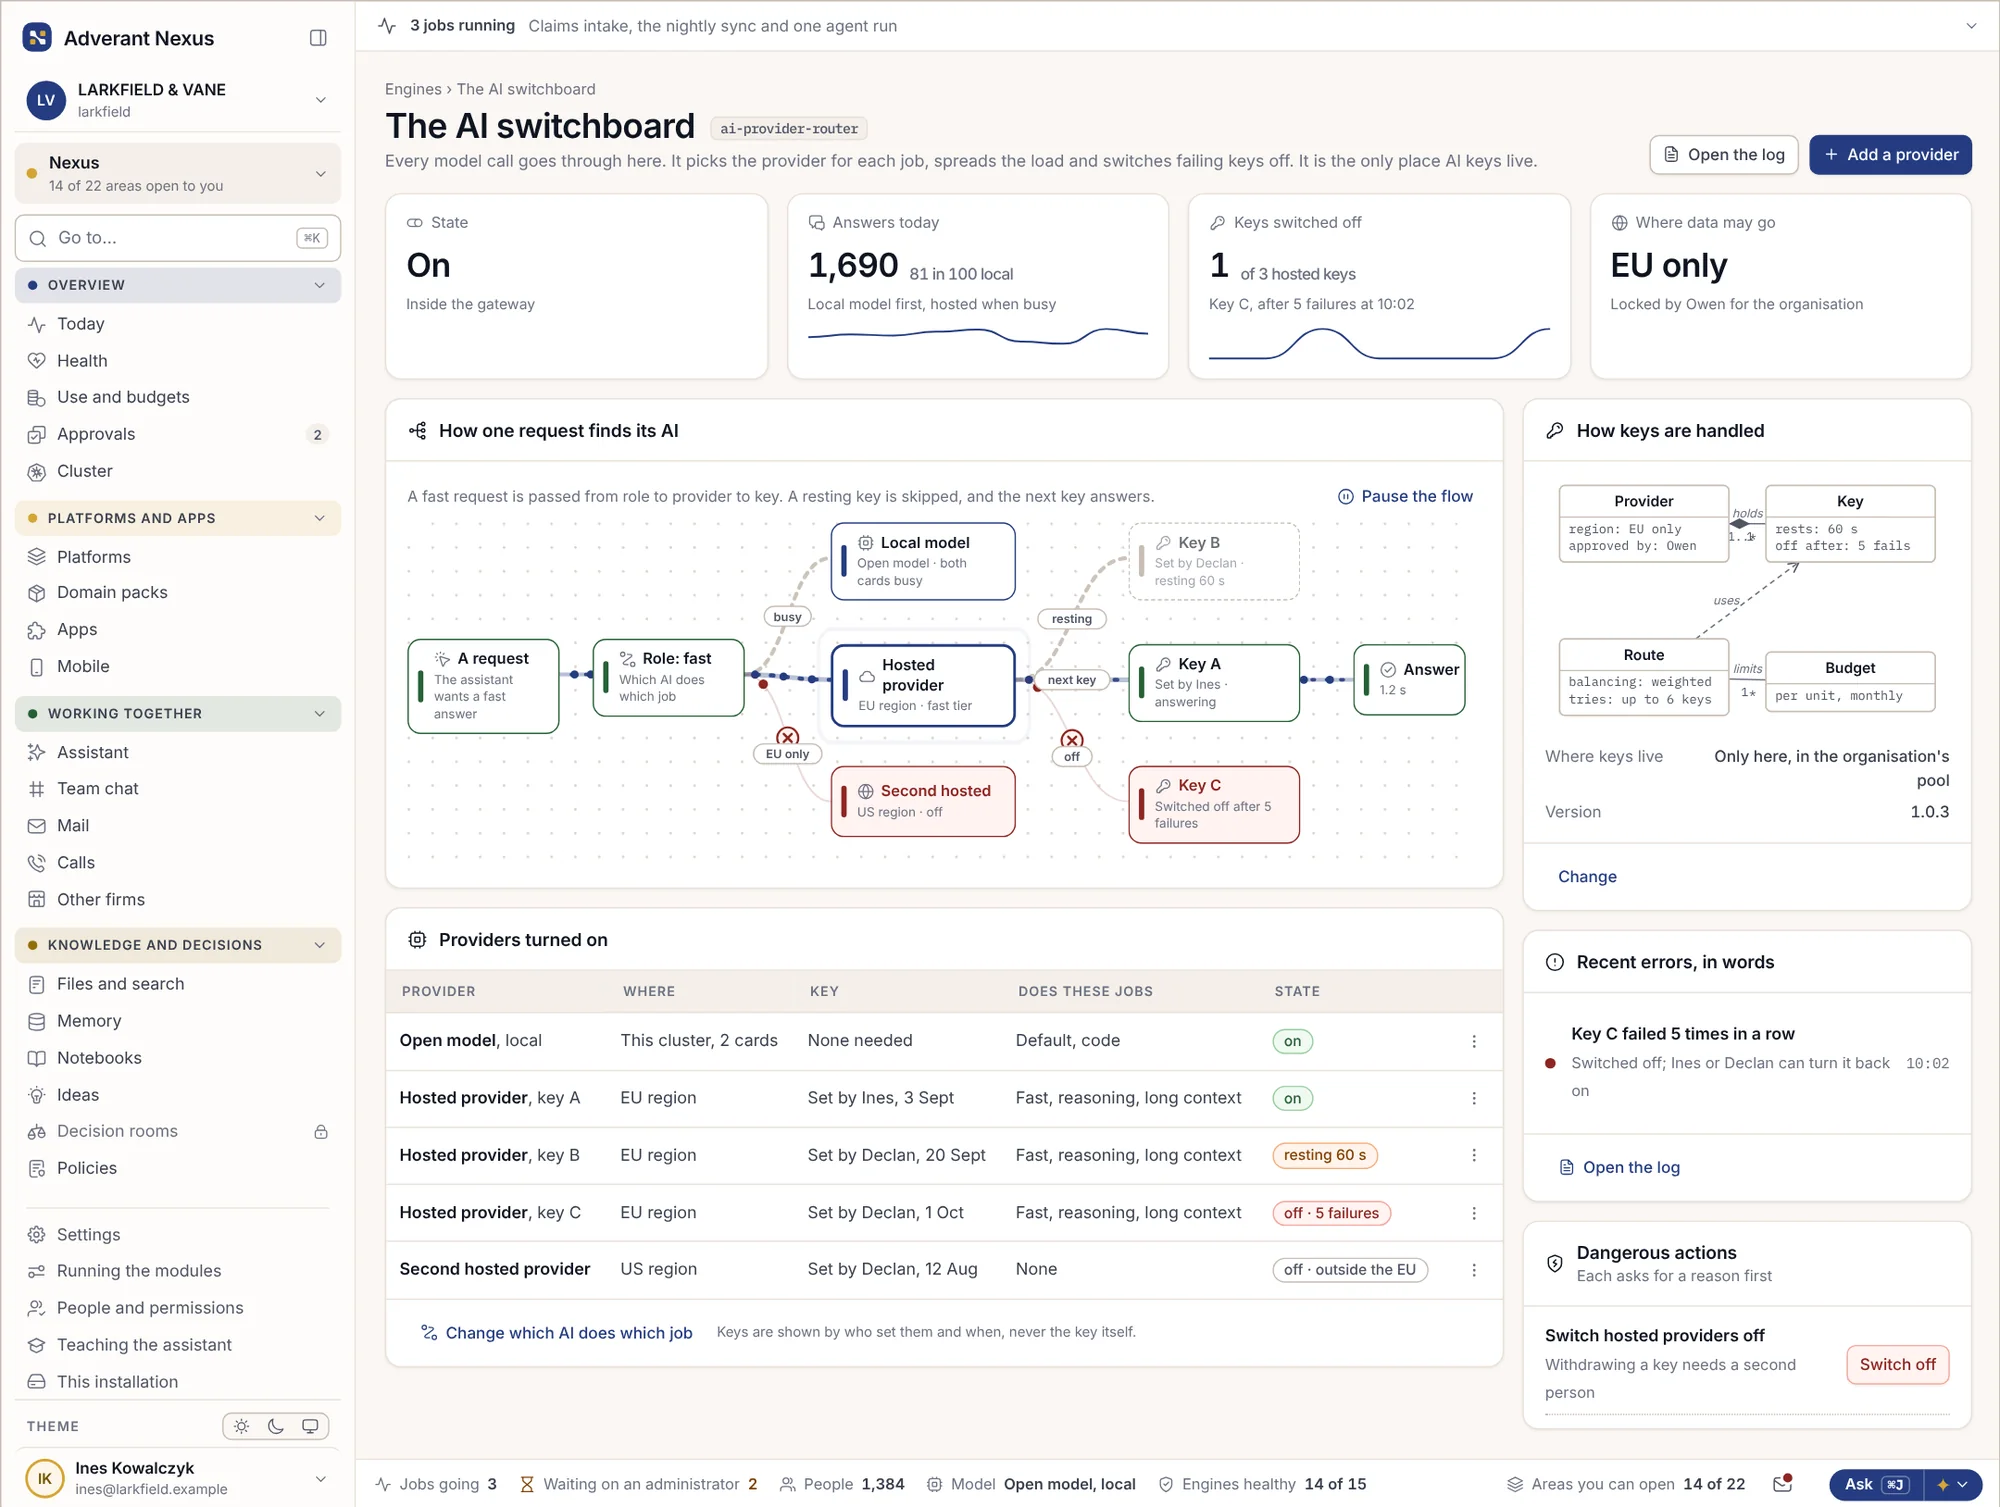
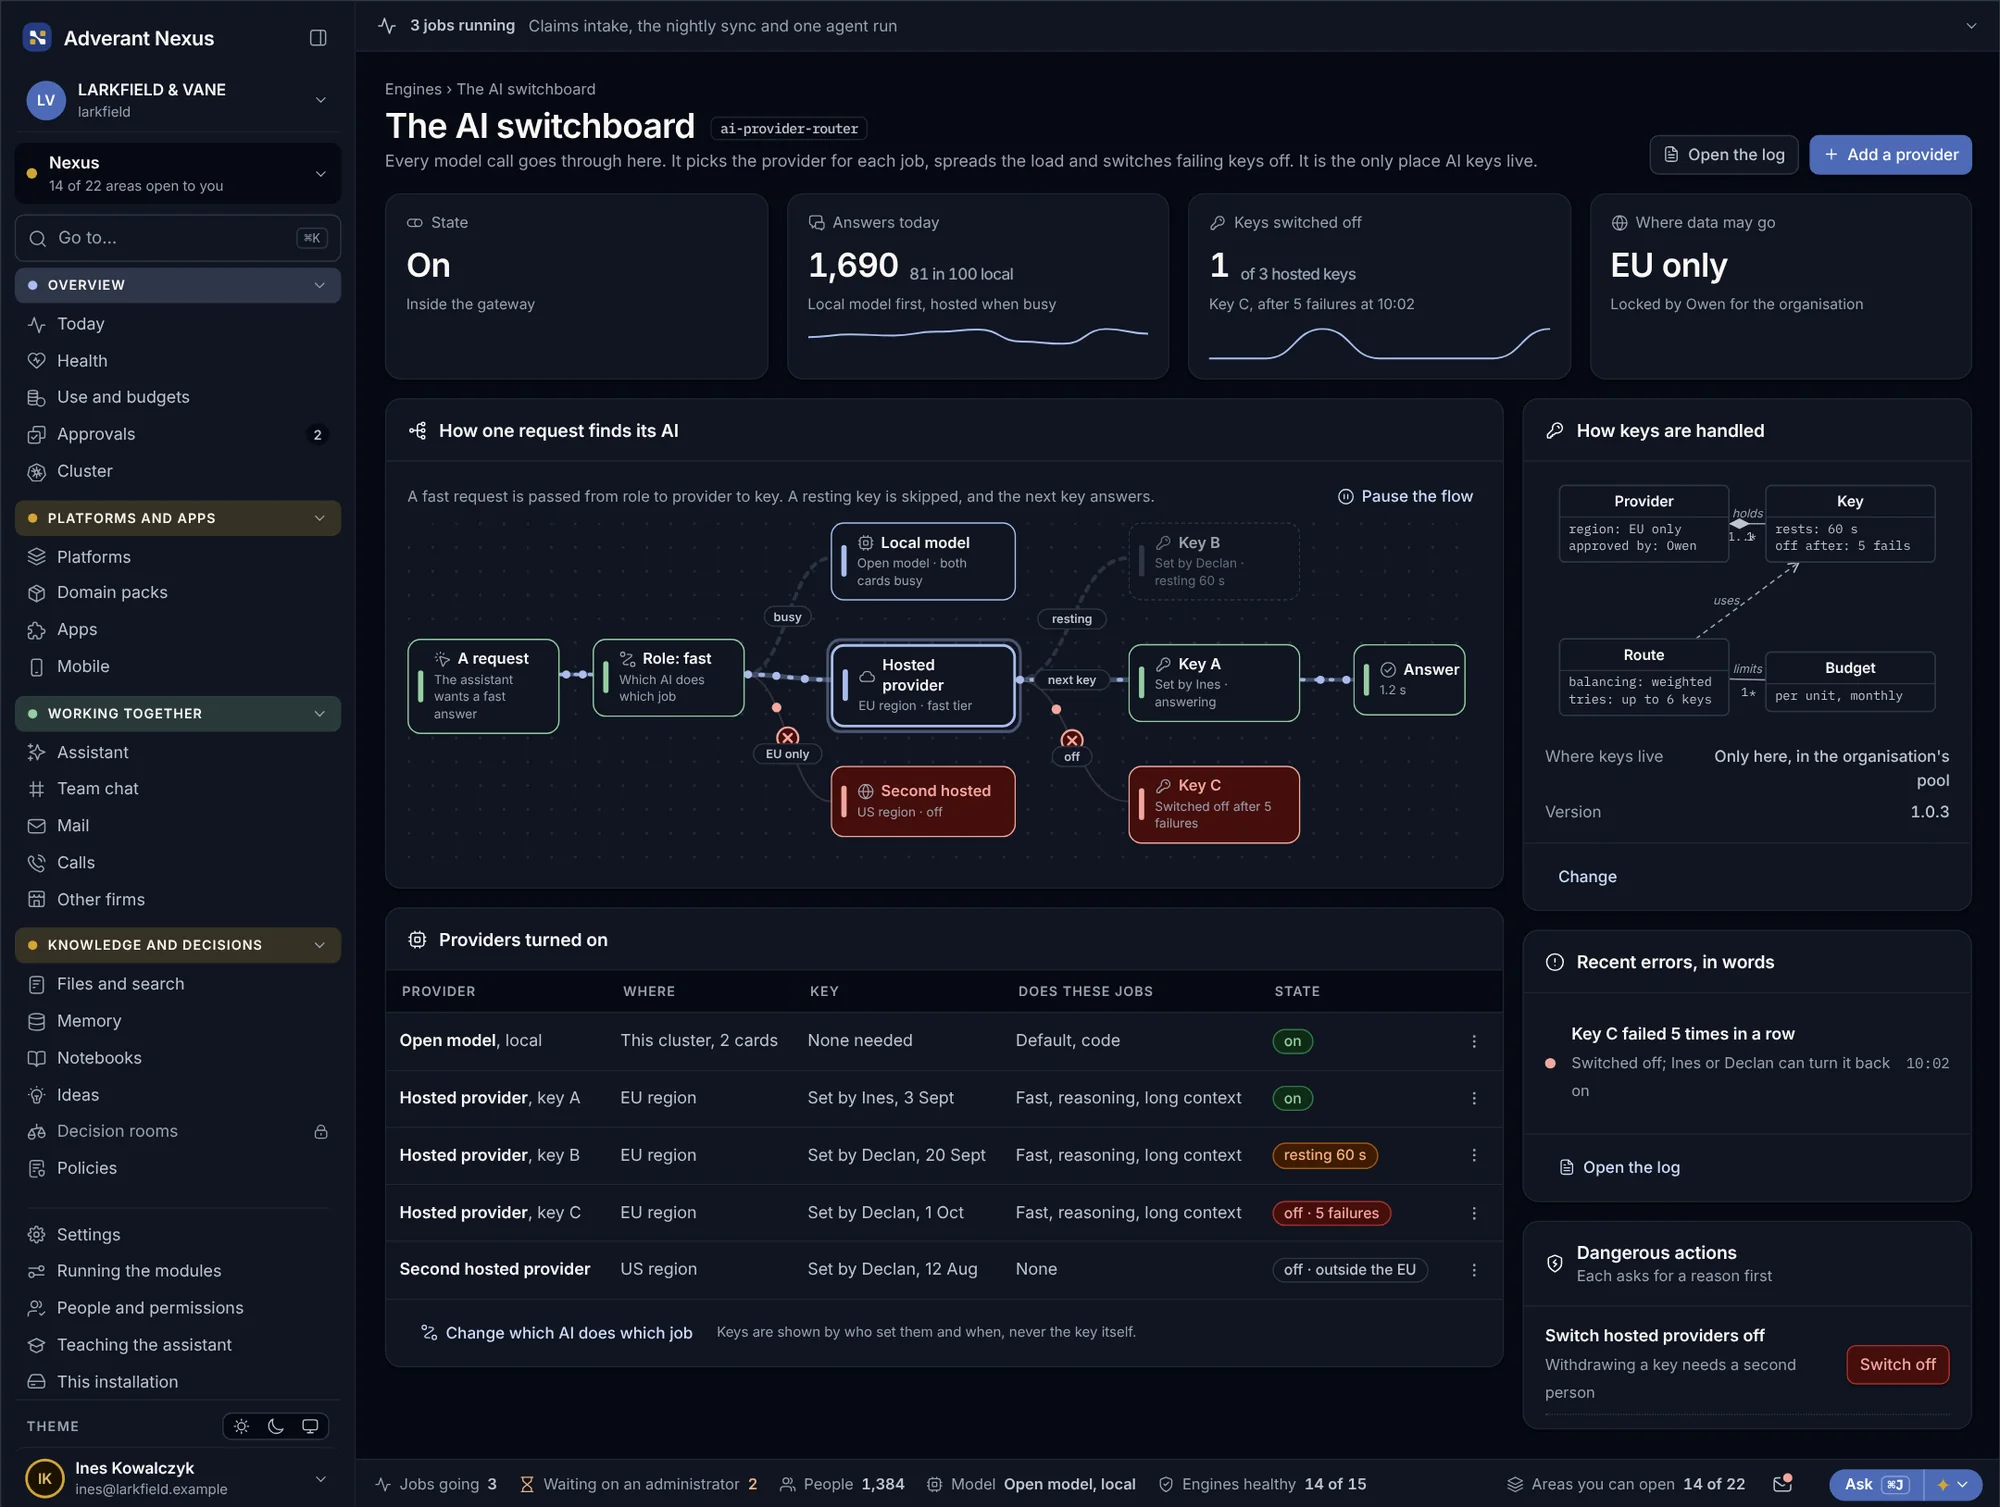
Domande frequenti sul centralino.
Possiamo usare i nostri modelli?
Sì. Collegate i modelli in esecuzione sul vostro hardware o nel vostro account cloud. Il centralino li tratta come qualsiasi altro modello e potete renderli obbligatori per determinate categorie di dati.
Adverant vede cosa chiedono le nostre persone?
No. Il centralino conteggia le chiamate e ne misura tempi e costi. Non archivia né legge il contenuto di una domanda o di una risposta.
Cosa succede quando un fornitore non è disponibile?
Il modello successivo consentito prende in carico la chiamata. Se nessun modello consentito è disponibile, la chiamata resta in attesa o viene interrotta indicando un motivo chiaro. Non viene mai inviata dove le vostre regole lo vietano.
Possiamo impostare regole diverse per ciascuna unità?
Sì. Le regole partono a livello di organizzazione e possono essere ristrette per ciascuna unità, piattaforma e tipo di dati. Un'unità non può mai avere regole meno restrittive rispetto all'organizzazione.
Approfondimenti
Vedete i vostri modelli dietro un unico centralino.
Diteci quali modelli utilizzate oggi e dove devono restare i vostri dati. Vi mostreremo le regole di instradamento più adatte.