

Chaque appel de modèle, acheminé là où vous l’autorisez.
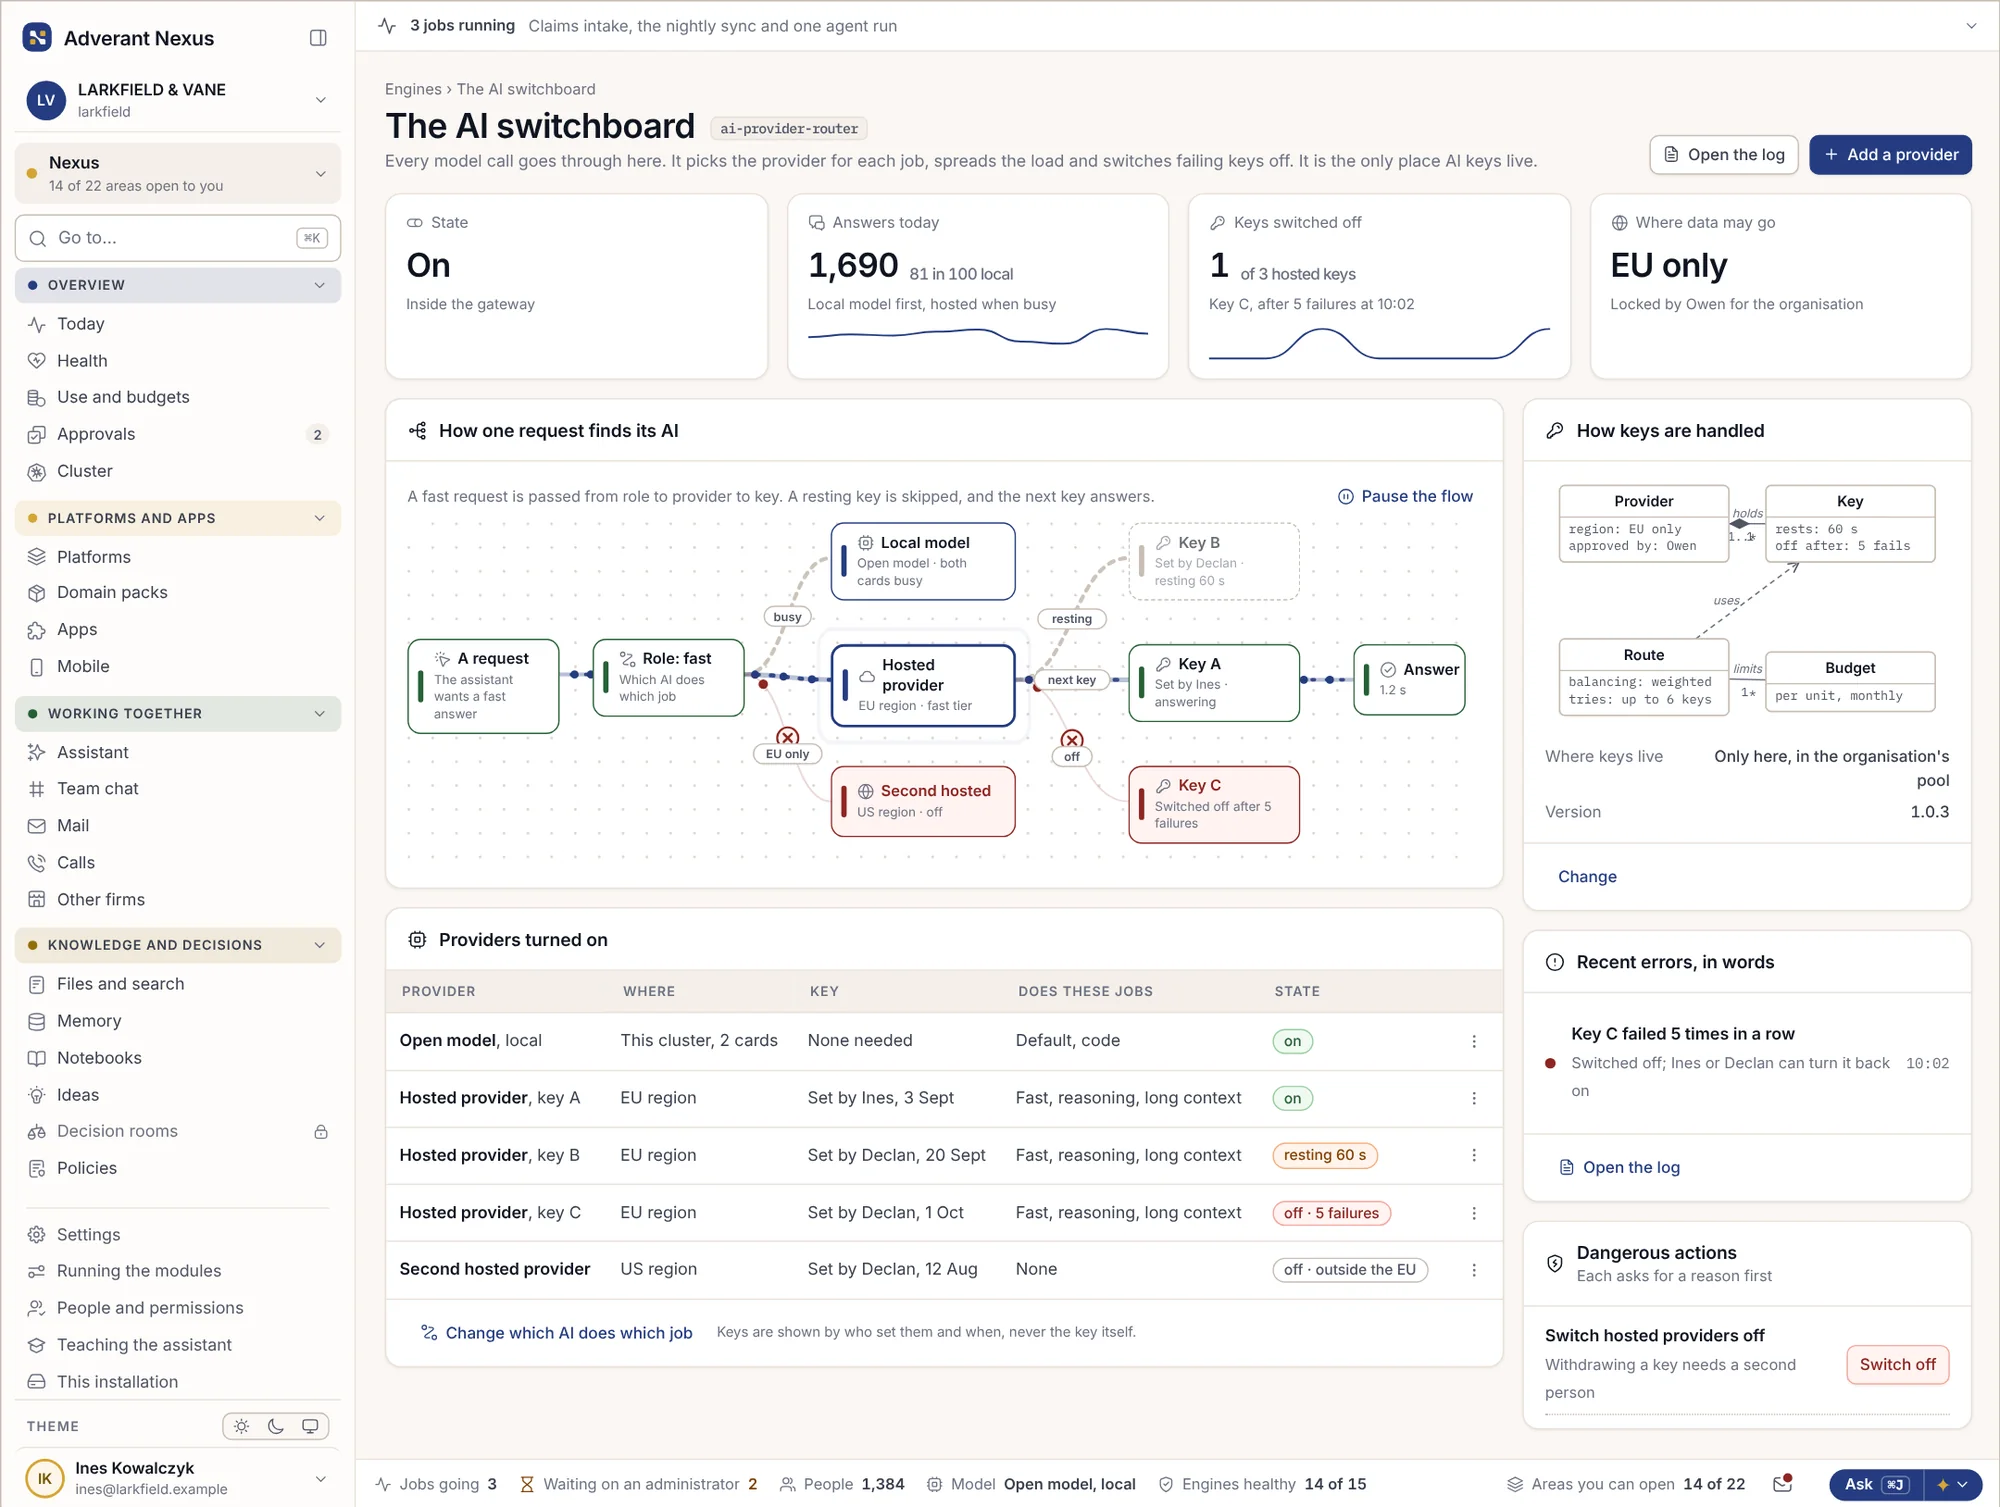
Les plateformes sur Nexus n’appellent jamais un modèle directement. Elles interrogent le standard. Celui-ci sélectionne le modèle adapté à la tâche, envoie l’appel vers un emplacement autorisé par vos règles et l’impute à un budget attribué à un responsable.
Une question. Quatre décisions, en quelques millisecondes.
Avant qu’un appel ne parte, la plateforme le qualifie : quelle entité fait la demande, pour quel rôle et quel est le niveau de sensibilité des données. Le standard achemine l’appel selon cette étiquette sans jamais l’ouvrir. Si le premier choix est occupé ou indisponible, le choix autorisé suivant prend le relais.
La tâche
Lire un formulaire numérisé, rédiger un courrier ou vérifier une décision nécessite des modèles différents. Chaque application précise la nature de la tâche.
Les données
Les données personnelles ou confidentielles peuvent être restreintes à vos propres modèles sur votre propre matériel. Les données publiques peuvent faire appel à d’autres options.
Le lieu
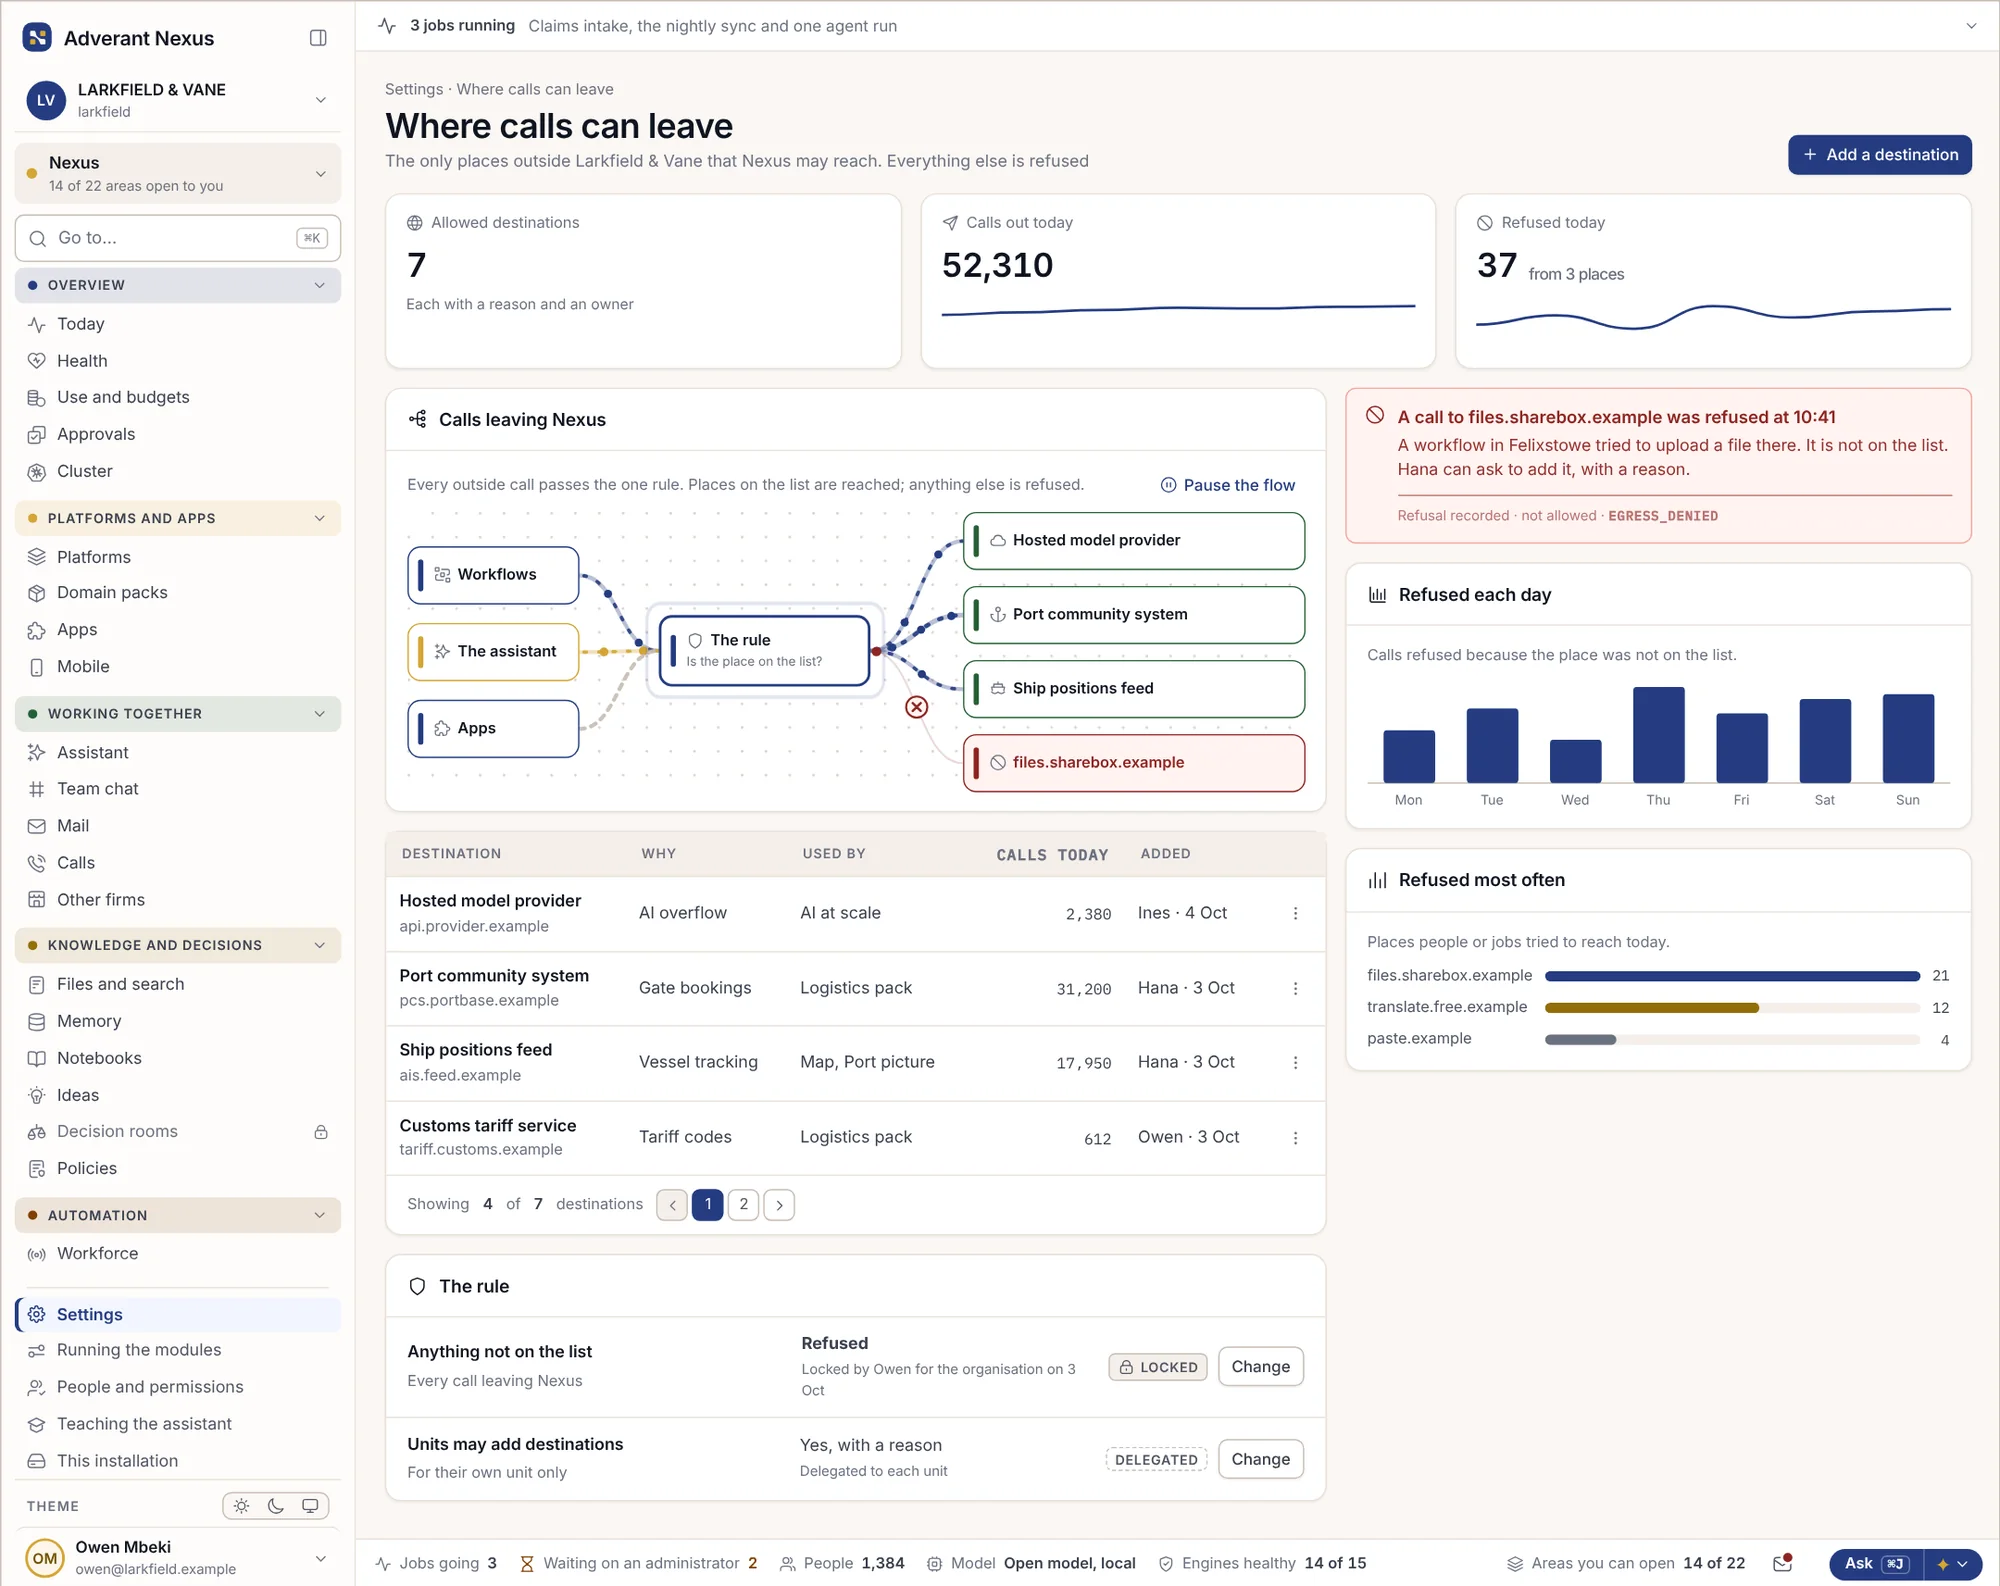
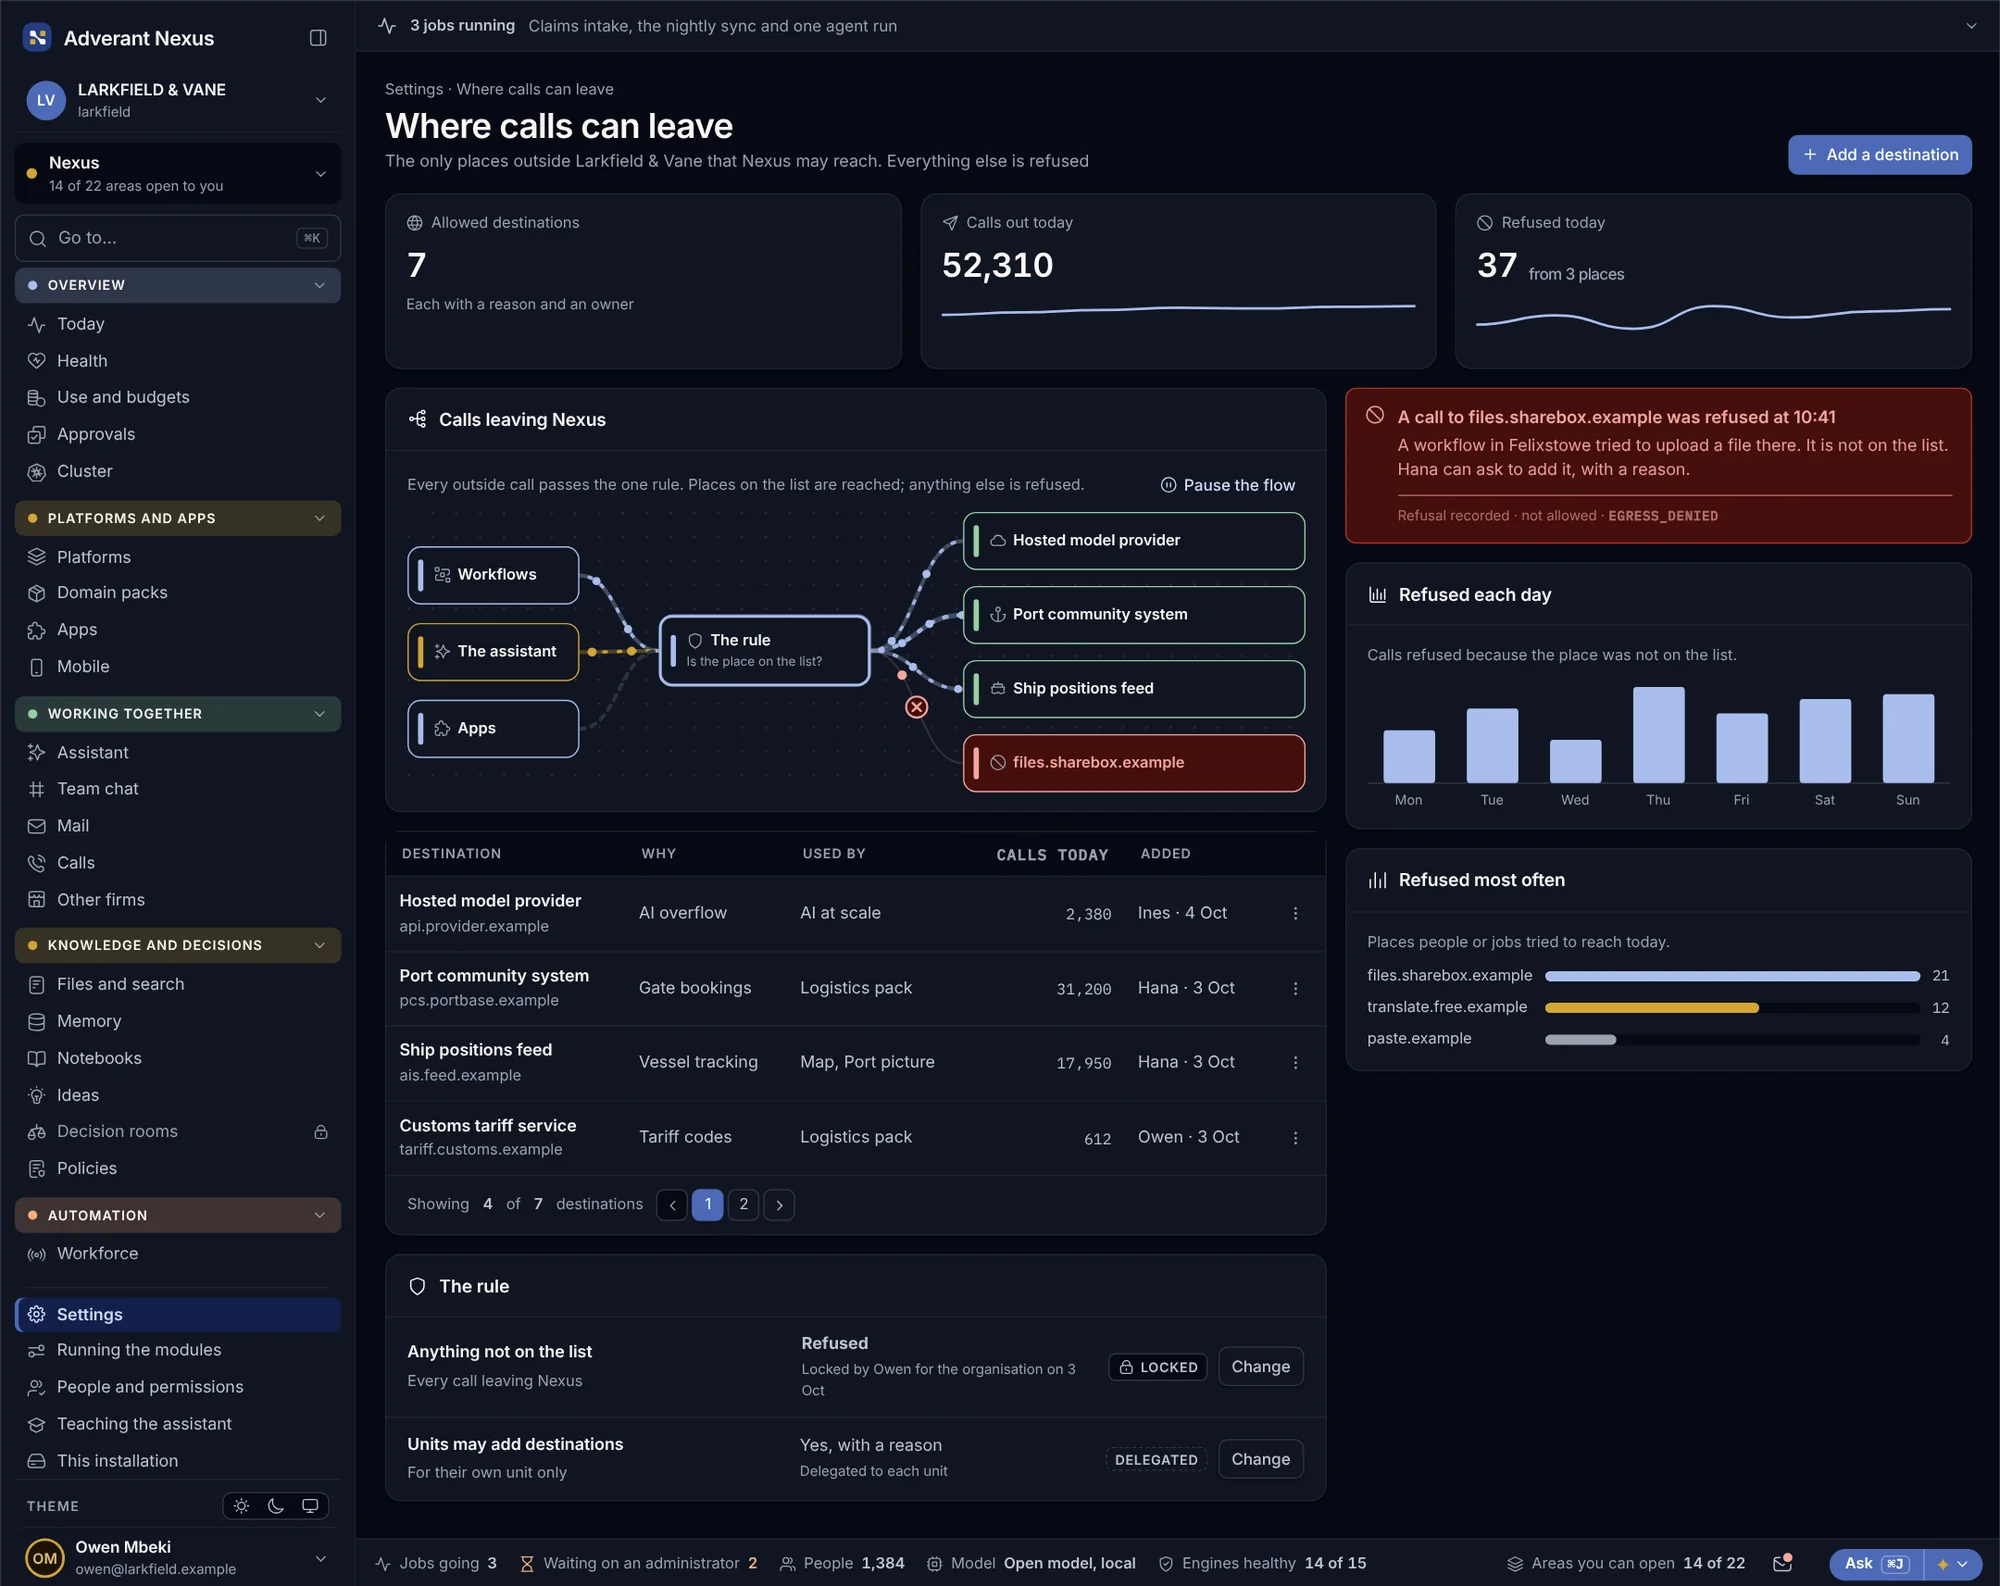
Les appels ne vont que vers les régions et les fournisseurs autorisés par l’entité. Un appel qui tenterait d’en sortir est refusé, et ce refus est consigné.
Le repli
Si un modèle est lent ou indisponible, le modèle autorisé suivant répond. Personne n’attend, et aucune règle n’est enfreinte pour y parvenir.
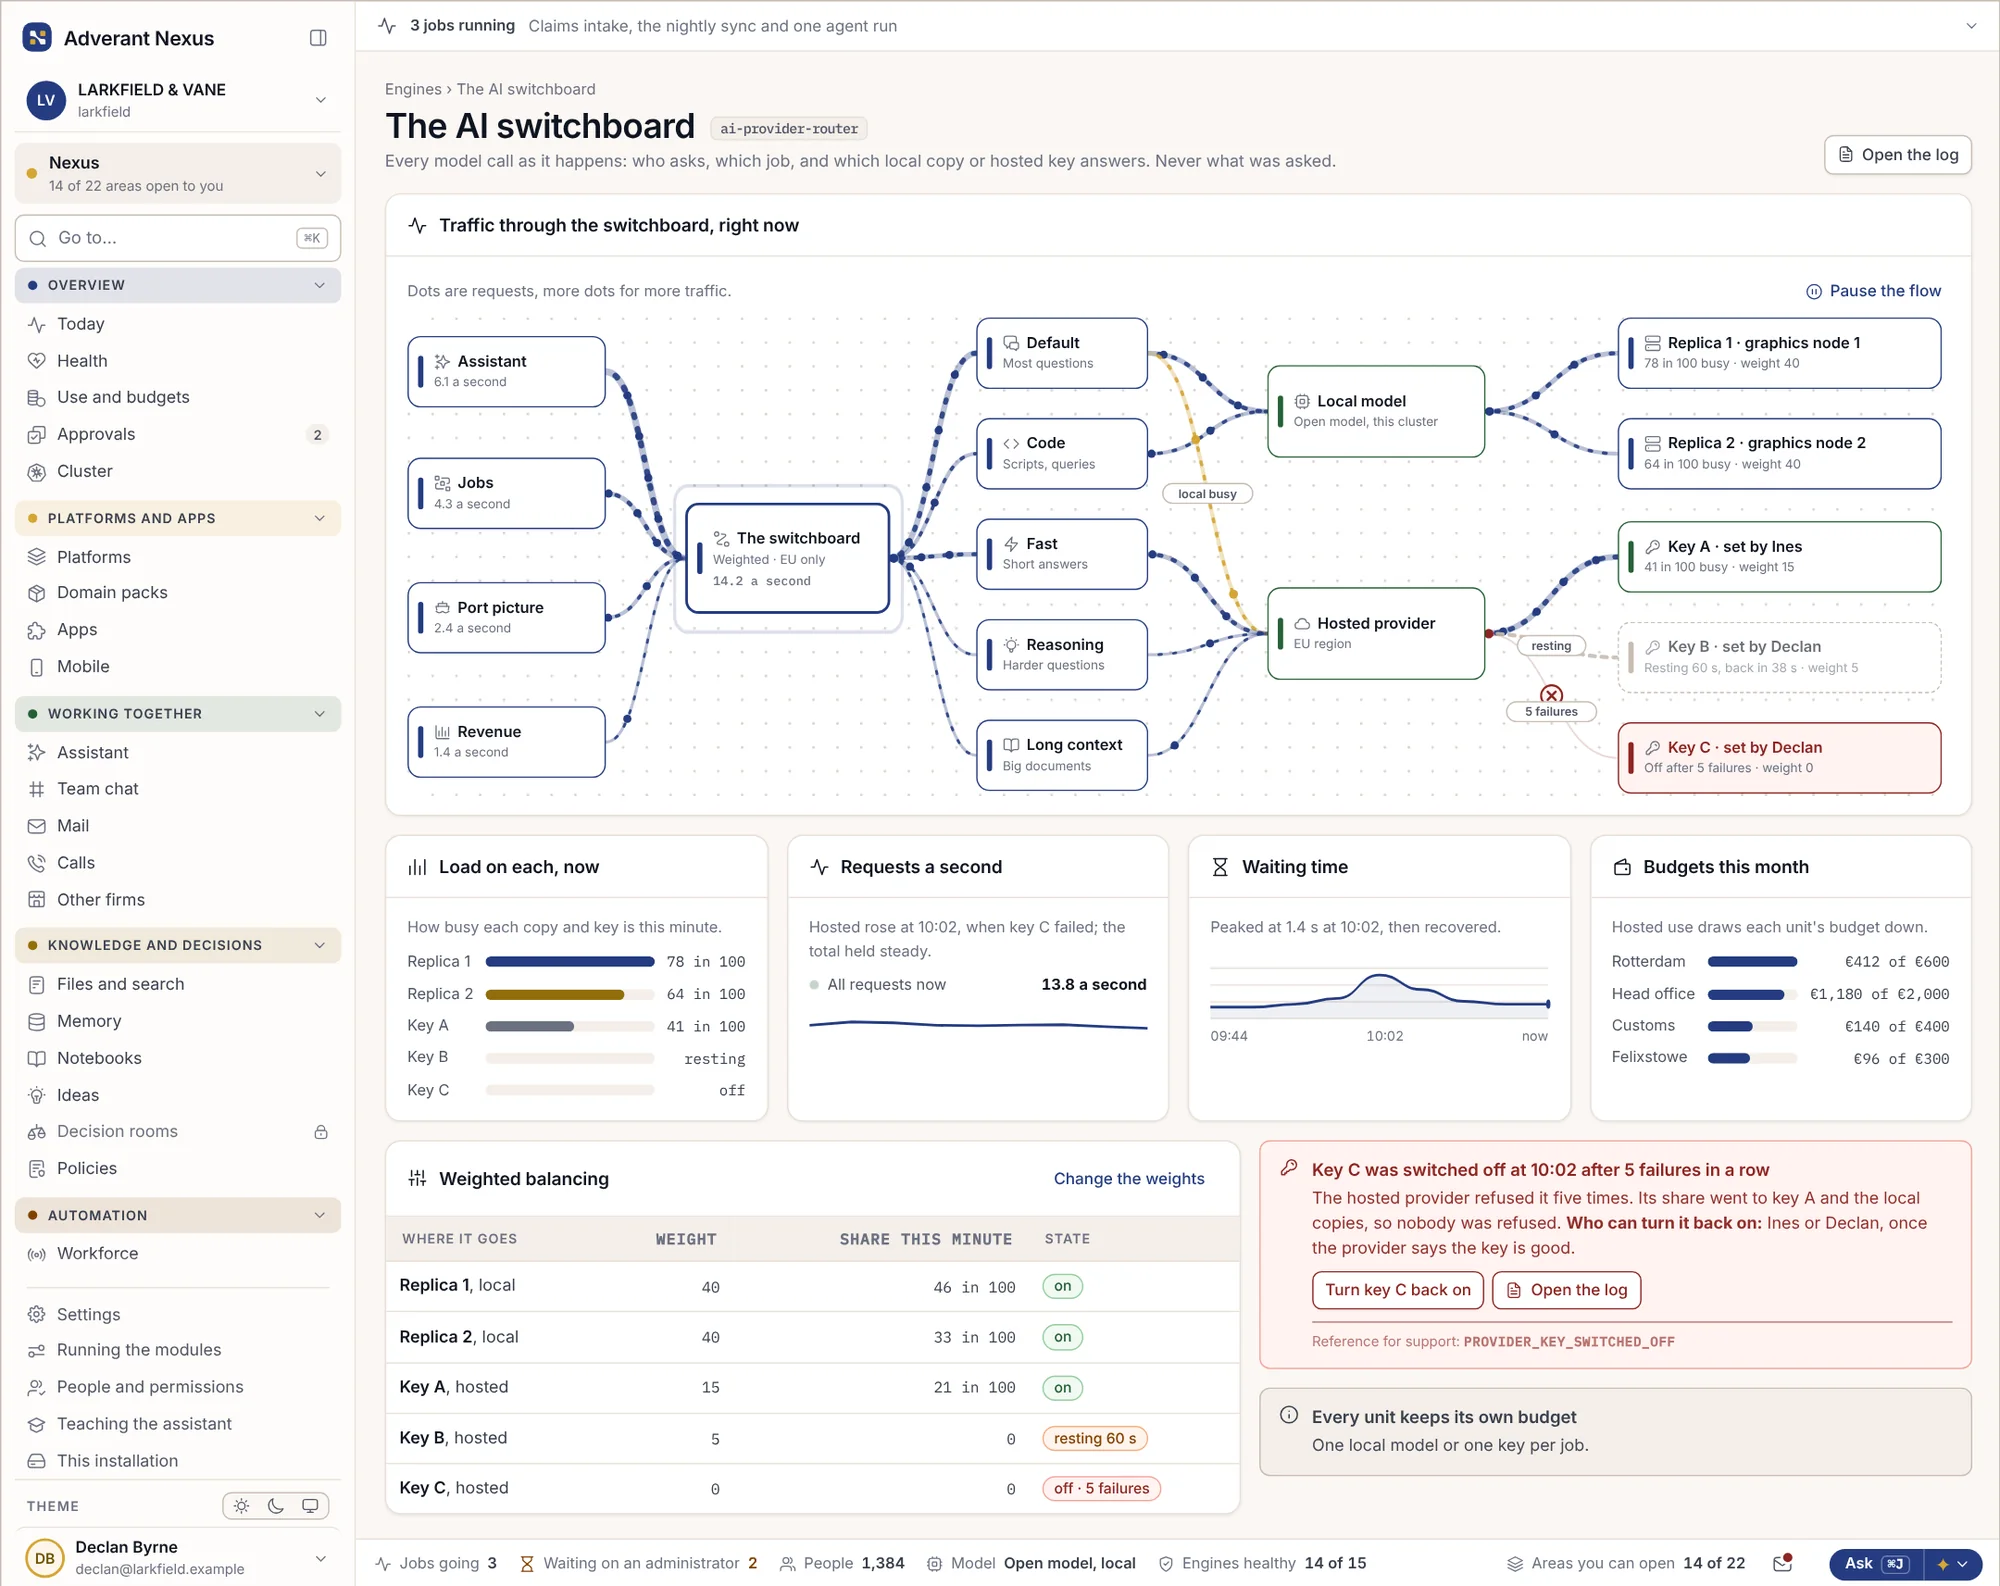
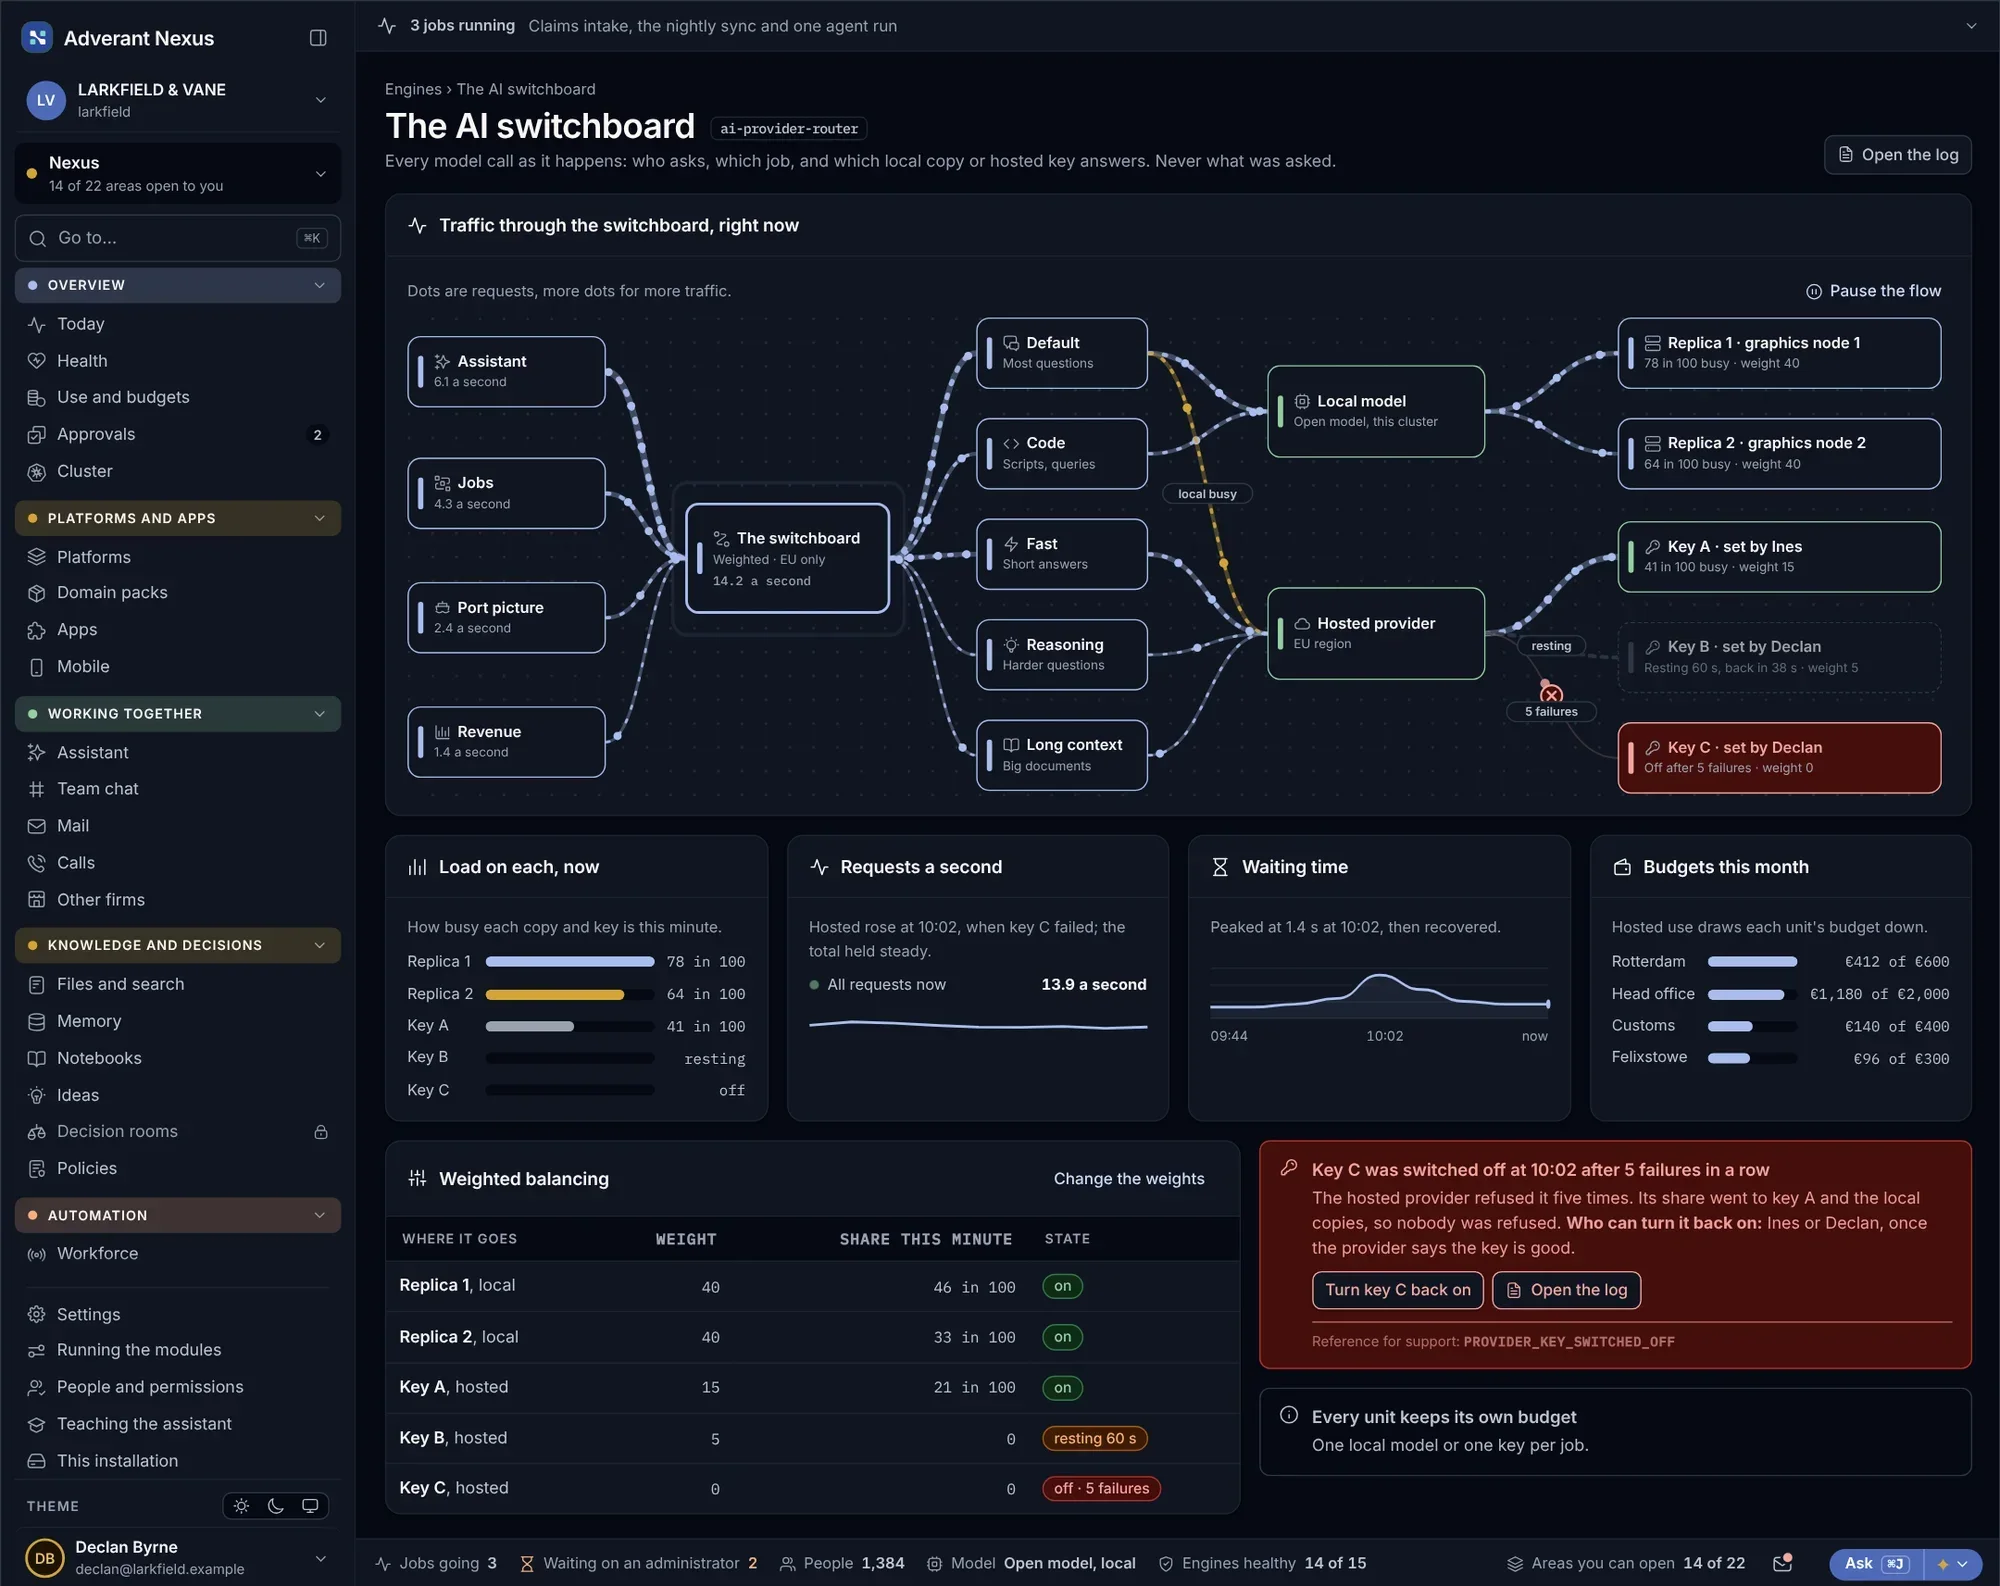
Vos règles décident où un appel peut être envoyé.
Définissez-les une fois pour l’entreprise, puis affinez-les pour une entité ou une plateforme. Une unité de défense peut être restreinte à des modèles sur son propre matériel, tandis que l’équipe marketing utilise un modèle hébergé dans l’UE.
- Vos propres modèles sur vos propres GPU, en priorité
- Les modèles hébergés que vous avez approuvés, par région
- Par entité, par plateforme et par type de données
- Chaque appel refusé est consigné au registre
Chaque appel est imputé à un budget attribué à un responsable.
L’utilisation est comptabilisée par personne, équipe, application et jour. Chaque budget a un responsable désigné et un plafond, et la direction financière reçoit une facture unique. Nous comptabilisons l’usage. Nous ne lisons jamais le contenu.
- Budgets
Par entité et par application, avec une alerte avant le plafond et une personne habilitée à le relever.
- Une seule facture
Chaque modèle, hébergé ou interne, sur un relevé unique que la direction financière peut suivre.
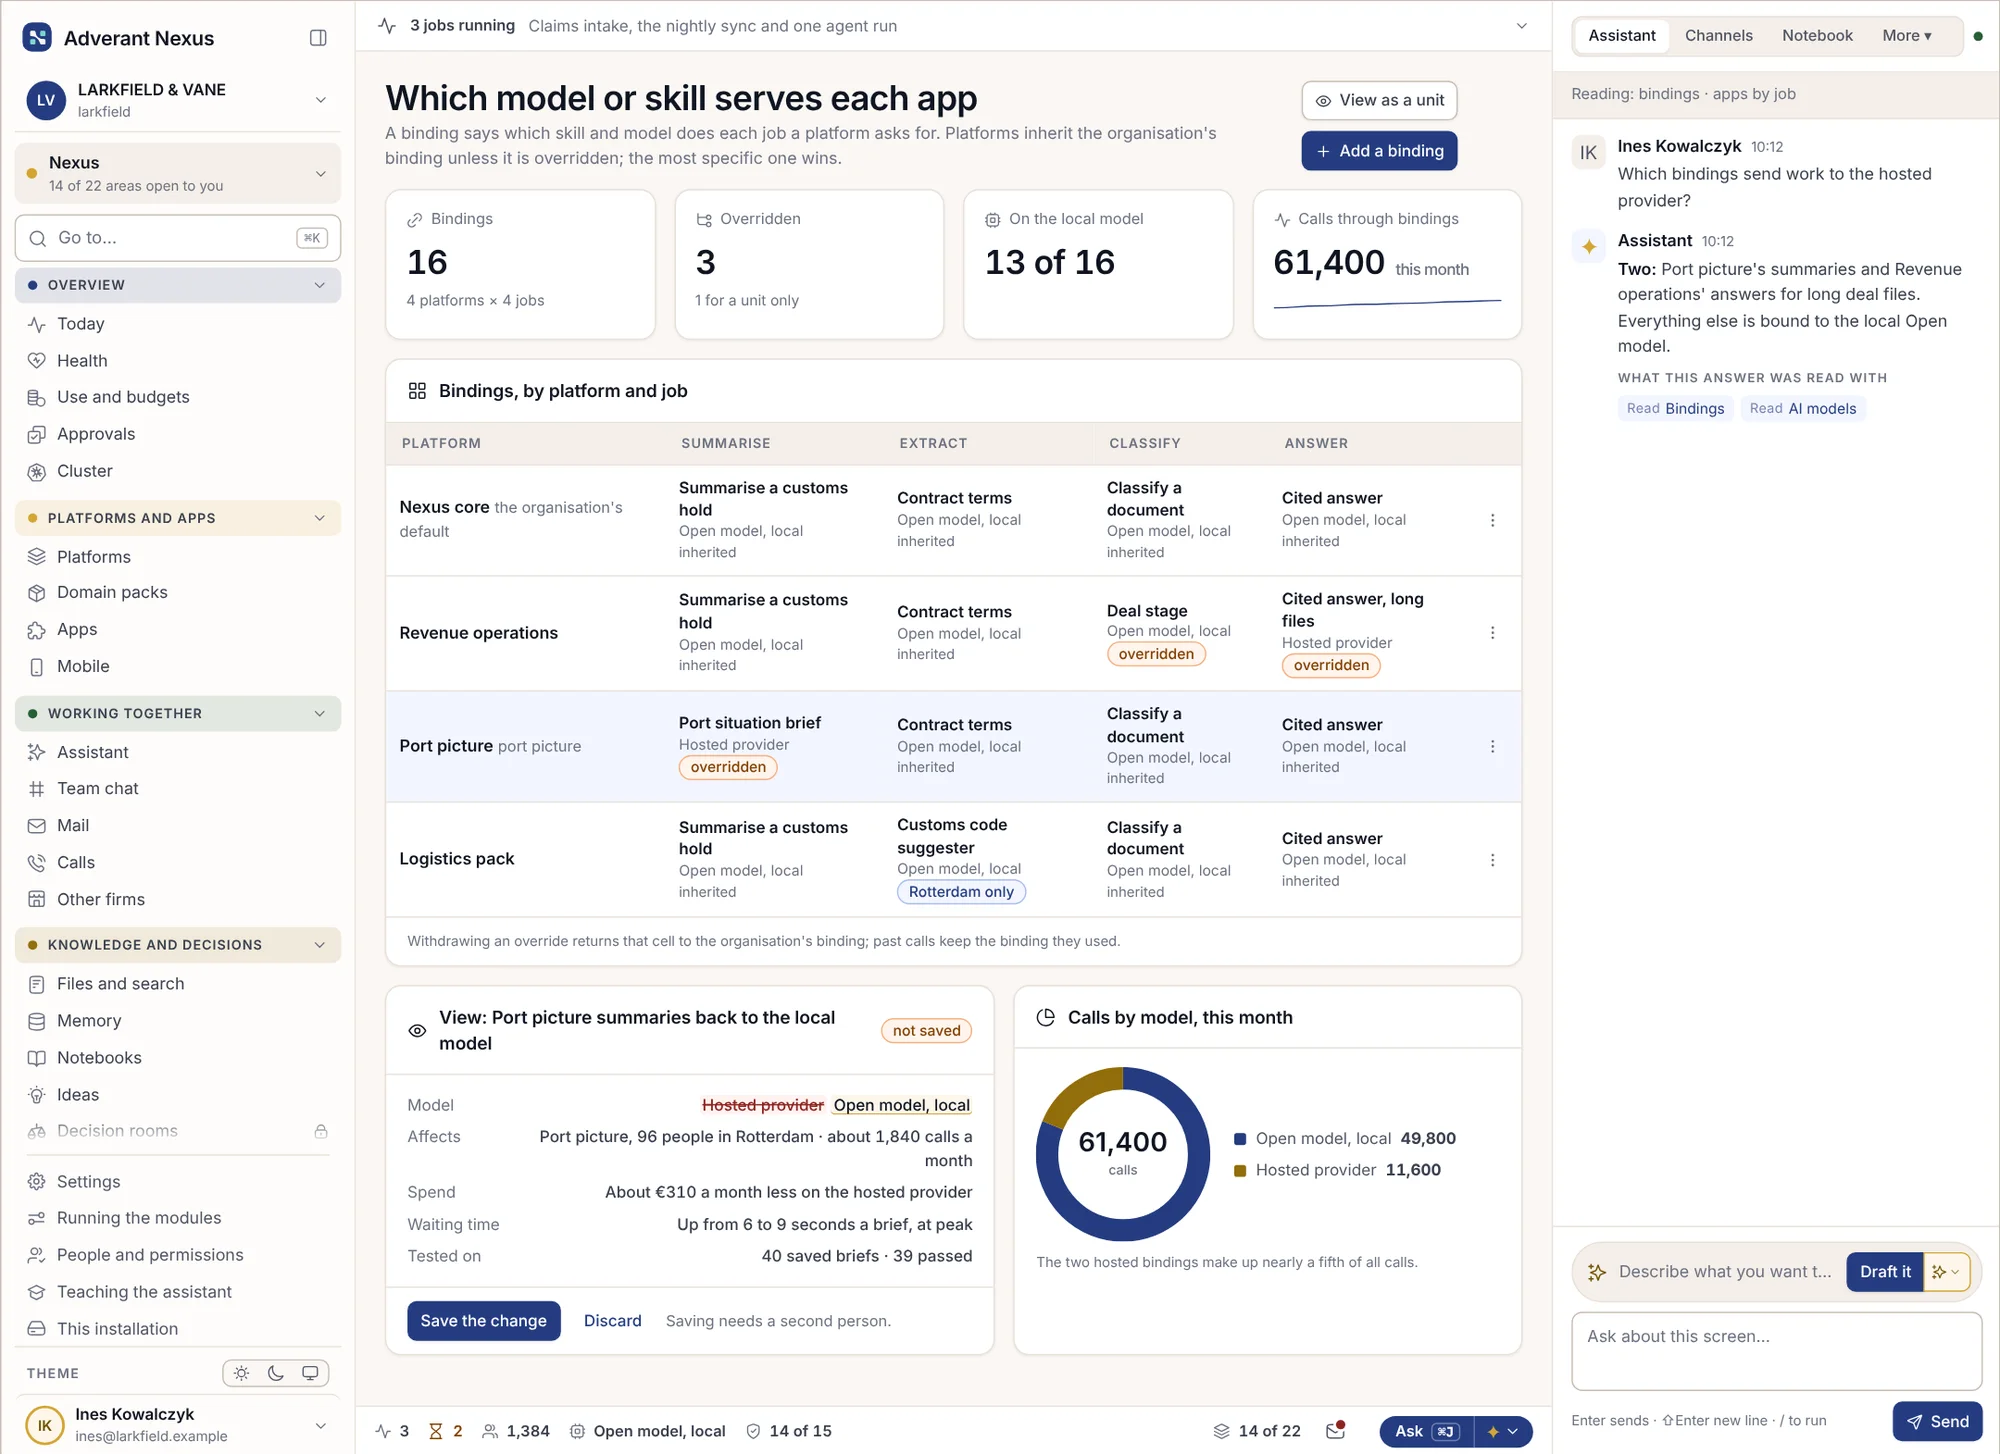
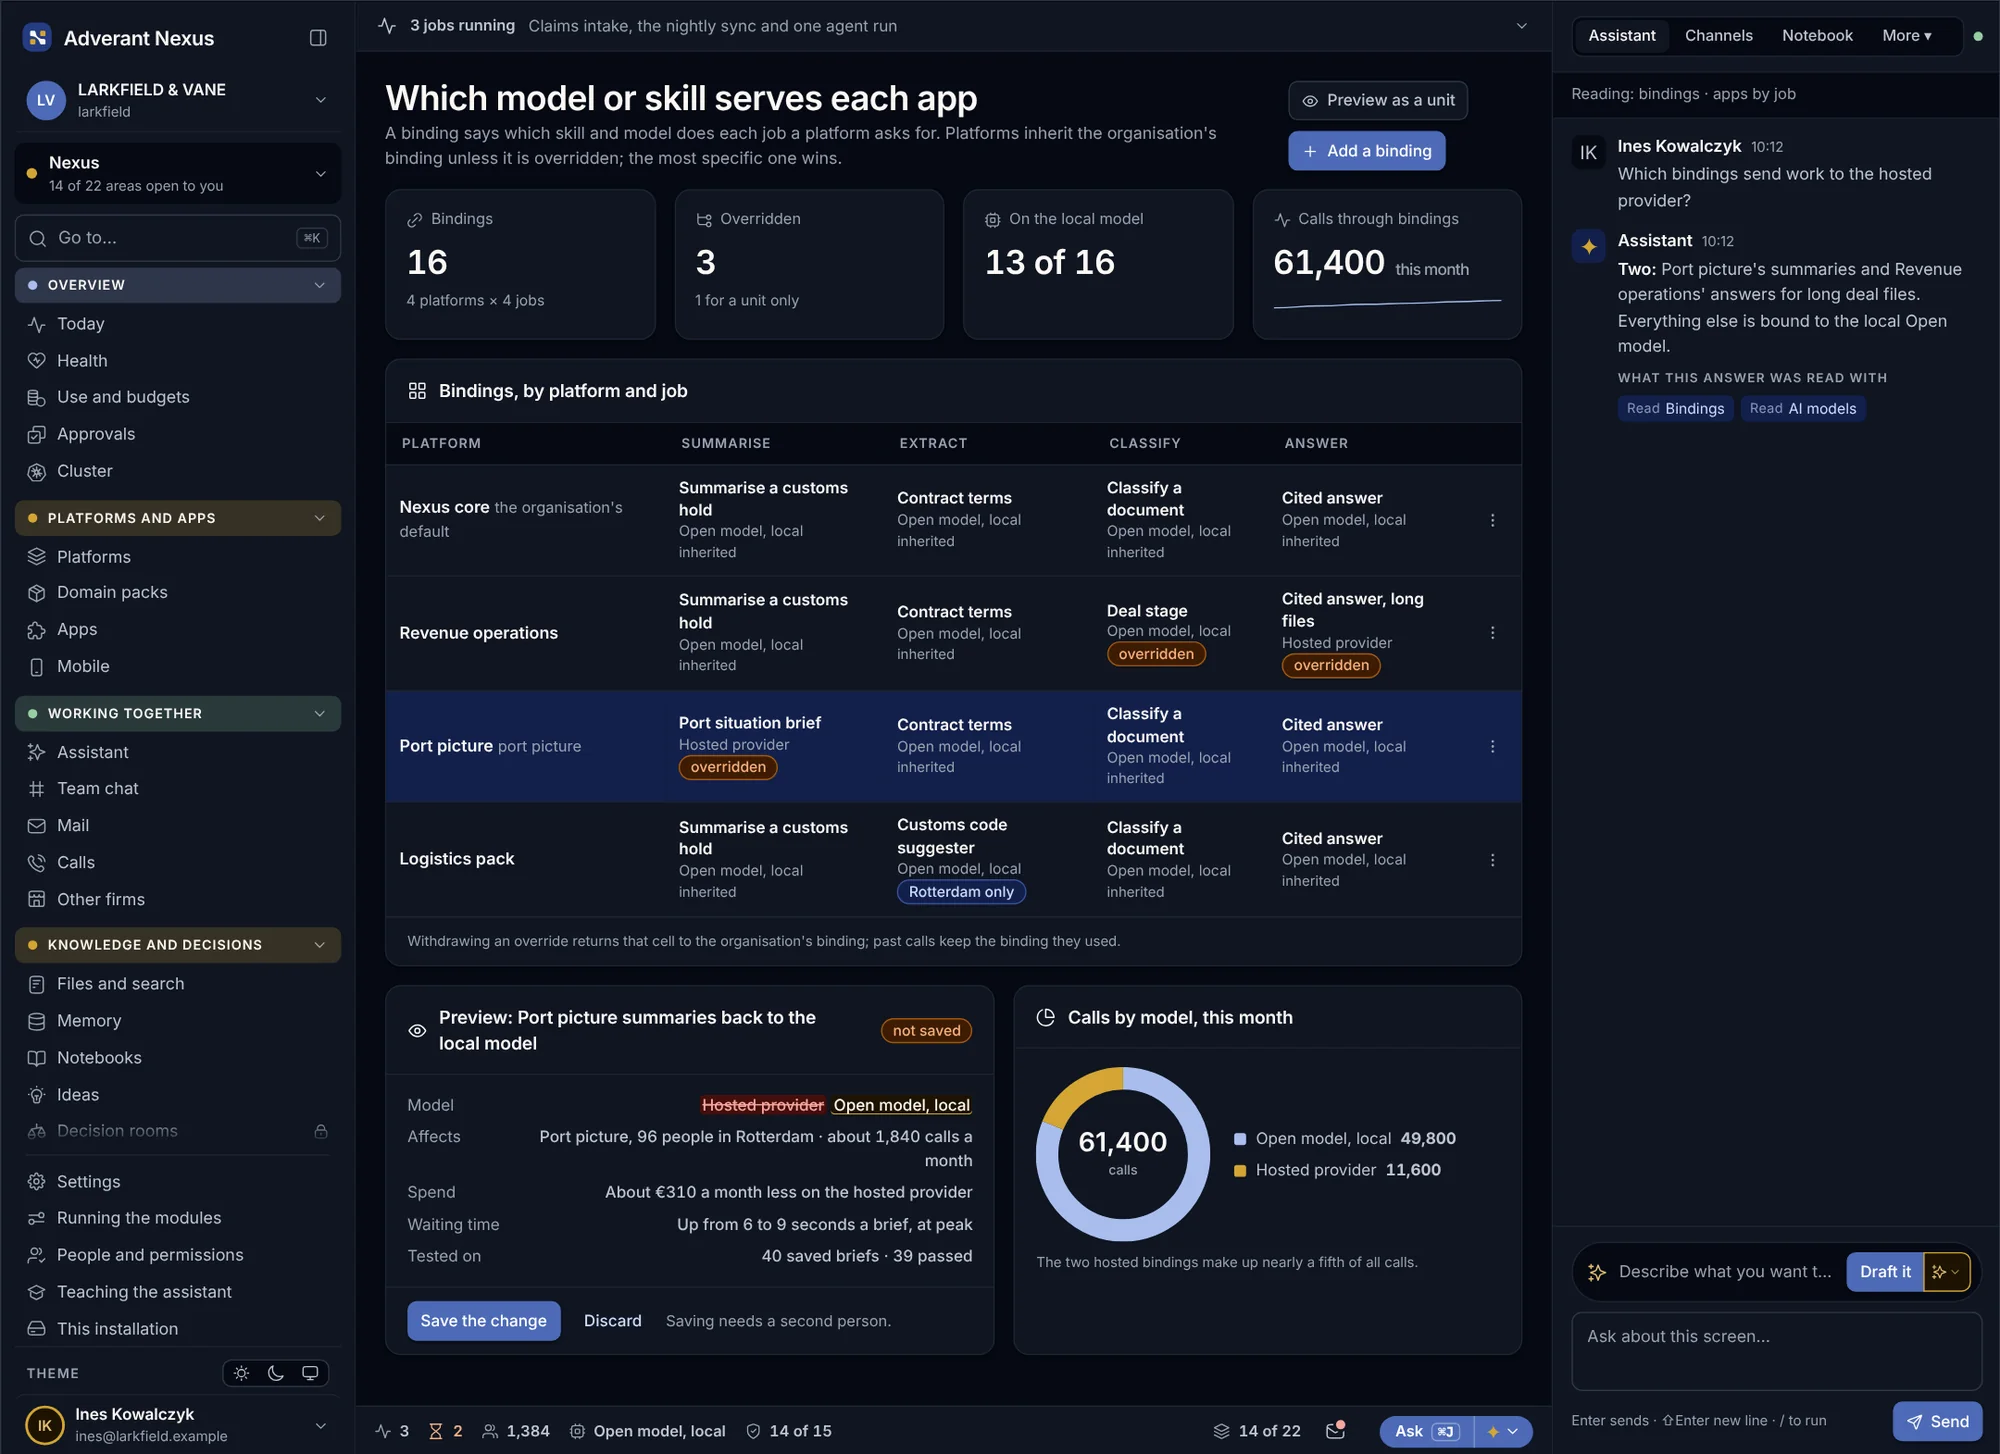
- Quel modèle sert quoi
Voyez quel modèle ou quelle compétence répond à chaque application, et modifiez-le au même endroit.
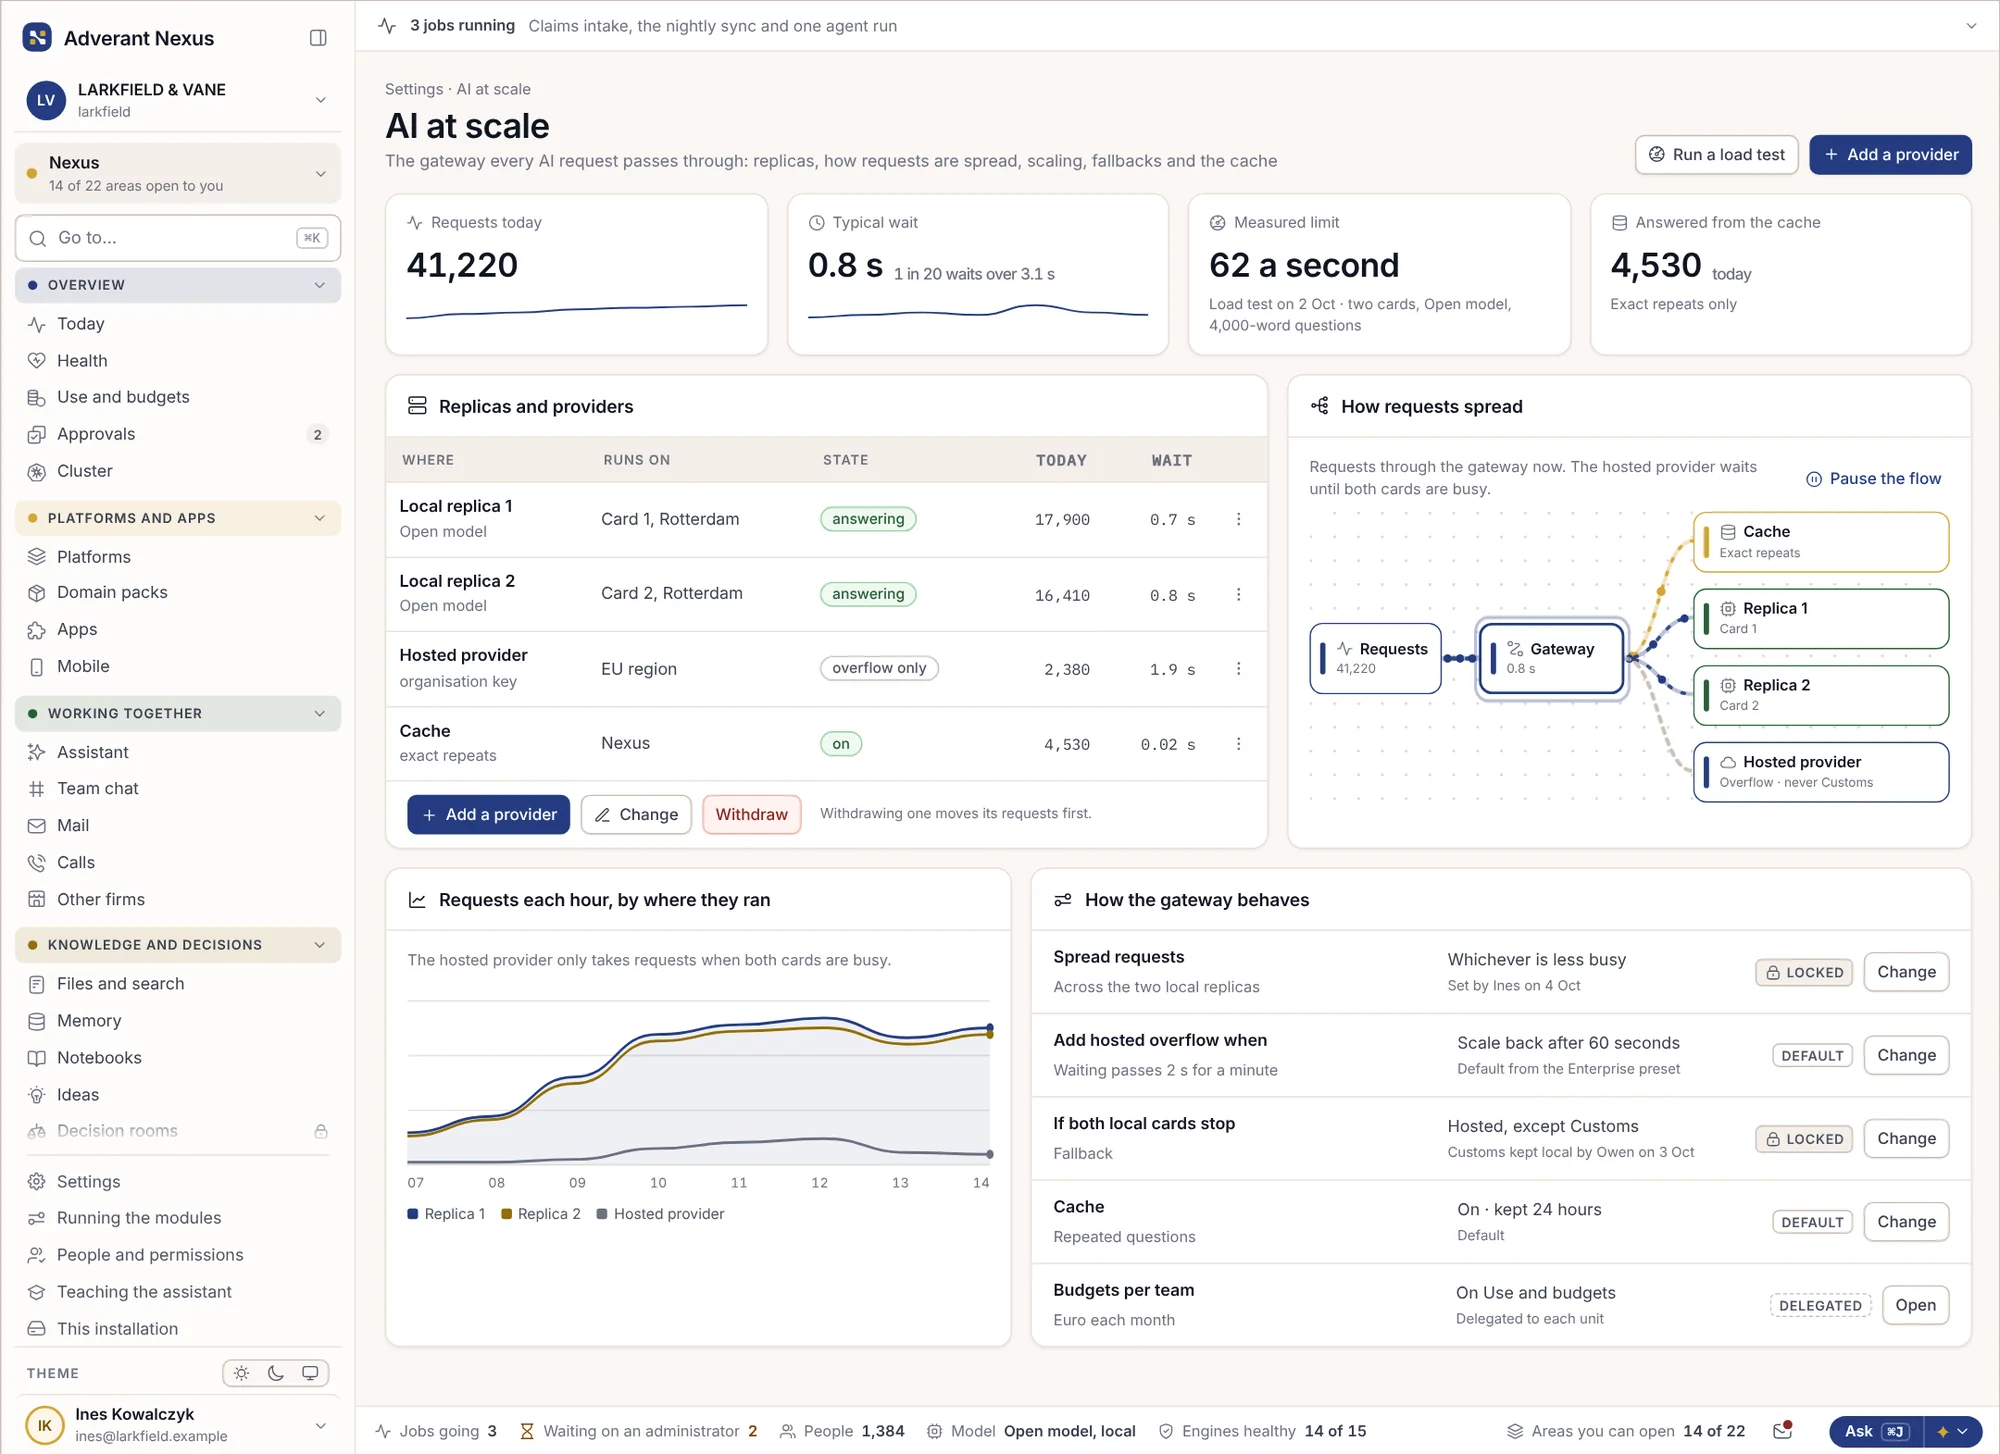
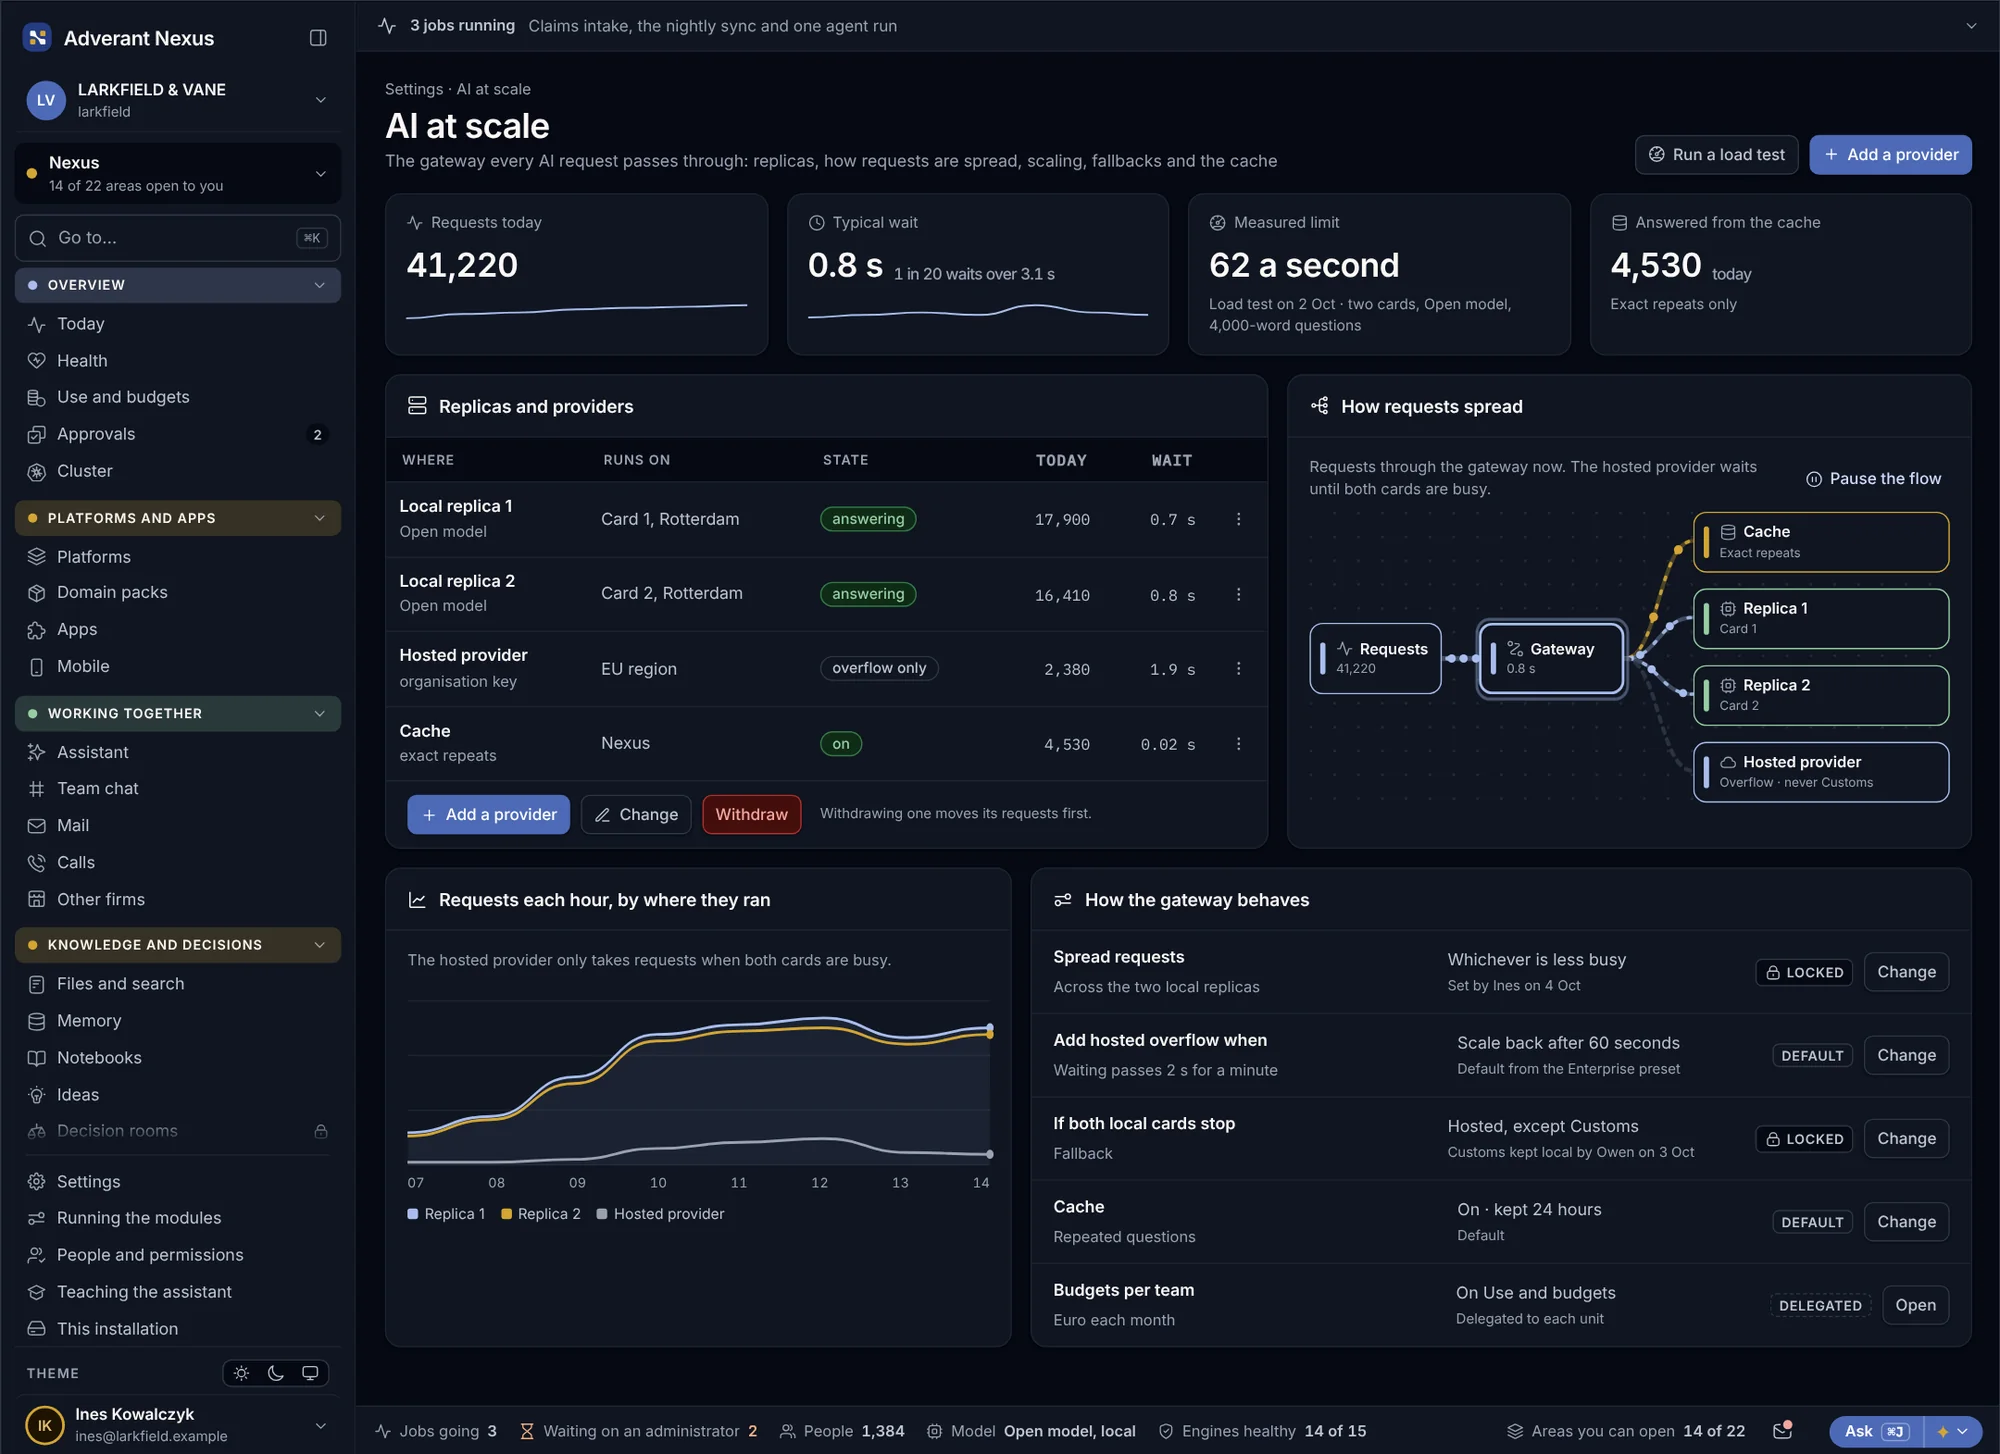
D’une seule équipe à chaque entité.
À mesure que l’usage augmente, le standard répartit les appels entre les copies de vos modèles, met en cache ce qui peut l’être et garantit une part équitable à chaque entité, afin qu’une équipe très active ne puisse pas ralentir les autres.
Questions fréquentes sur le standard.
Pouvons-nous utiliser nos propres modèles ?
Oui. Connectez les modèles qui tournent sur votre propre matériel ou sur votre propre compte cloud. Le standard les traite comme n’importe quel autre modèle, et vous pouvez les imposer pour certains types de données.
Adverant voit-il ce que nos collaborateurs demandent ?
Non. Le standard comptabilise les appels et mesure la durée et le coût. Il ne stocke ni ne lit le contenu d’une question ou d’une réponse.
Que se passe-t-il lorsqu’un fournisseur est indisponible ?
Le modèle autorisé suivant prend l’appel. Si aucun modèle autorisé n’est disponible, l’appel patiente ou échoue avec un motif clair. Il n’est jamais envoyé vers une destination interdite par vos règles.
Pouvons-nous définir des règles différentes pour chaque entité ?
Oui. Les règles sont définies au niveau de l’entreprise et peuvent être restreintes pour chaque entité, plateforme et type de données. Une entité ne peut jamais avoir de règles plus souples que celles de l’entreprise.
Aller plus loin
Voyez vos modèles derrière un standard unique.
Dites-nous quels modèles vous utilisez aujourd’hui et où vos données doivent rester. Nous vous montrerons les règles de routage adaptées.