

Alles wat uw bedrijf weet, verbonden en klaar om te bevragen.
De kern van Nexus is een kennisgraaf die is opgebouwd uit uw documenten, e-mails, systemen en dossiers. Zie het als uw eigen zoekmachine voor het bedrijf. De ontologie legt vast wat uw klanten, contracten, schepen of claims zijn en hoe ze met elkaar samenhangen. GraphRAG geeft vervolgens aan elke AI de feiten die ertoe doen voor een vraag, verzameld uit het hele bedrijf en elk voorzien van zijn bron. Dat is veel meer context dan er ooit in een prompt past, en precies daarom zijn de antwoorden betrouwbaar.
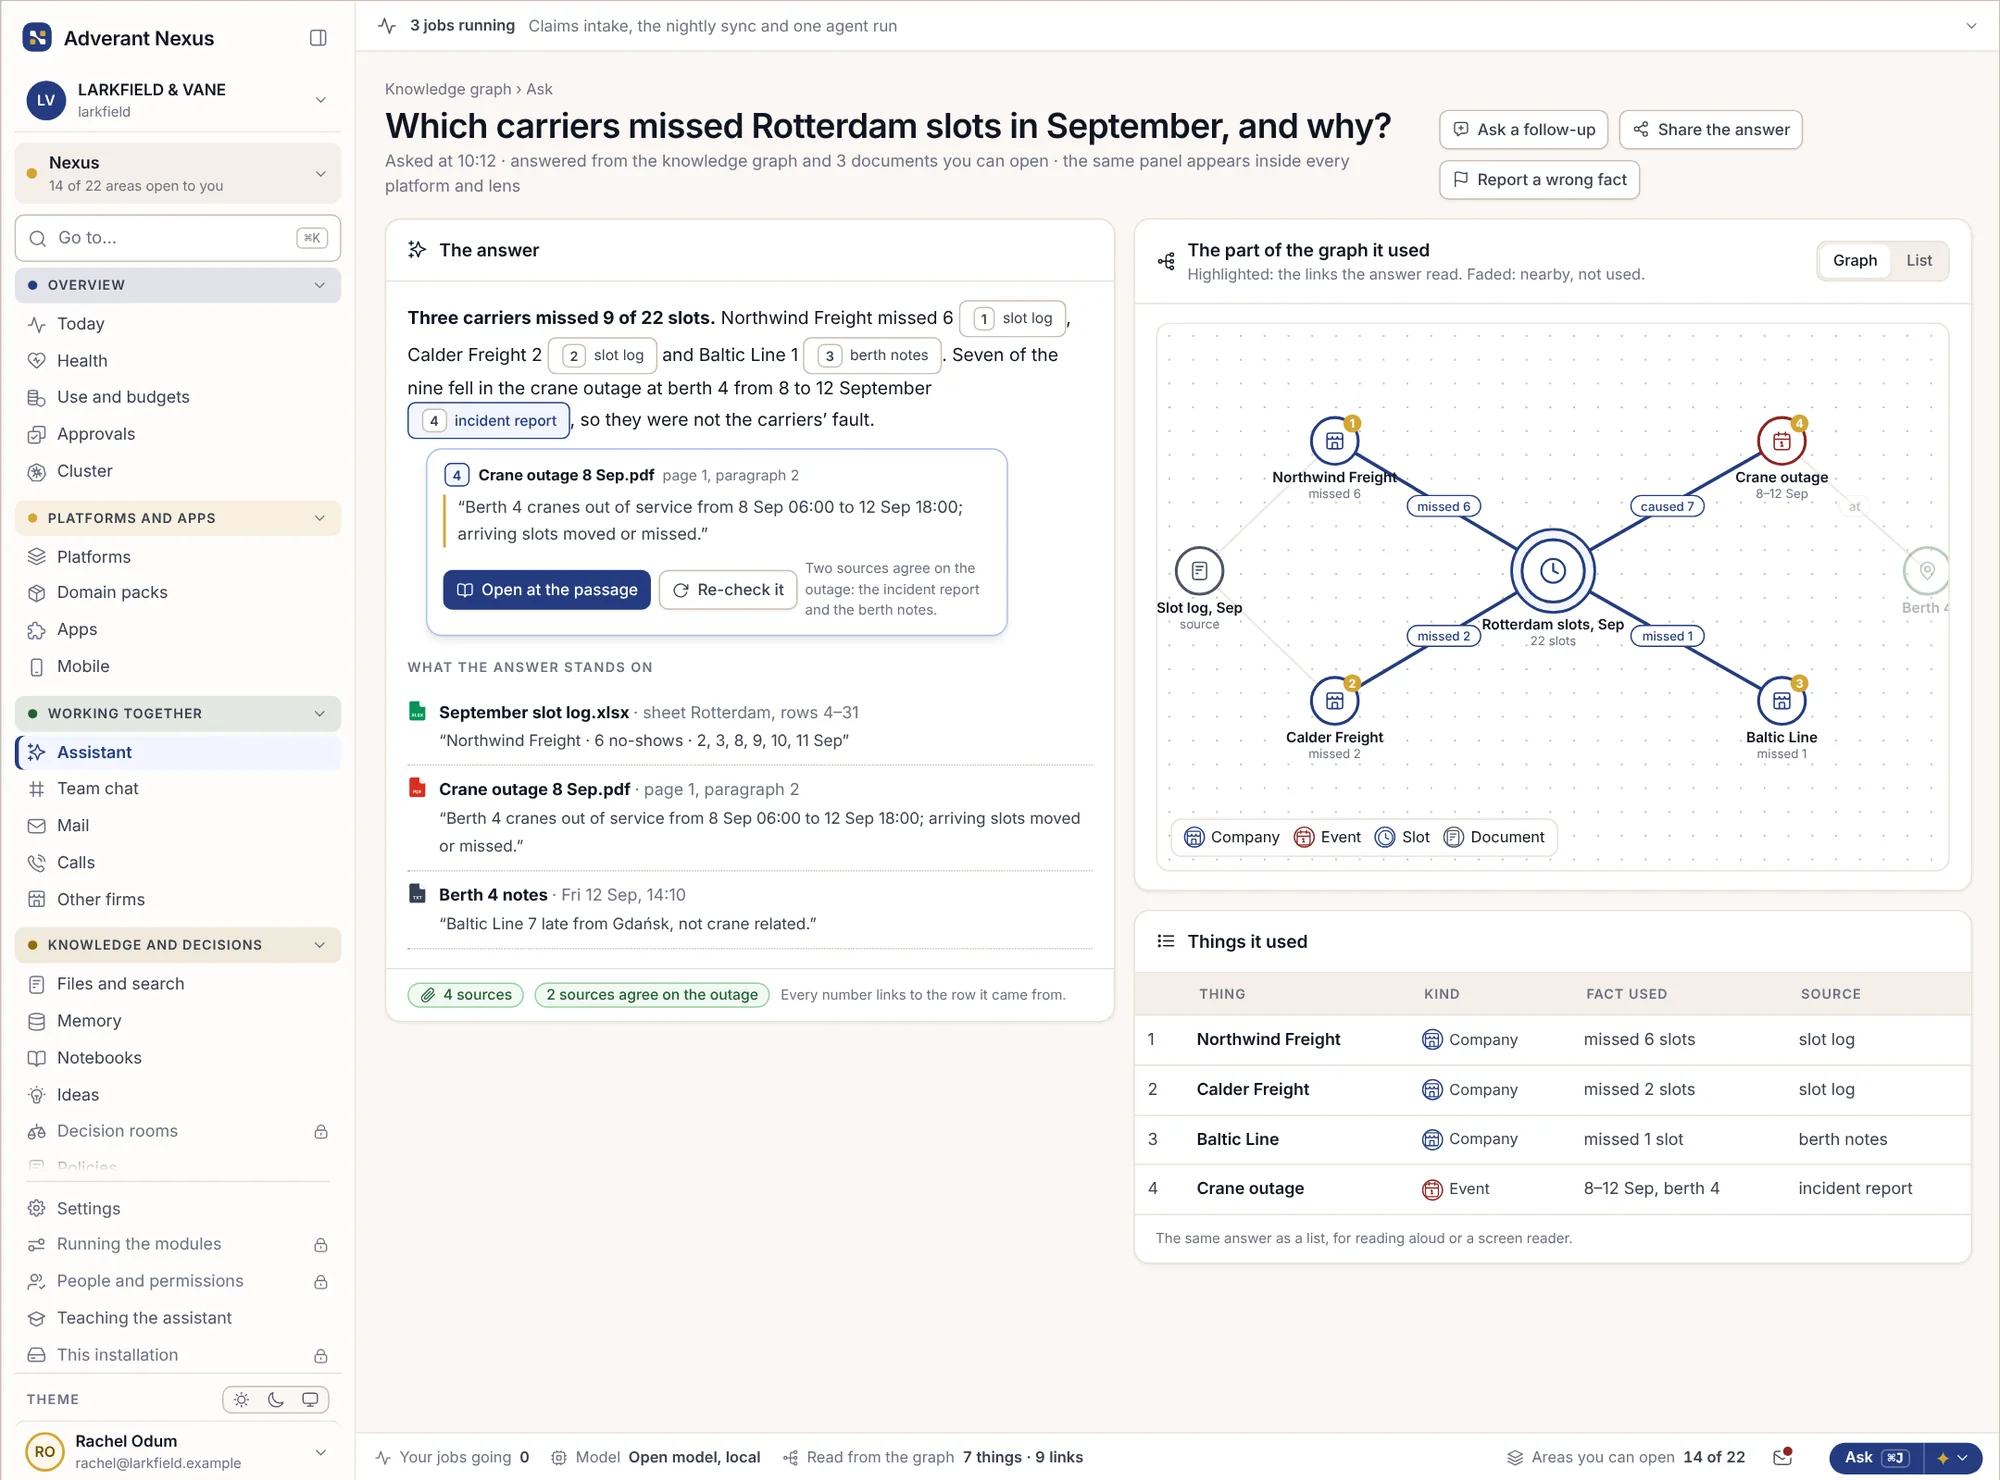
De volledige context, niet alleen de dichtstbijzijnde alinea.
Gewoon zoeken vindt documenten die dezelfde woorden gebruiken. GraphRAG volgt de verbanden: een vraag over een vervoerder leidt naar zijn contracten, zijn claims, de schepen waarmee hij vaart en de e-mails daarover, zelfs als daarin nergens dezelfde woorden voorkomen. De AI antwoordt vanuit dat totaalbeeld en toont elk gebruikt feit.
- Antwoorden uit het hele bedrijf
- Verbanden gevolgd, niet alleen trefwoorden
- Samenvattingen van volledige onderwerpen bij brede vragen
- Alleen feiten die de vraagsteller mag zien
Vorm het model. Zie eerst wat het raakt.
Voeg een type object, een eigenschap of een koppeling toe en zie hoeveel bestaande feiten erdoor zouden veranderen voordat u opslaat. Domeinpakketten bieden een startmodel voor hun sector, dat u uitbreidt voor uw eigen bedrijf.
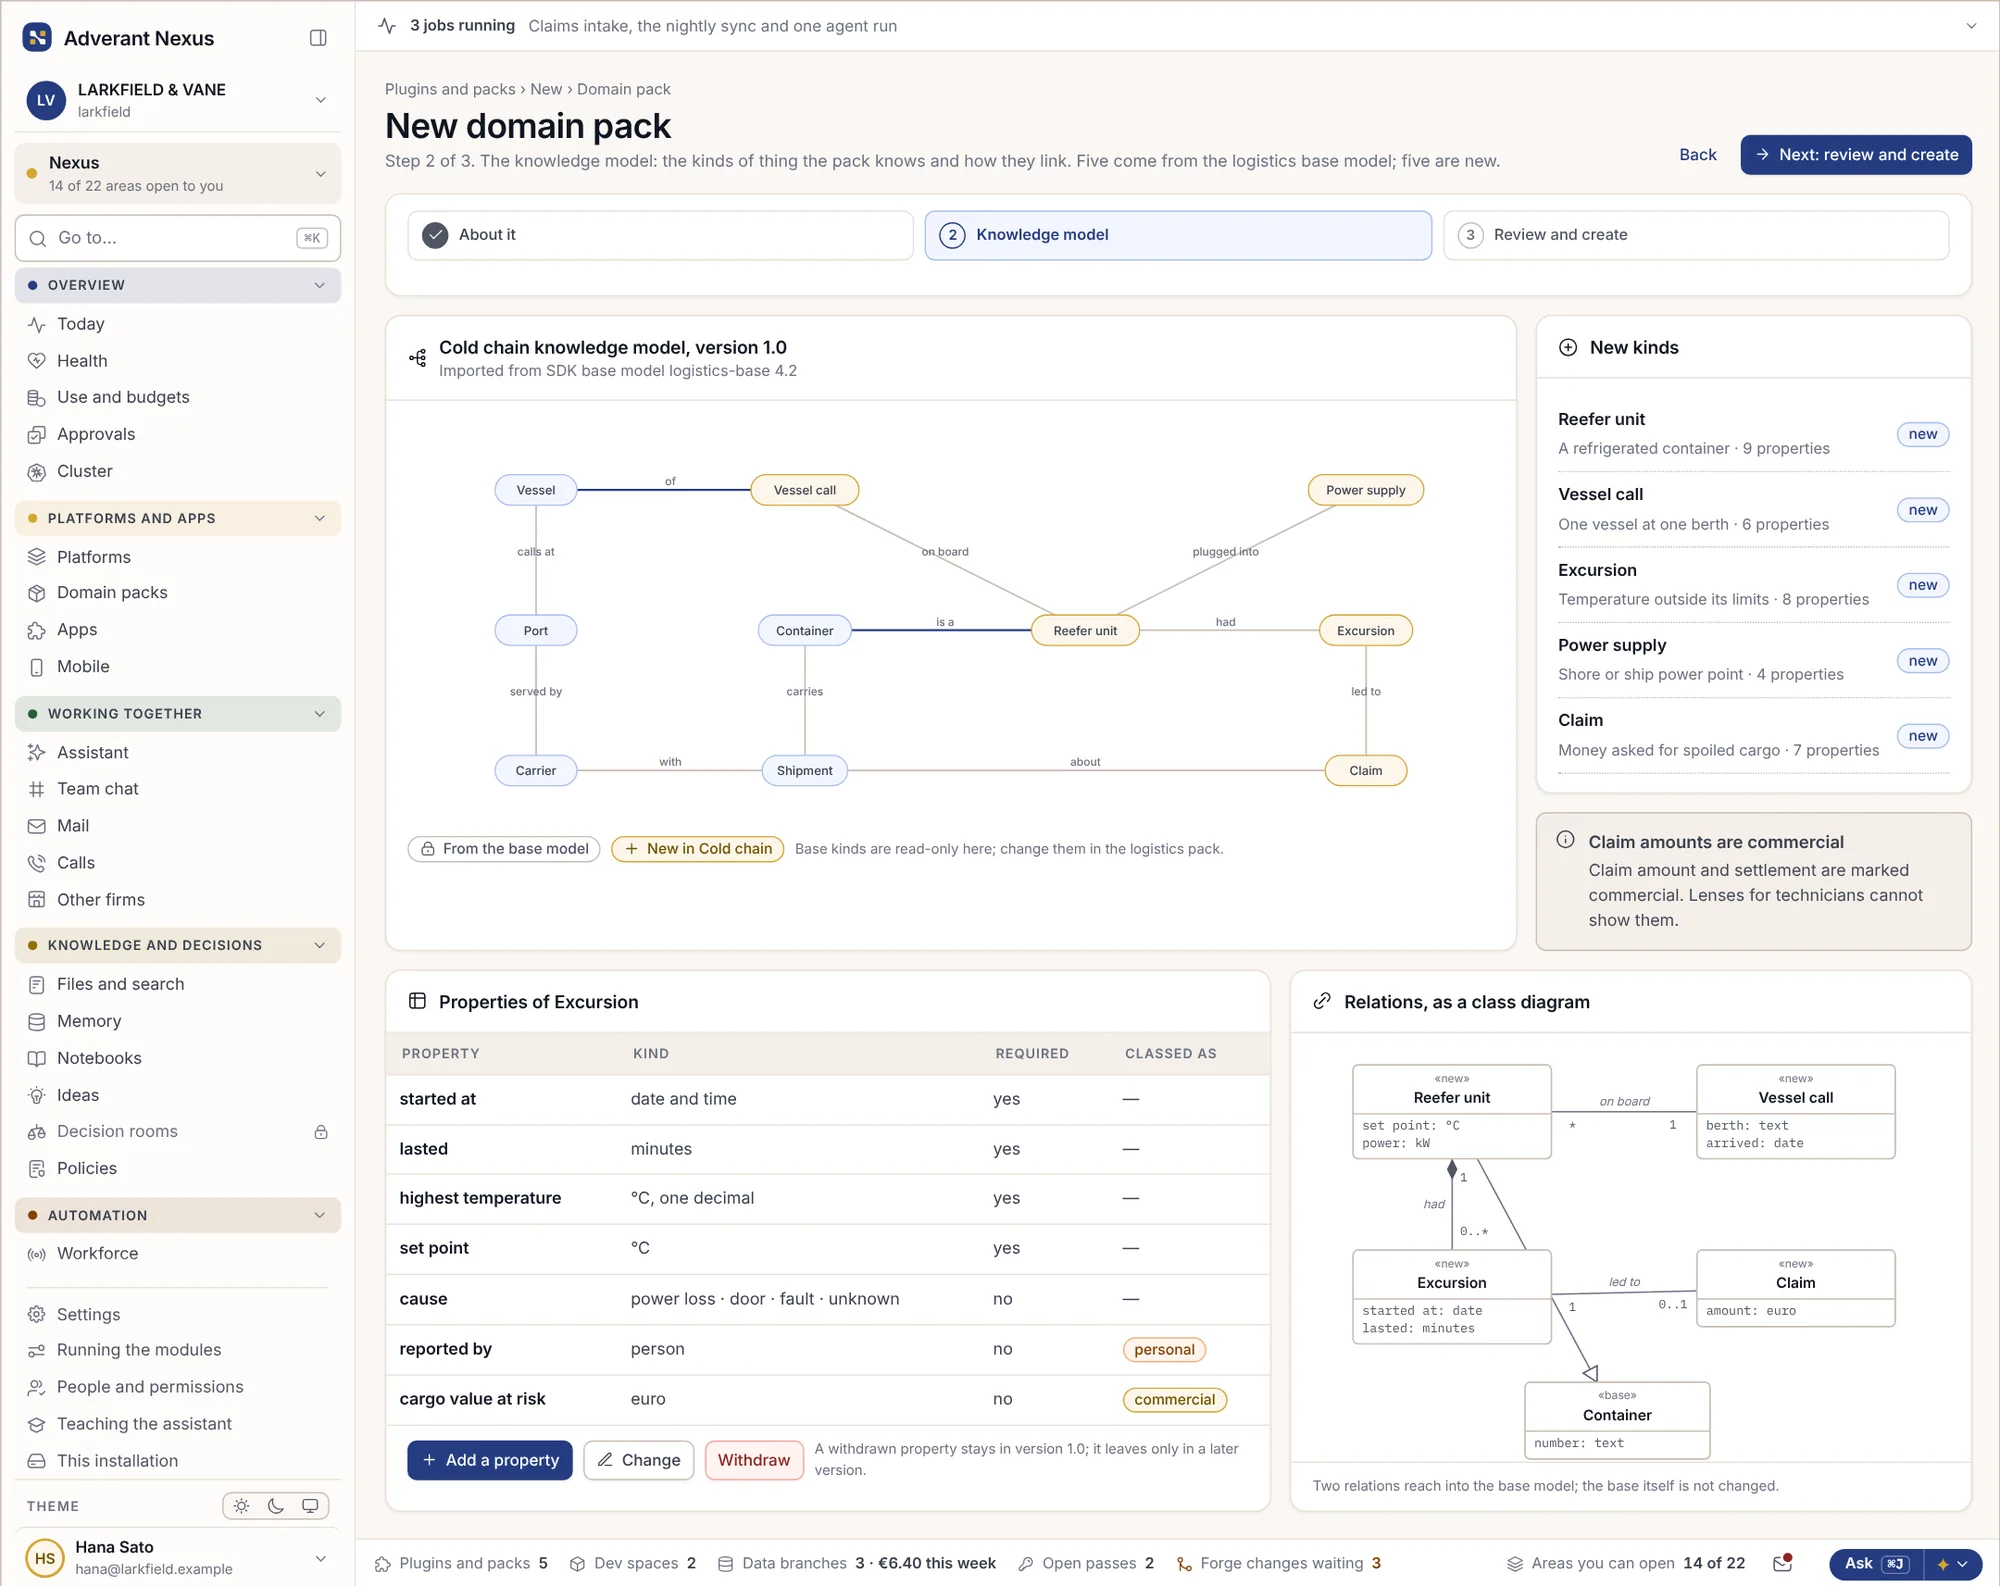
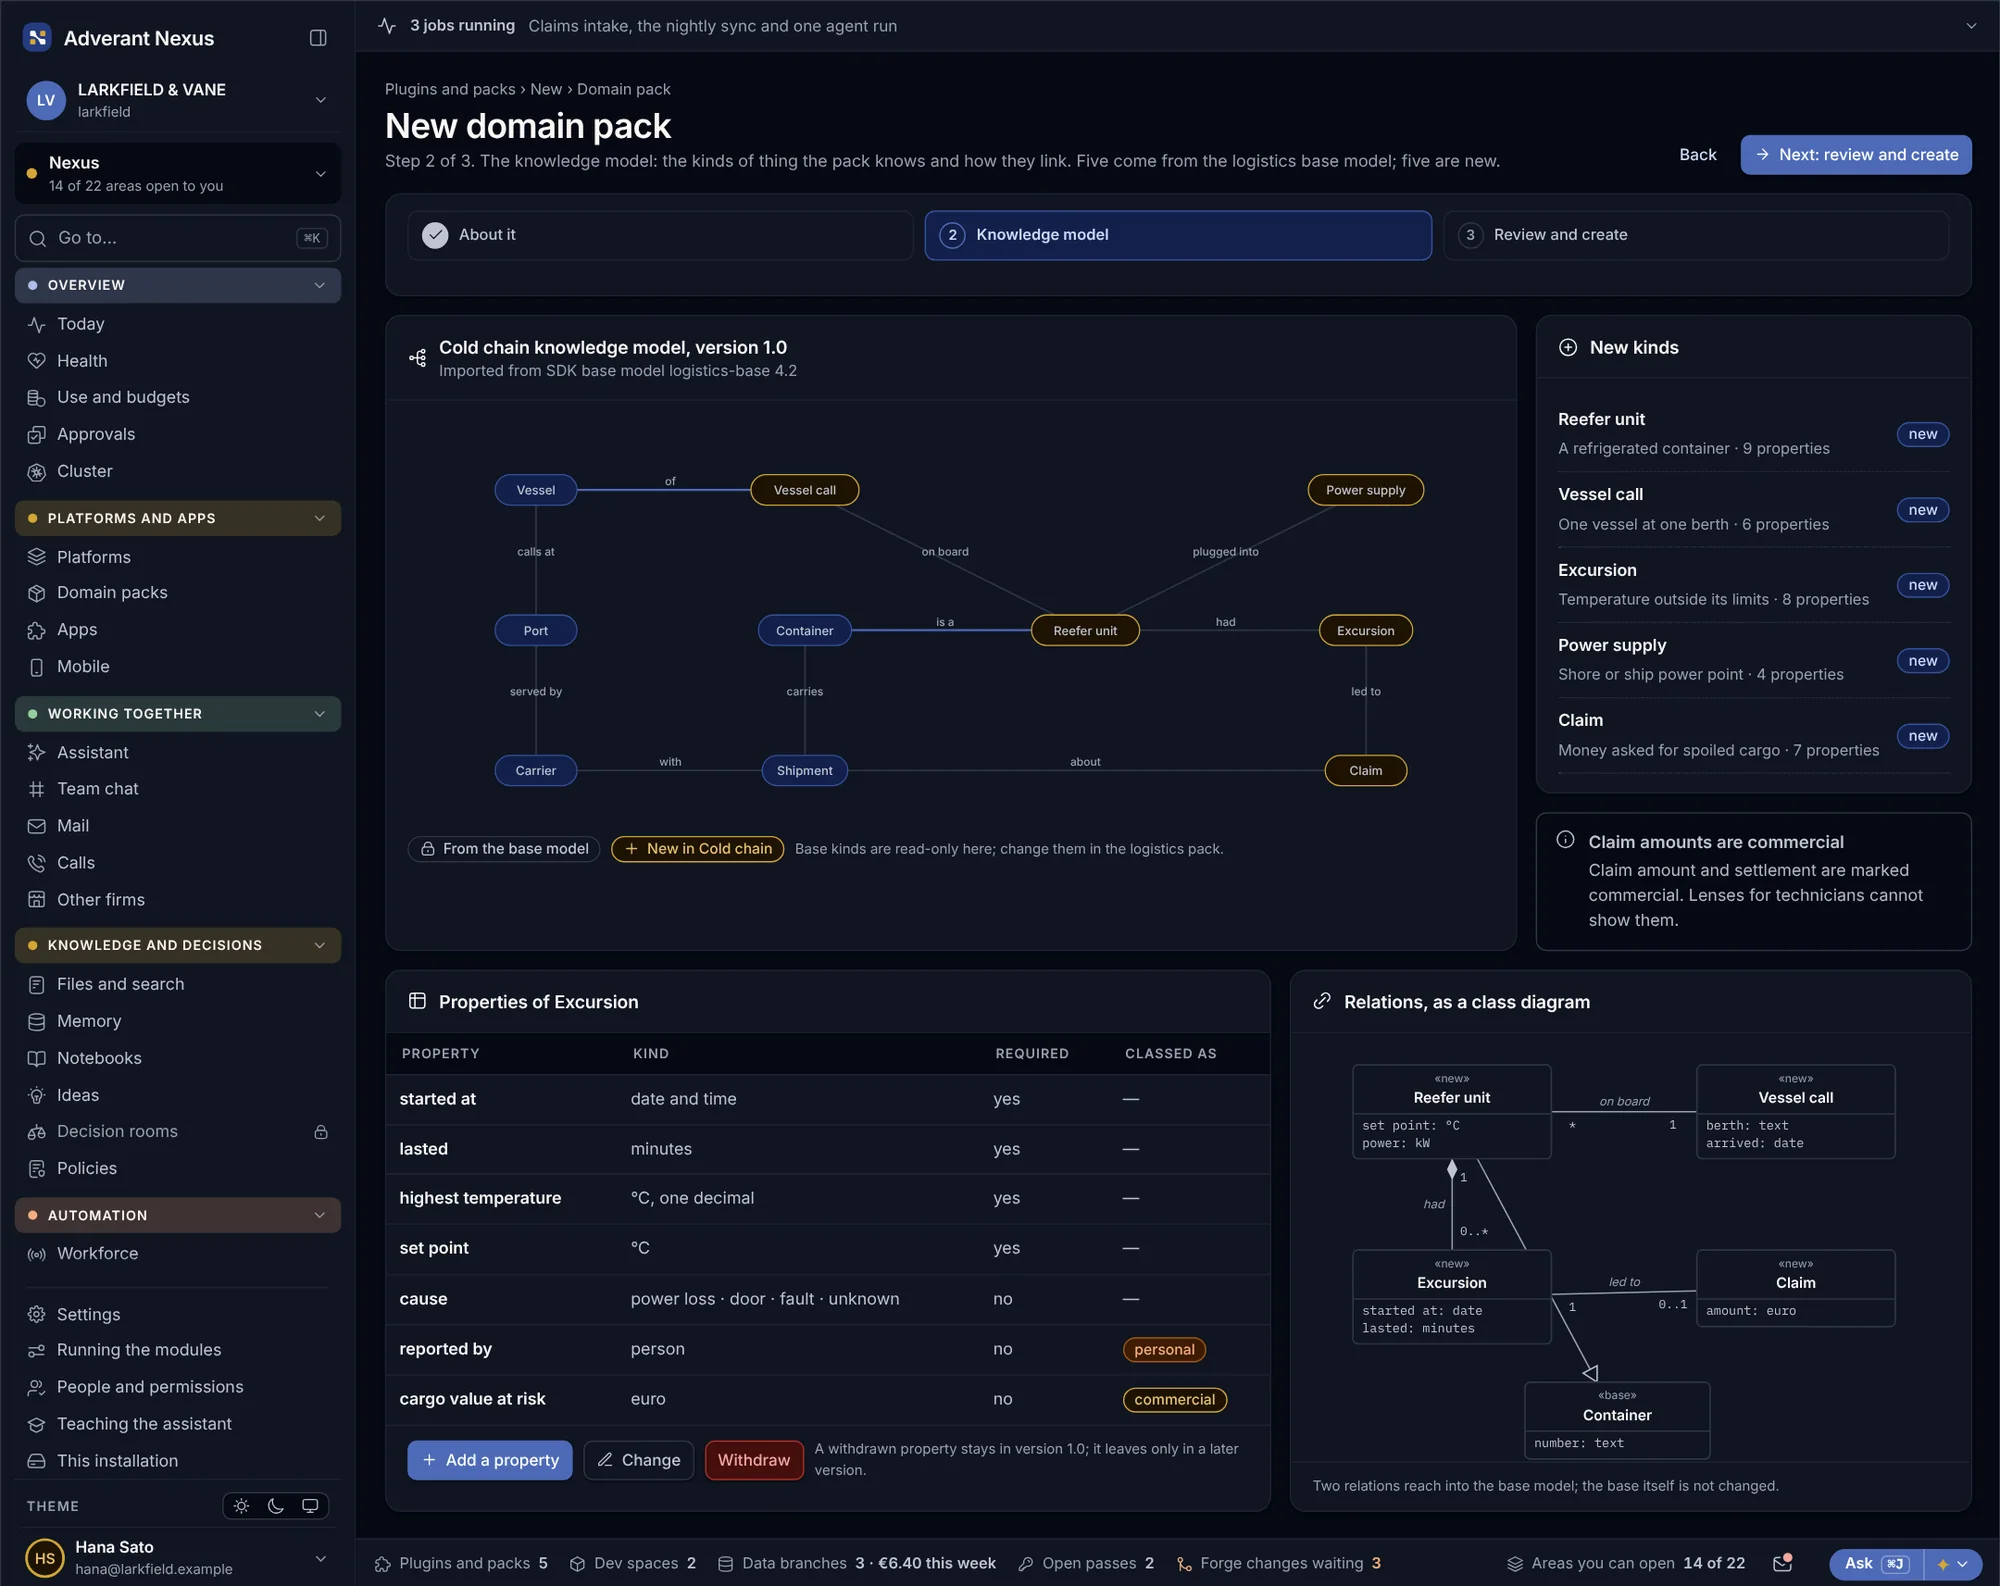
Het schema voor een domein
Voeg een nieuw type object toe aan het schema van een domein en kies welke lenzen het te zien krijgen.
- Soorten, eigenschappen en relaties op het scherm
- Lenzen bepalen wat elke rol ziet
- Elke wijziging krijgt een versie
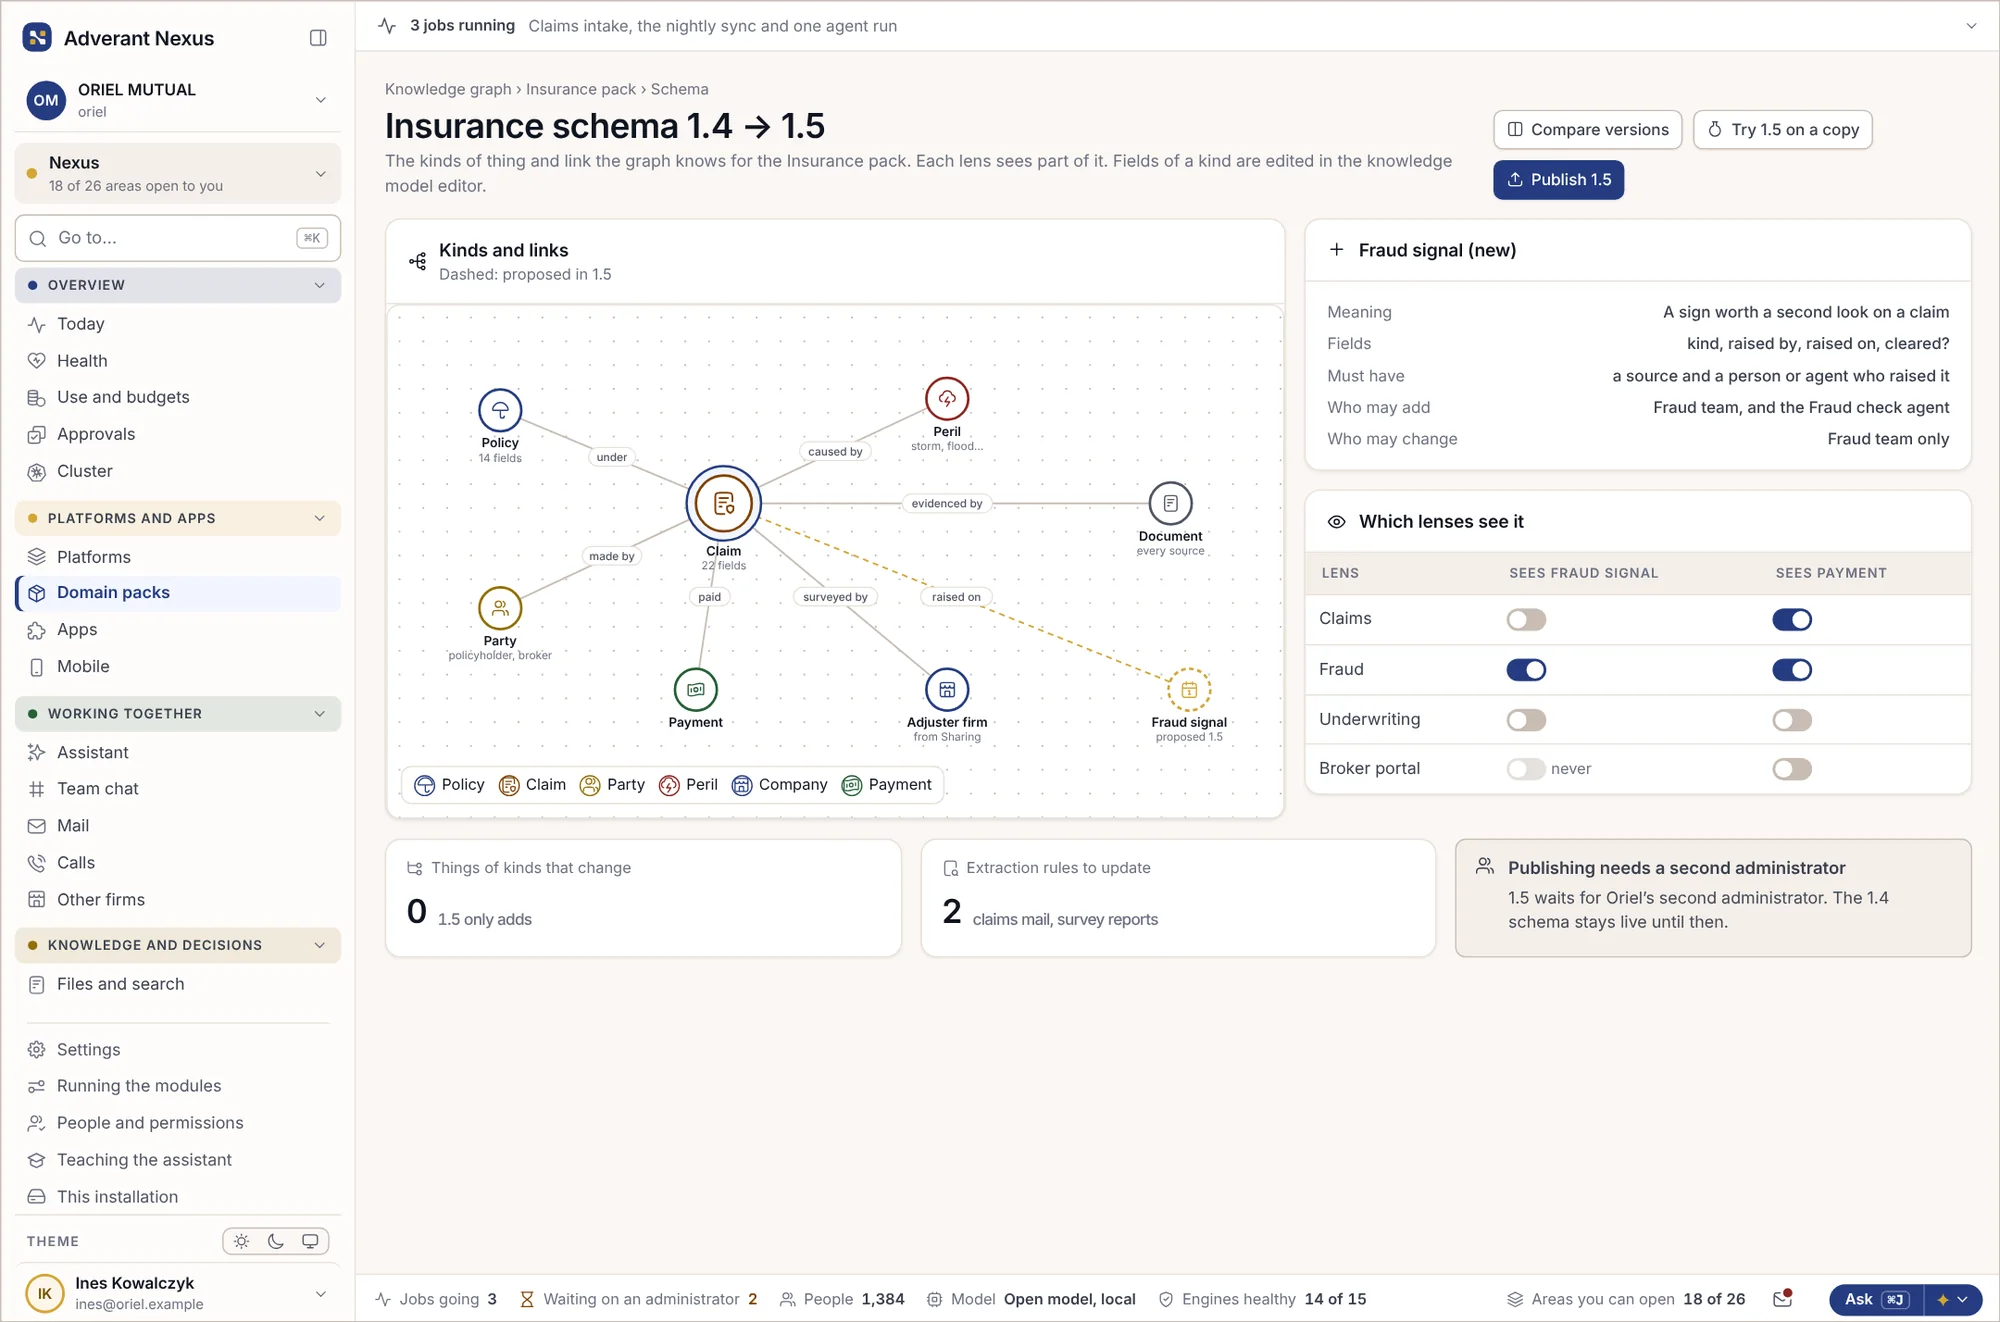
De kennis-modeleditor
Voeg een opzegtermijn toe aan contracten en zie welk dossier hierdoor wordt geraakt voordat de wijziging wordt doorgevoerd.
- Impact zichtbaar vóór het opslaan
- Omkeerbaar
- Beoordeeld als code
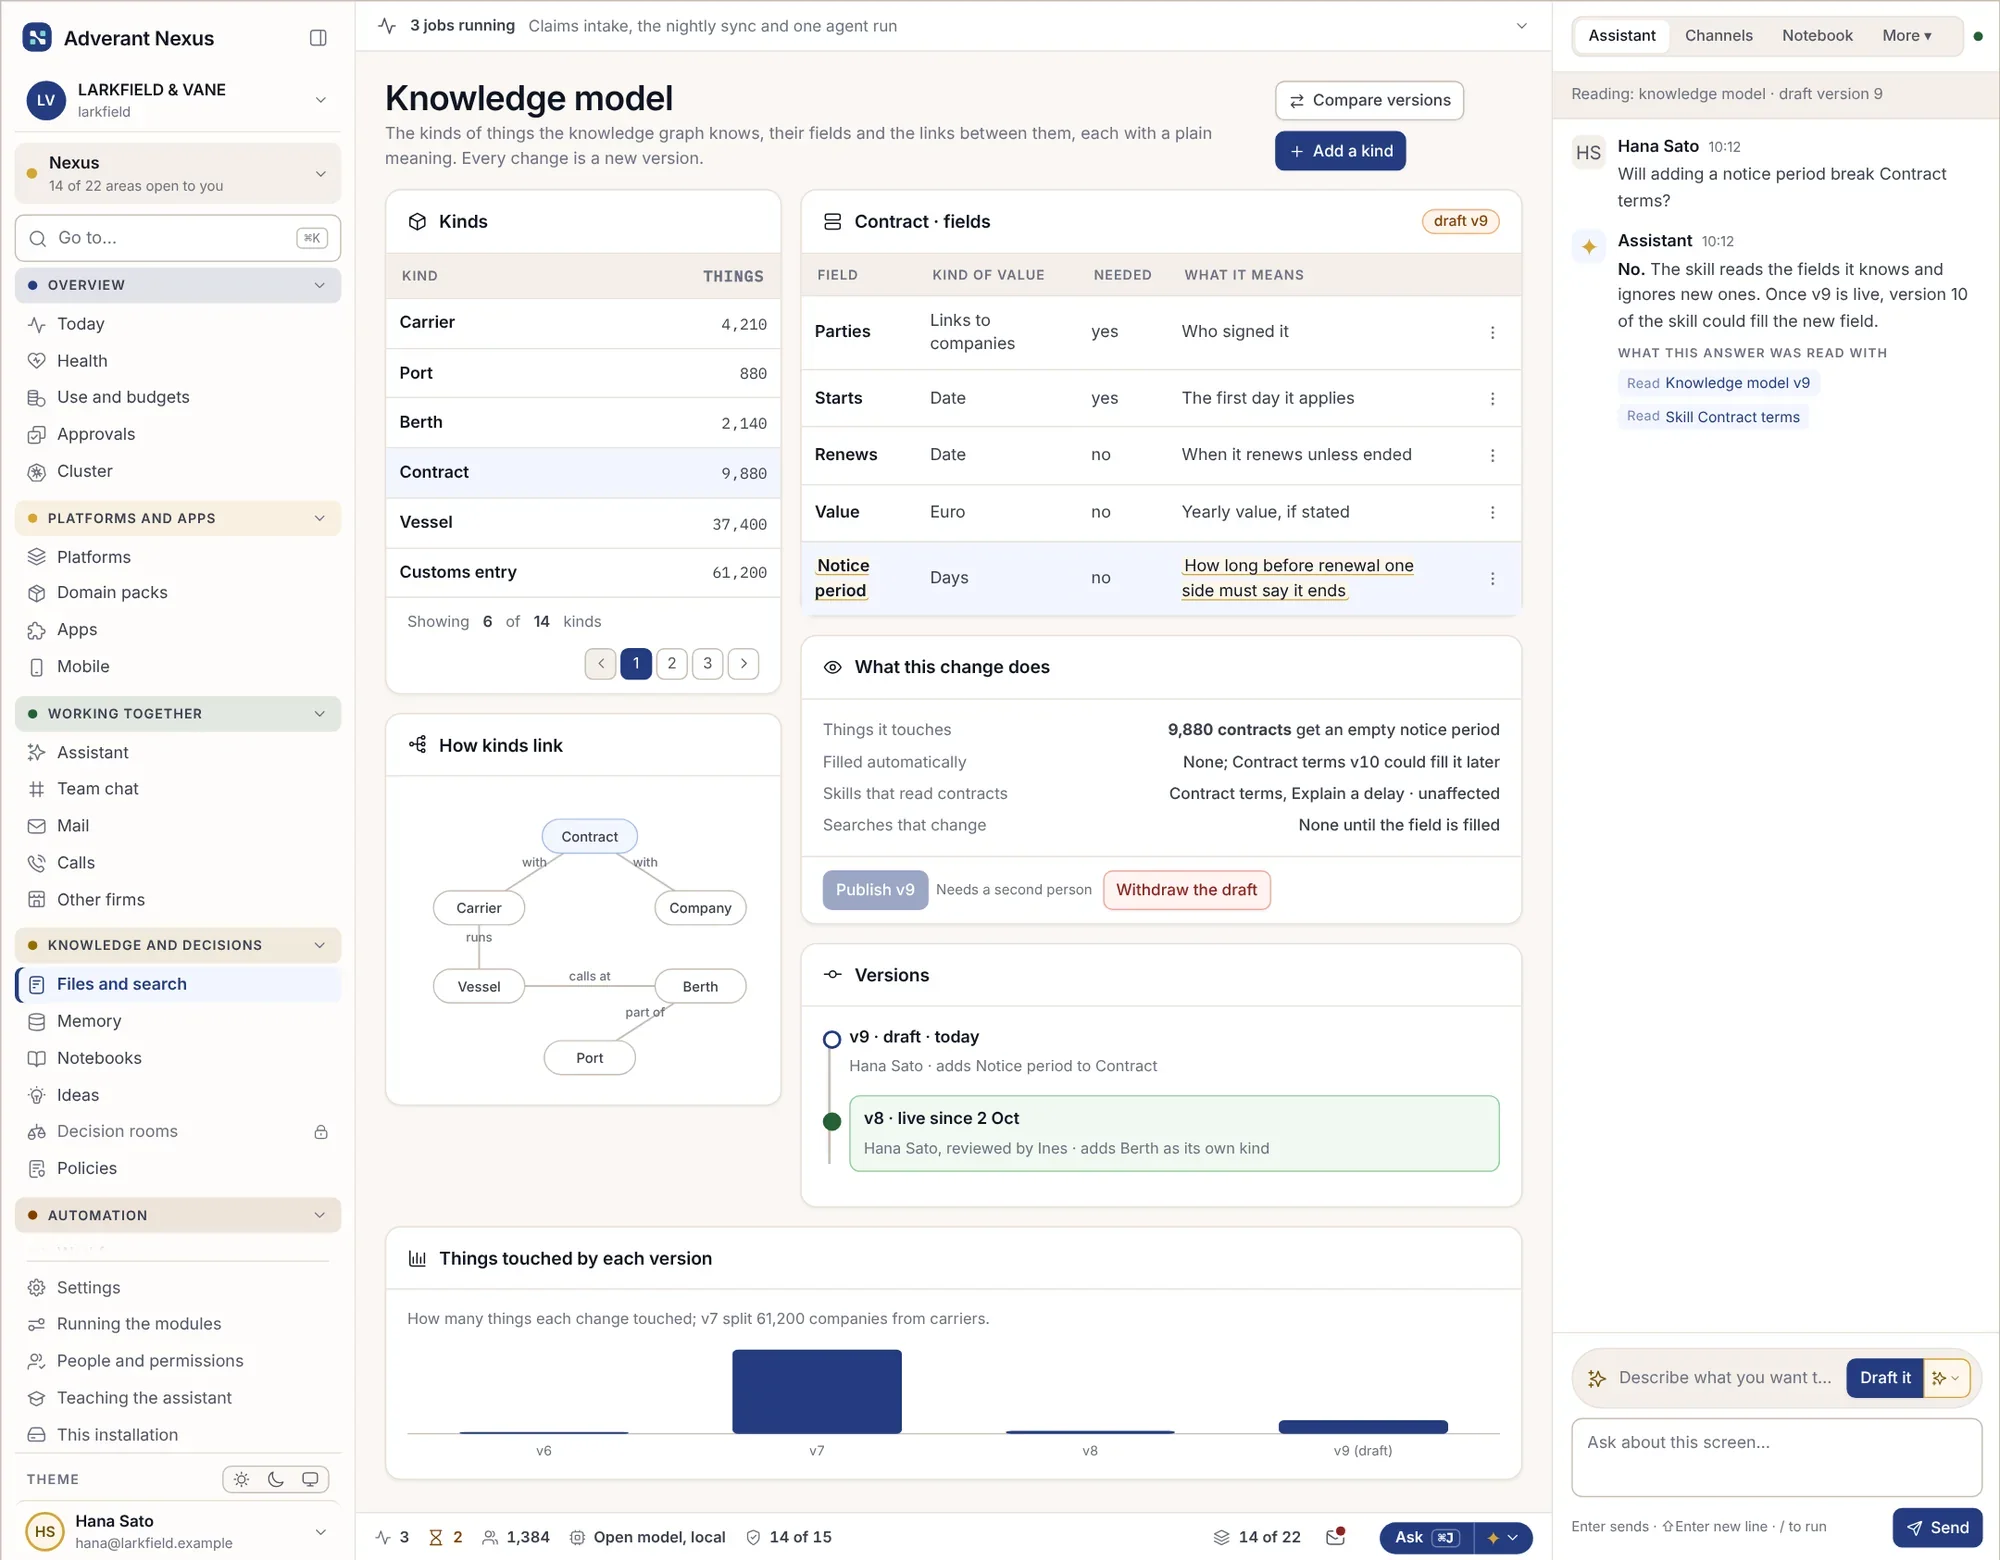
Start vanuit een sectormodel
Domeinpakketten leveren een basismodel. Voeg daar de typen objecten aan toe die alleen uw bedrijf kent.
- Basismodellen voor elke sector
- Uw eigen typen erbovenop
- Upgrades behouden uw toevoegingen
Wijzig het model veilig
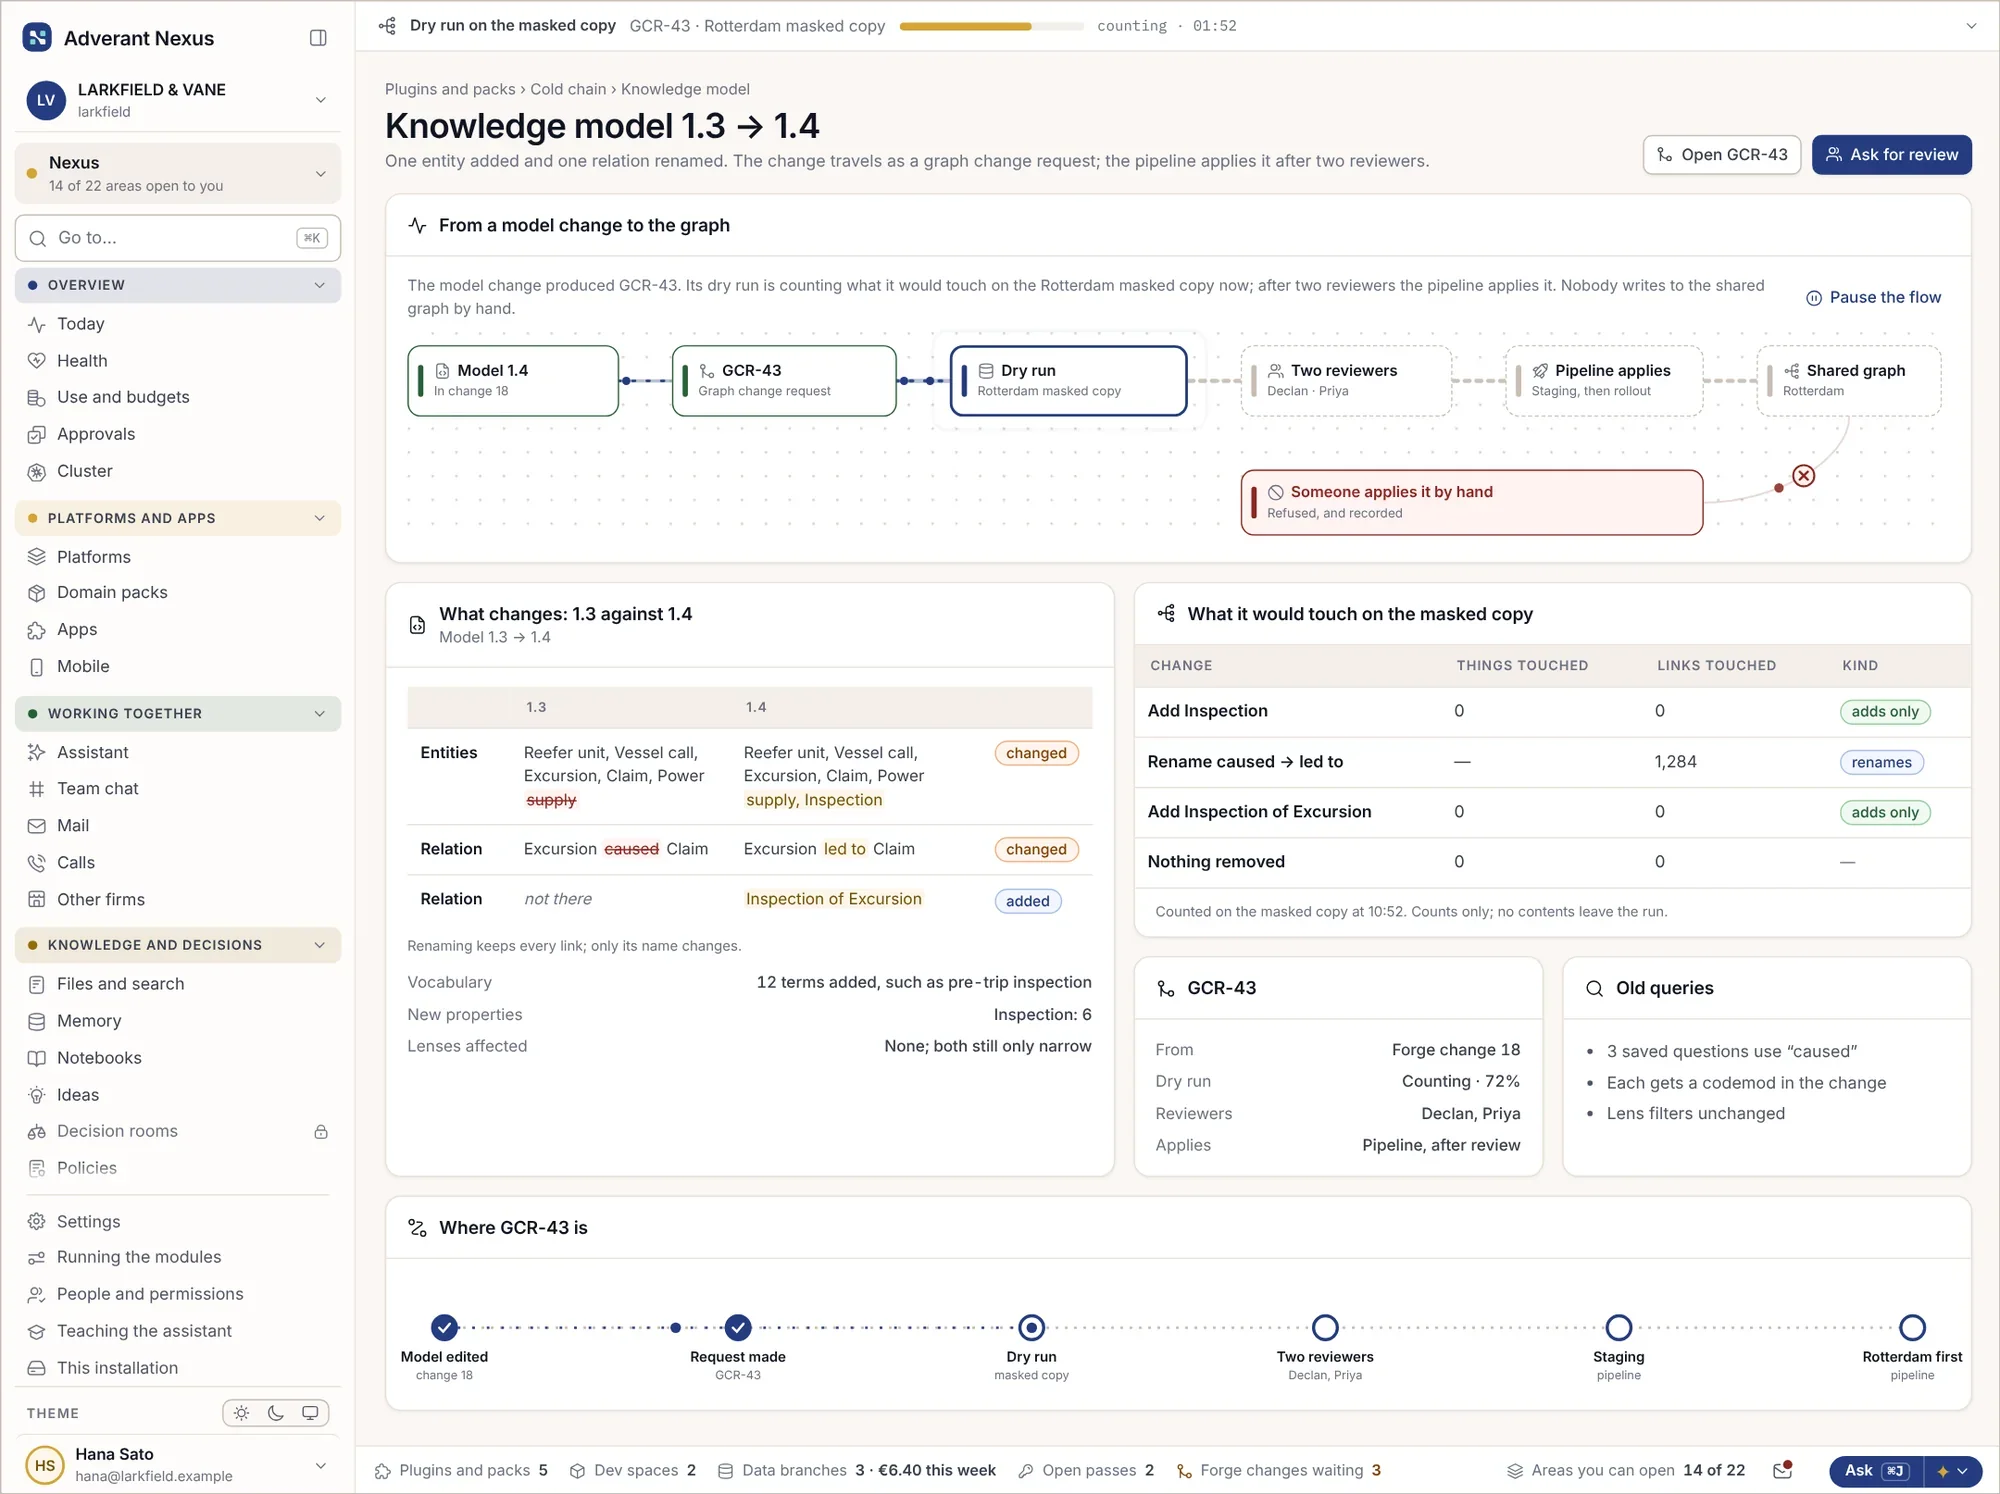
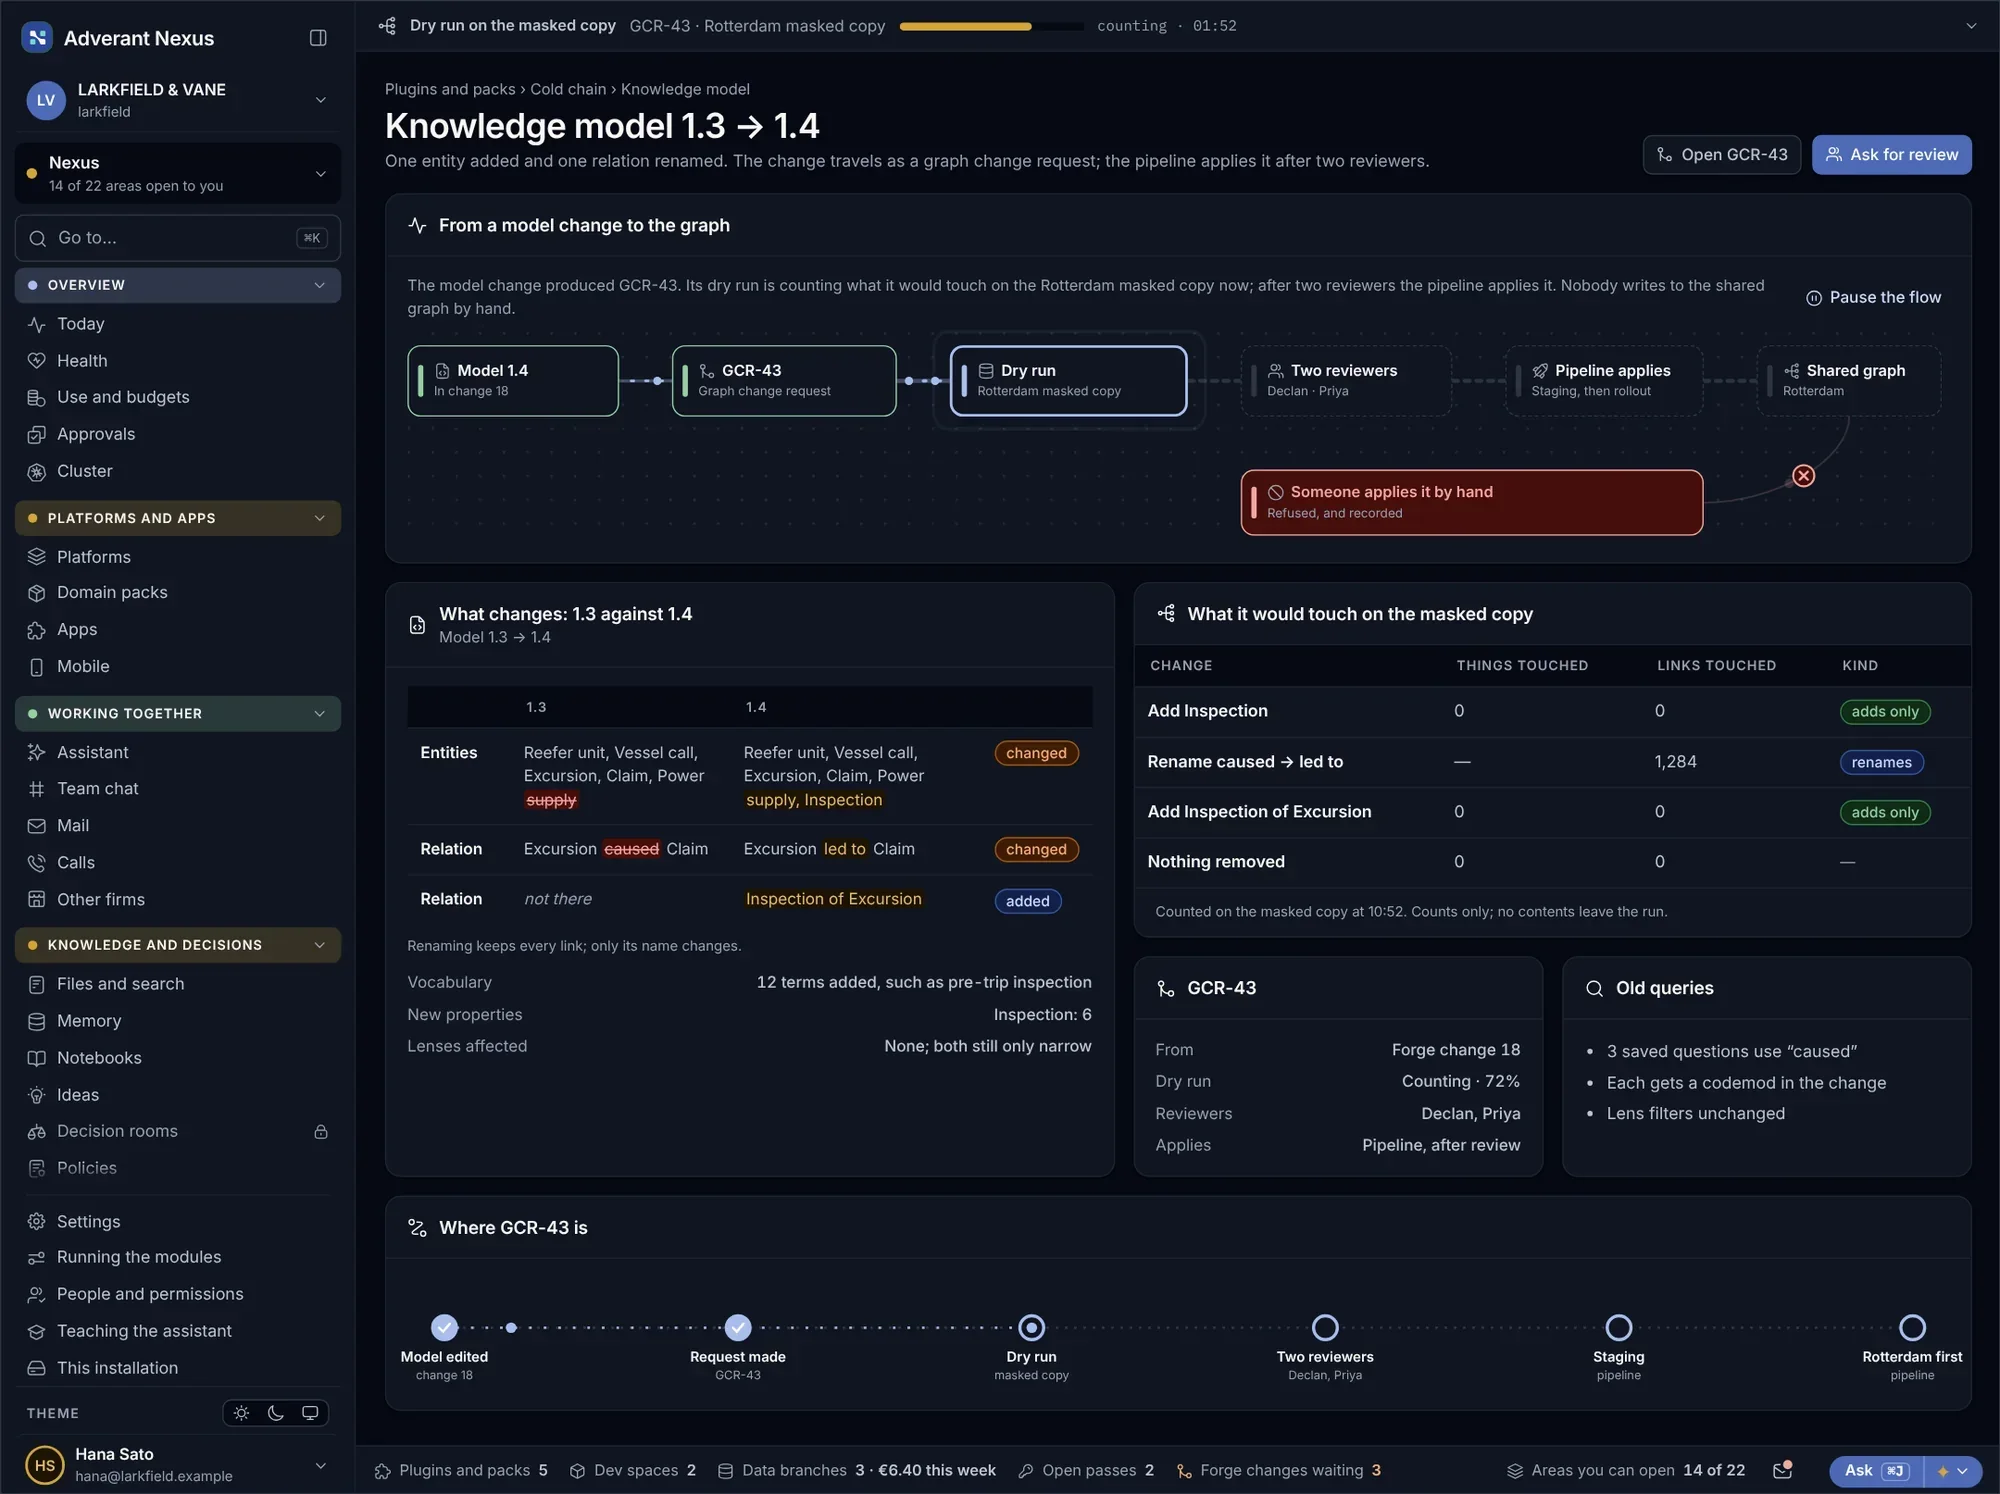
- Versies naast elkaar vergeleken
- Proefdraaien op een gemaskeerde kopie
- Voor elke wijziging een weg terug
Gevuld vanuit uw documenten en systemen, tussentijds gecontroleerd.
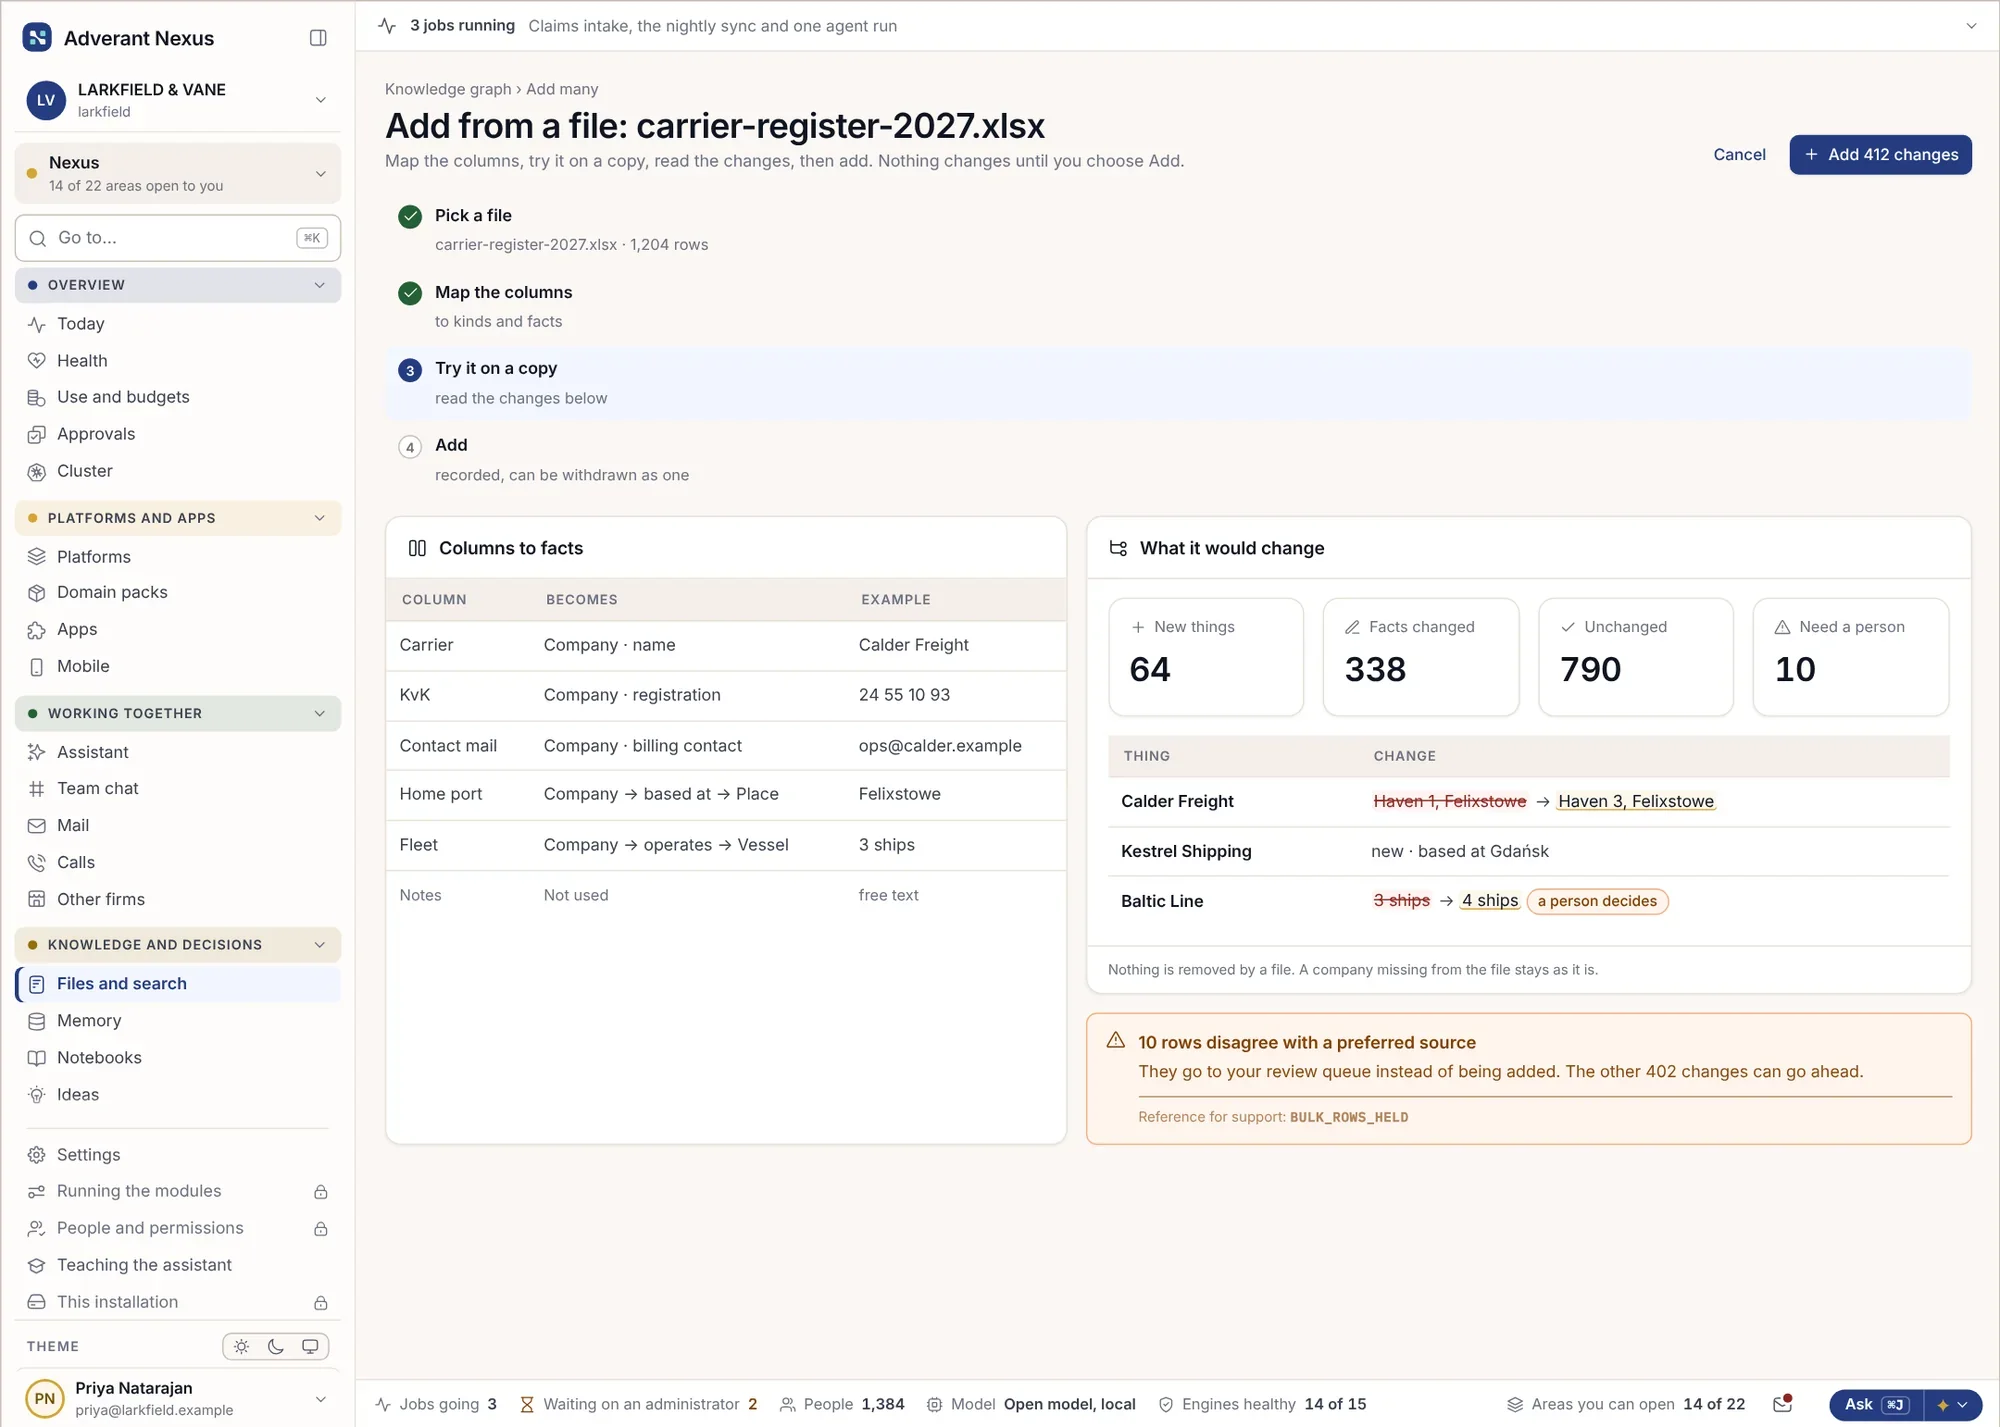
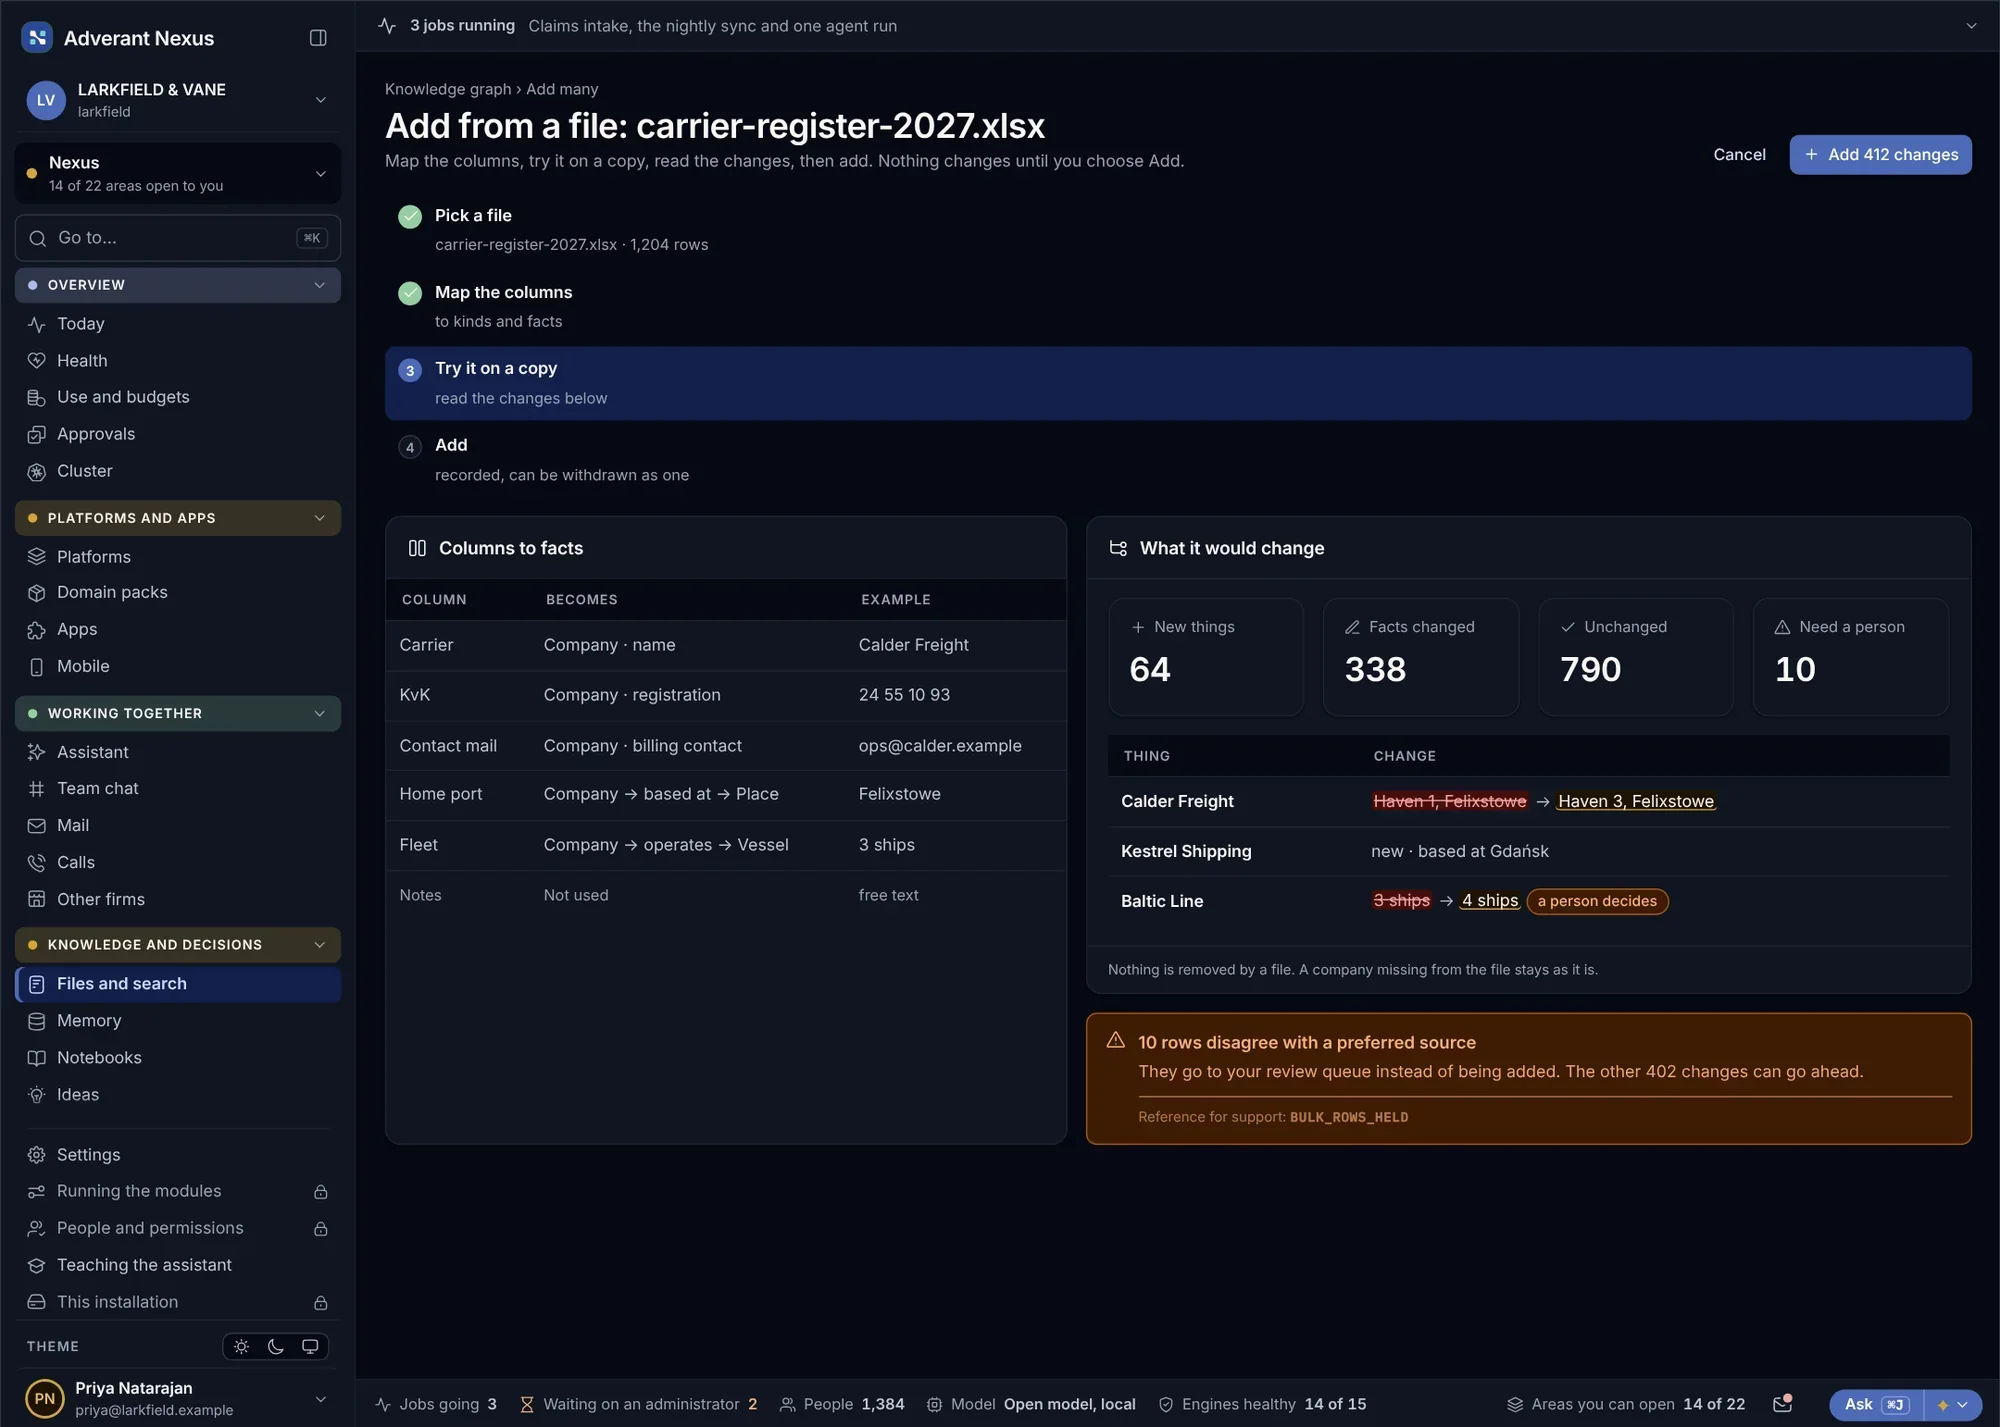
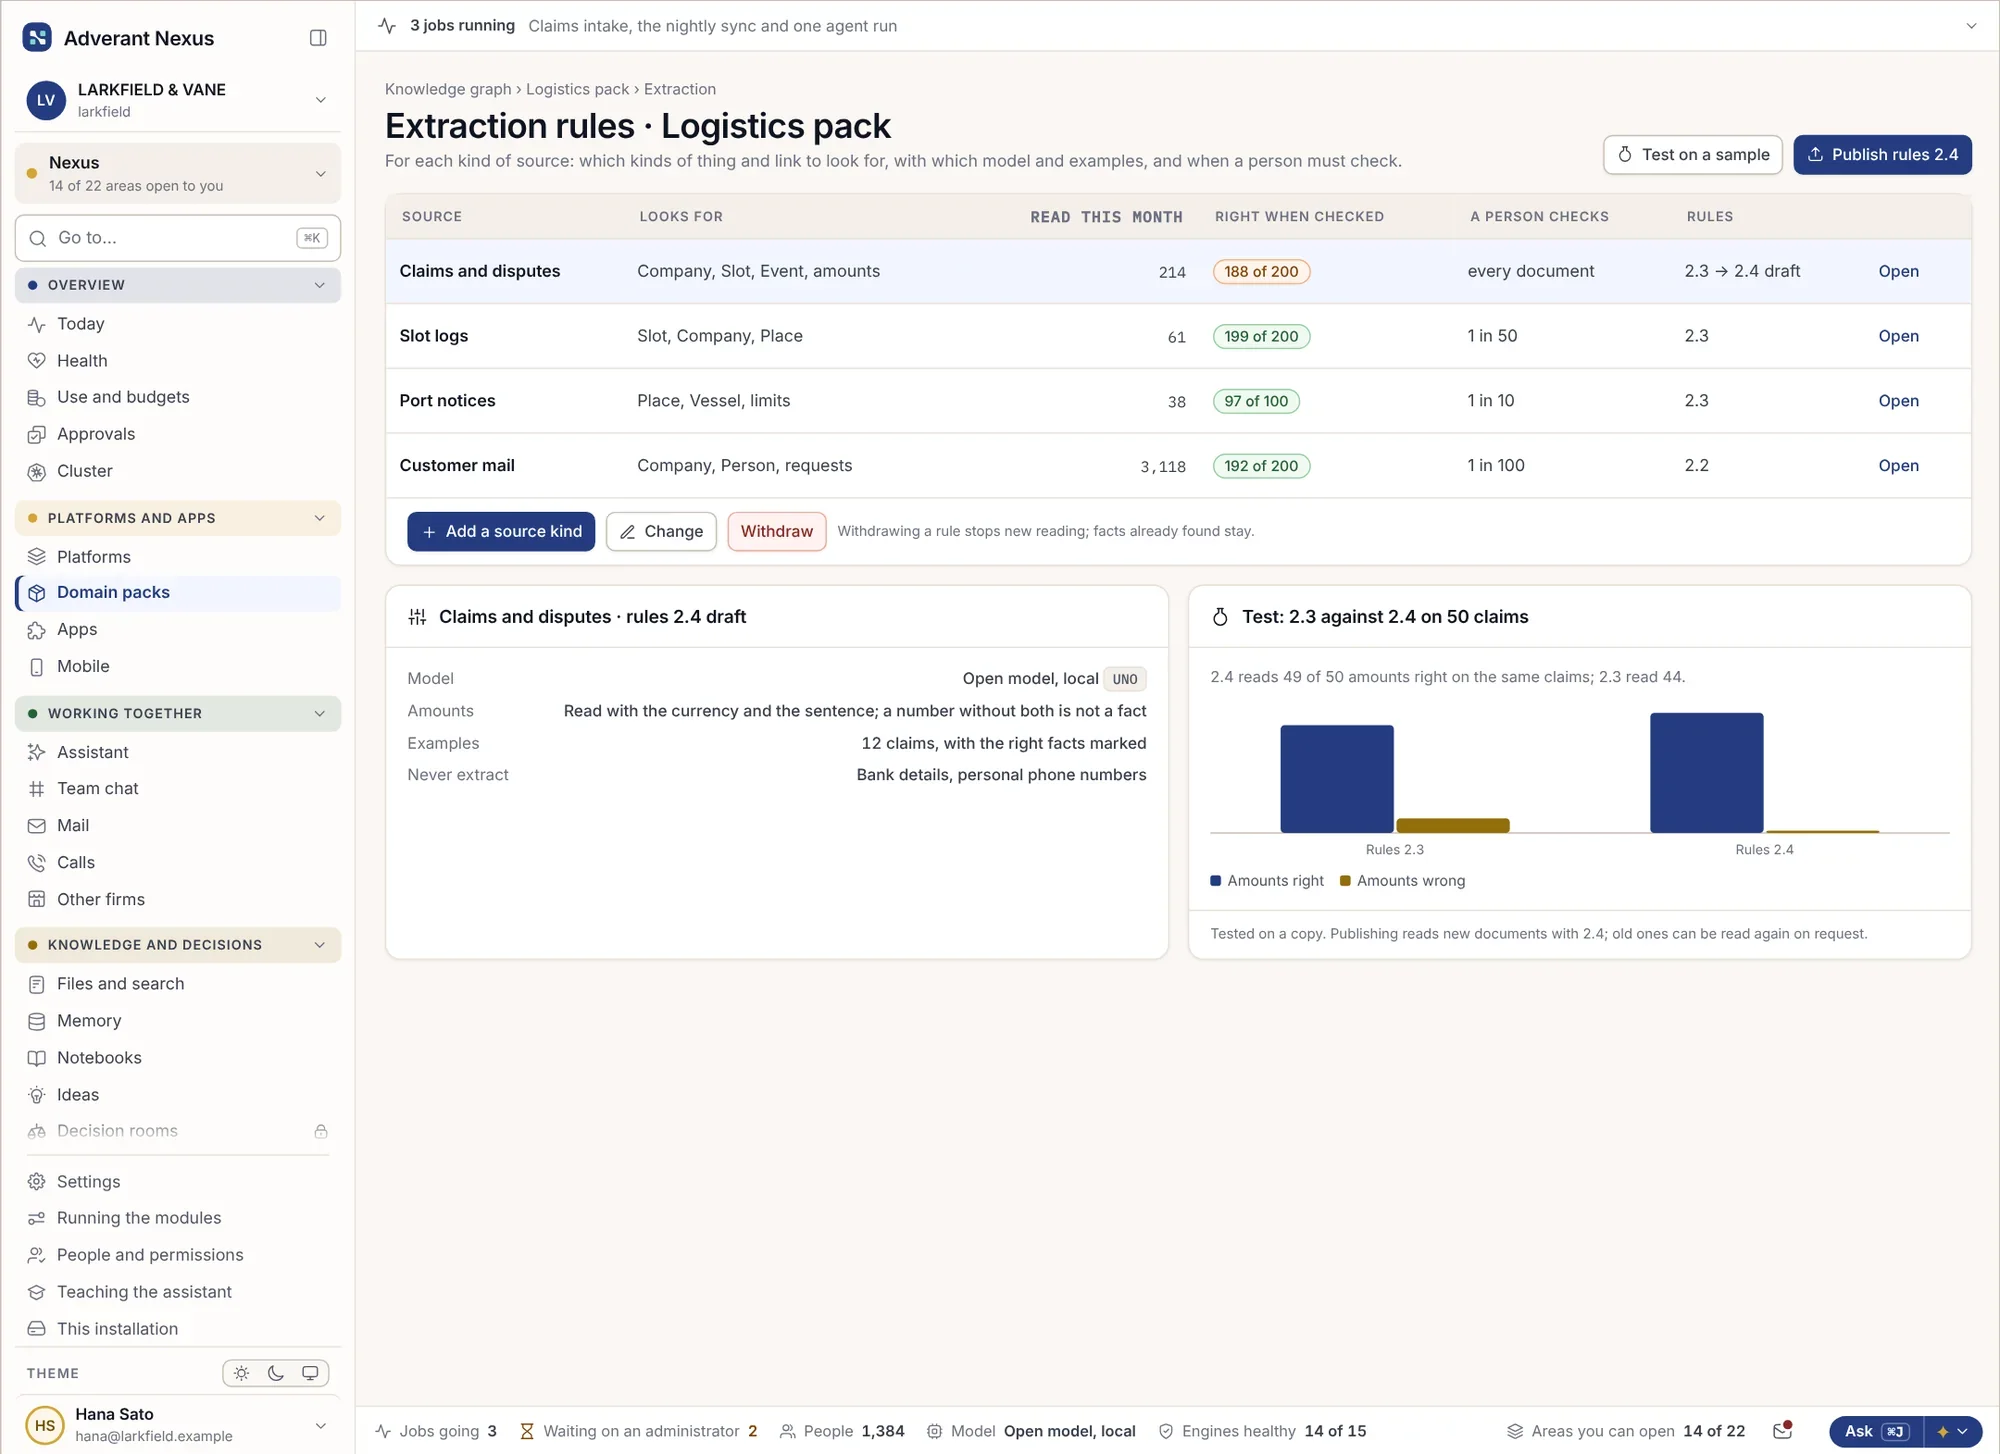
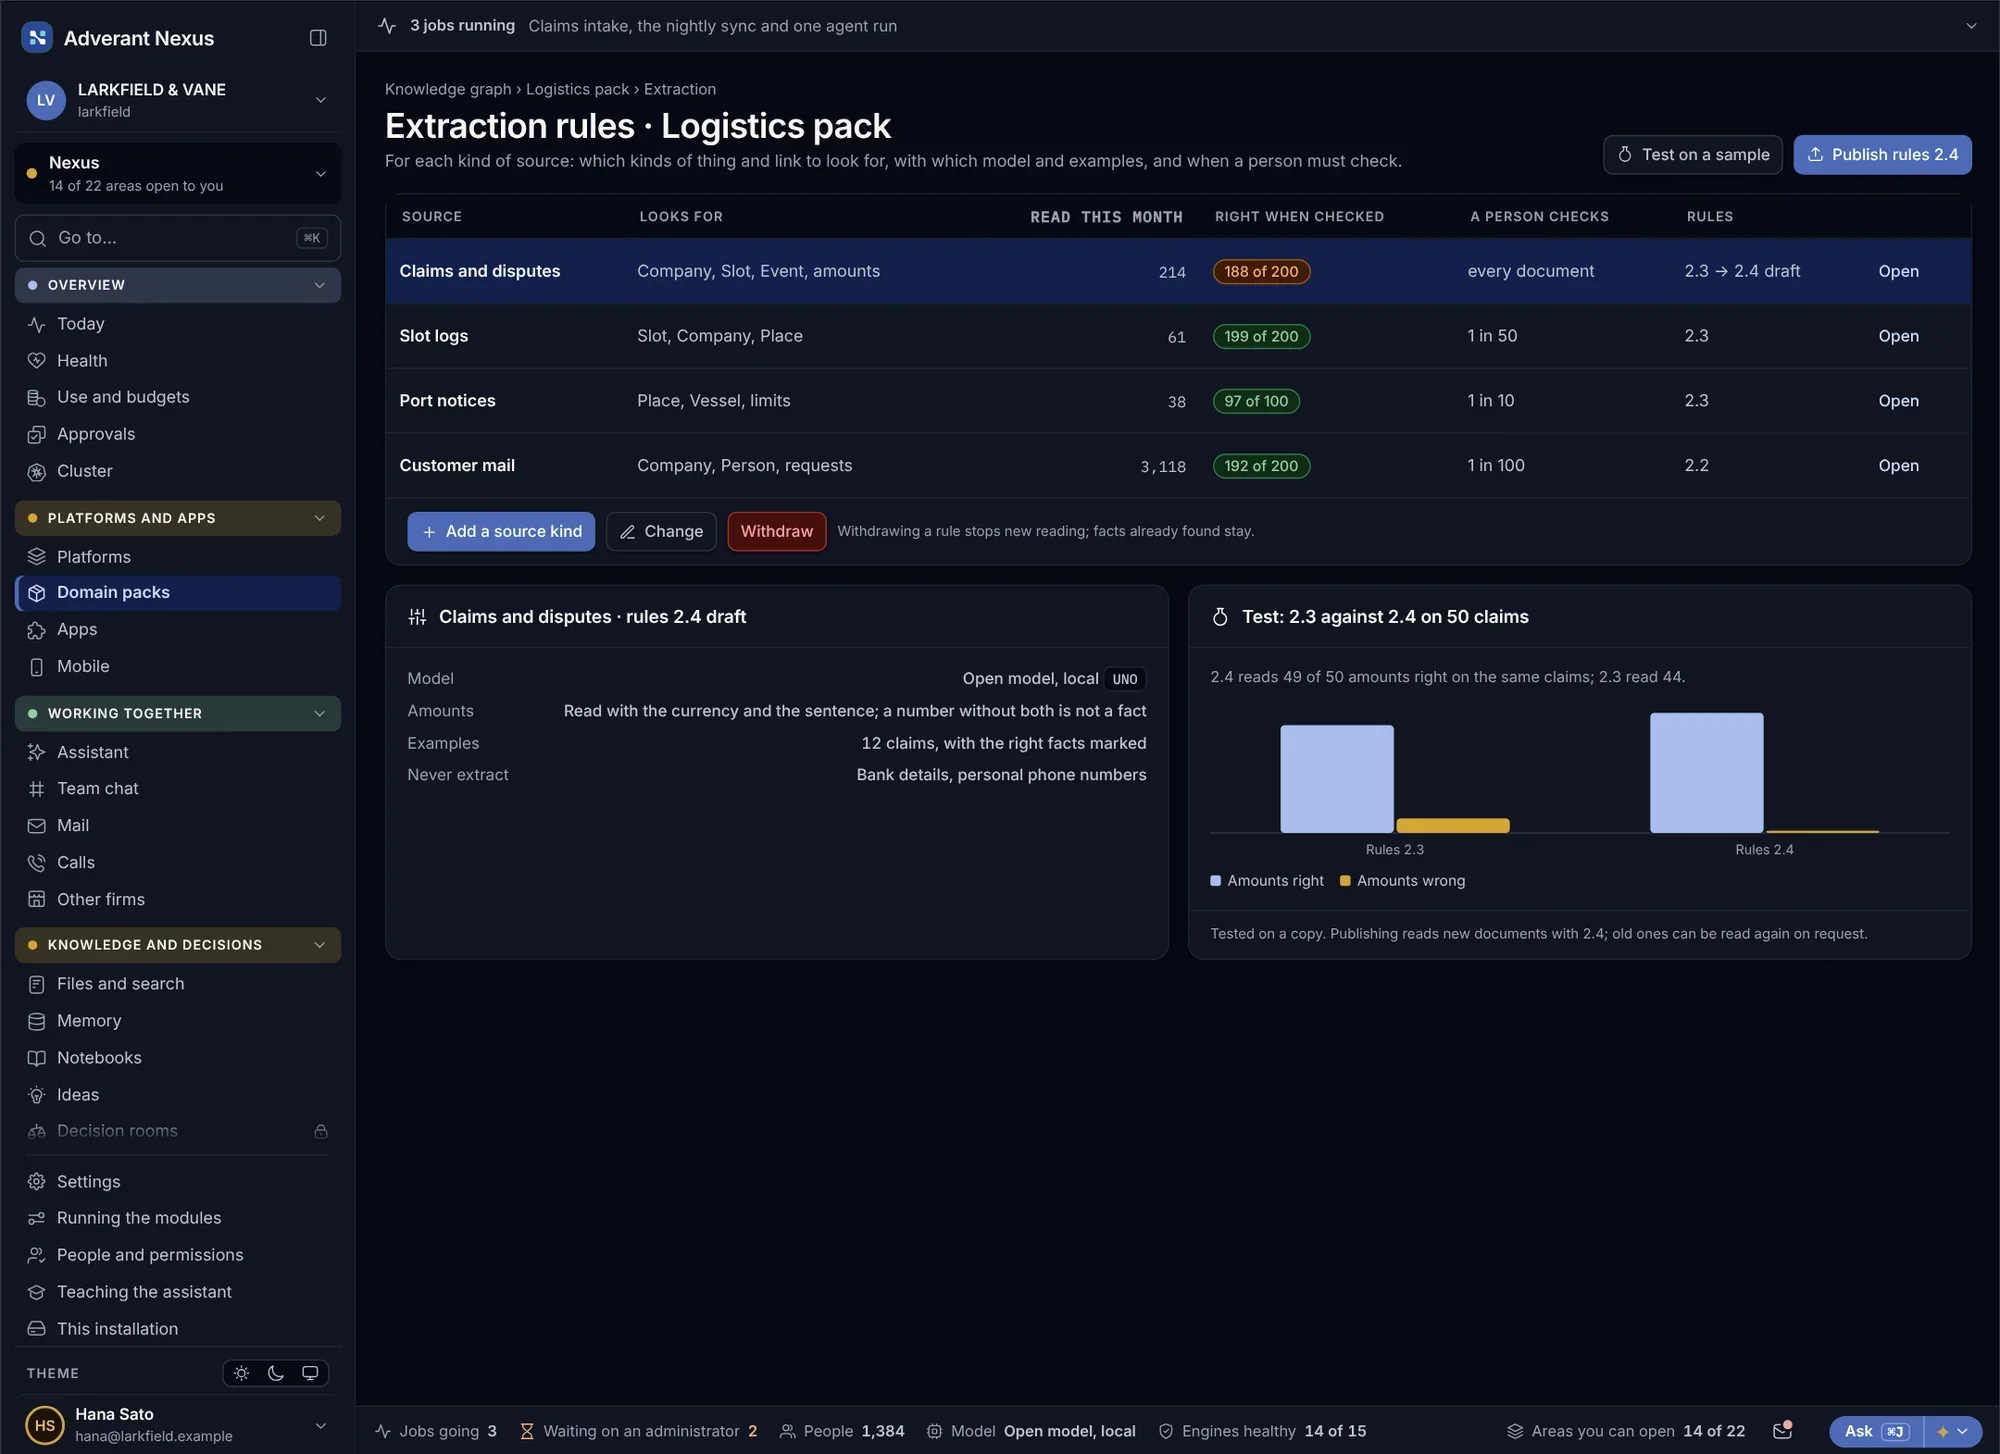
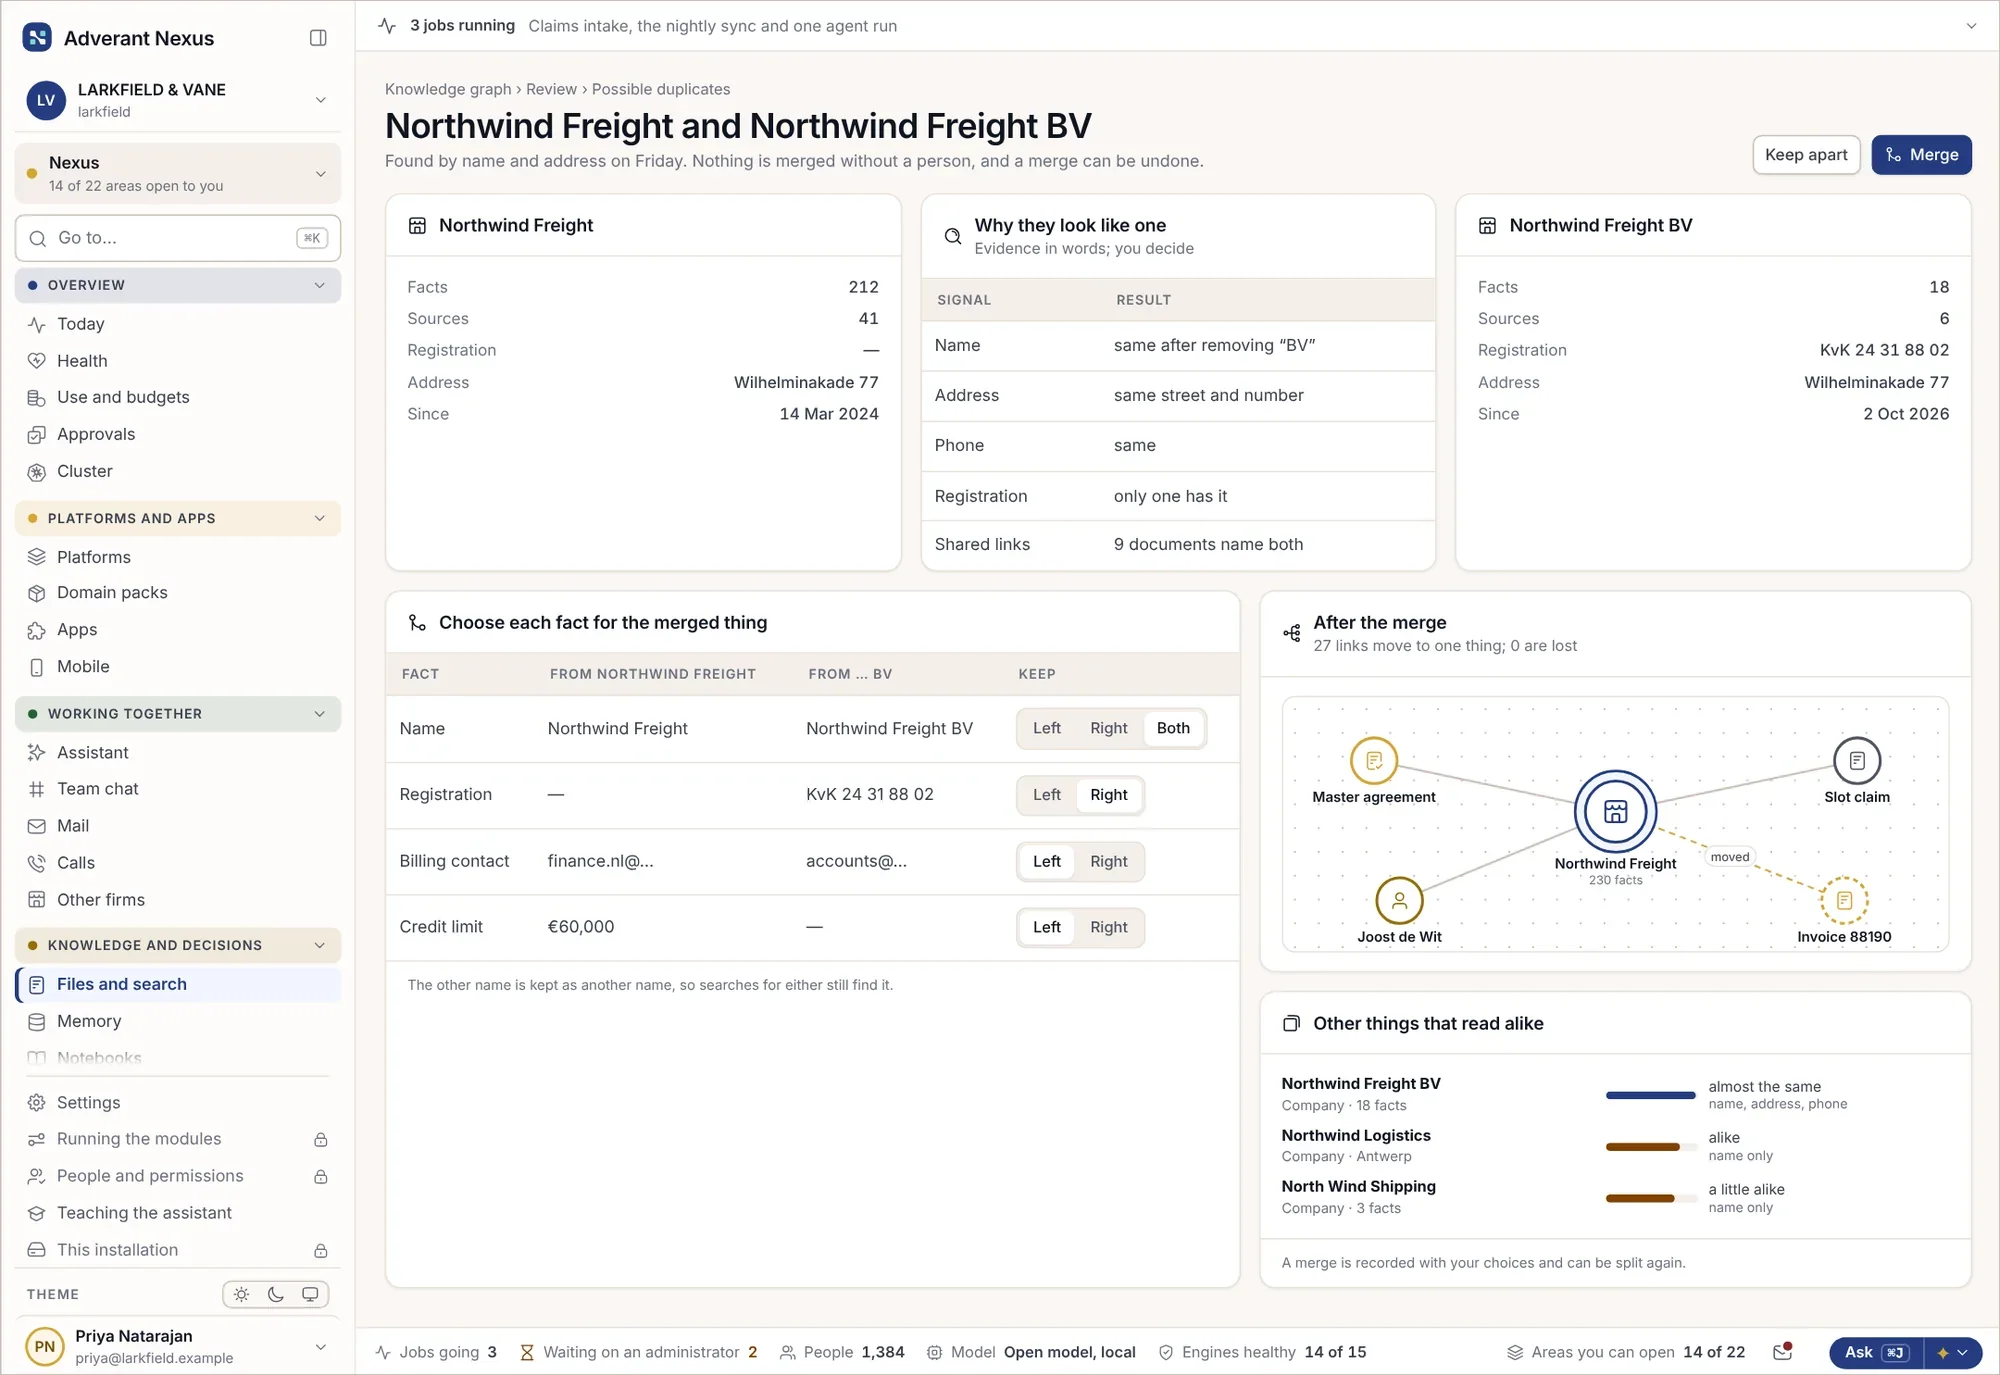
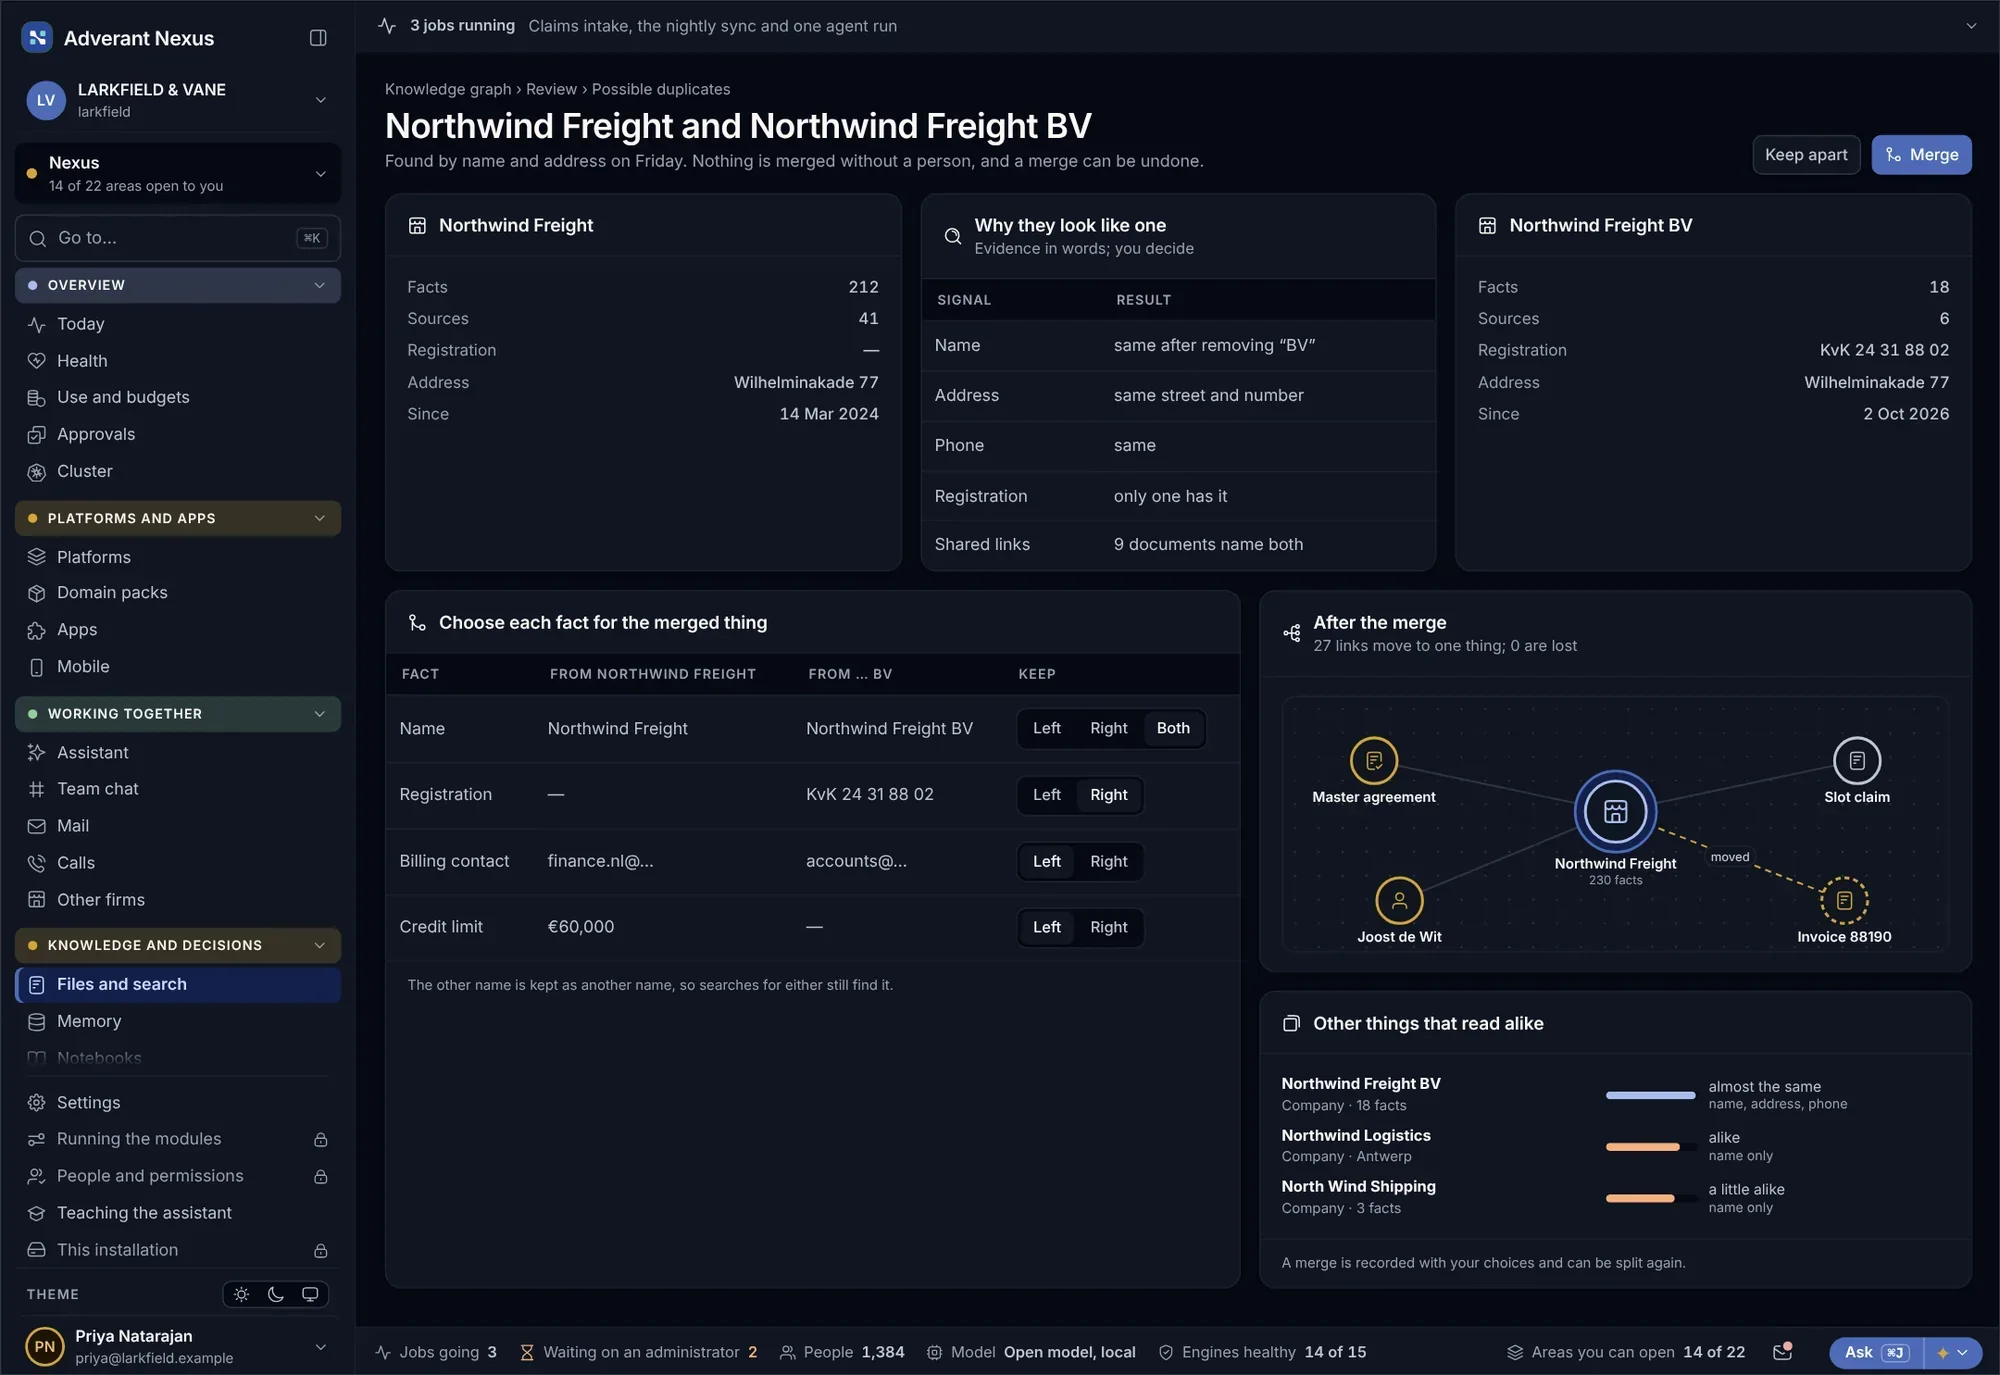
Feiten worden uit documenten gehaald en geladen vanuit registers en databases. Extractieregels worden getest voordat ze iets wijzigen, grote laadsessies tonen hun effect voordat ze draaien en bij dubbelingen wacht het systeem op het oordeel van een medewerker.
Veel tegelijk toevoegen
- Gecontroleerd vóór het laden
- Duplicaten afgevangen
- Ongedaan gemaakt bij fouten
Extractieregels
- Regels per documenttype
- Getest op steekproeven
- Daarna toegepast
Twee keer hetzelfde
- Bewijsstukken naast elkaar
- Samengevoegd of gescheiden gehouden door een persoon
- Weer gesplitst als het niet klopt
Zoek alles op en zie waar het vandaan komt.
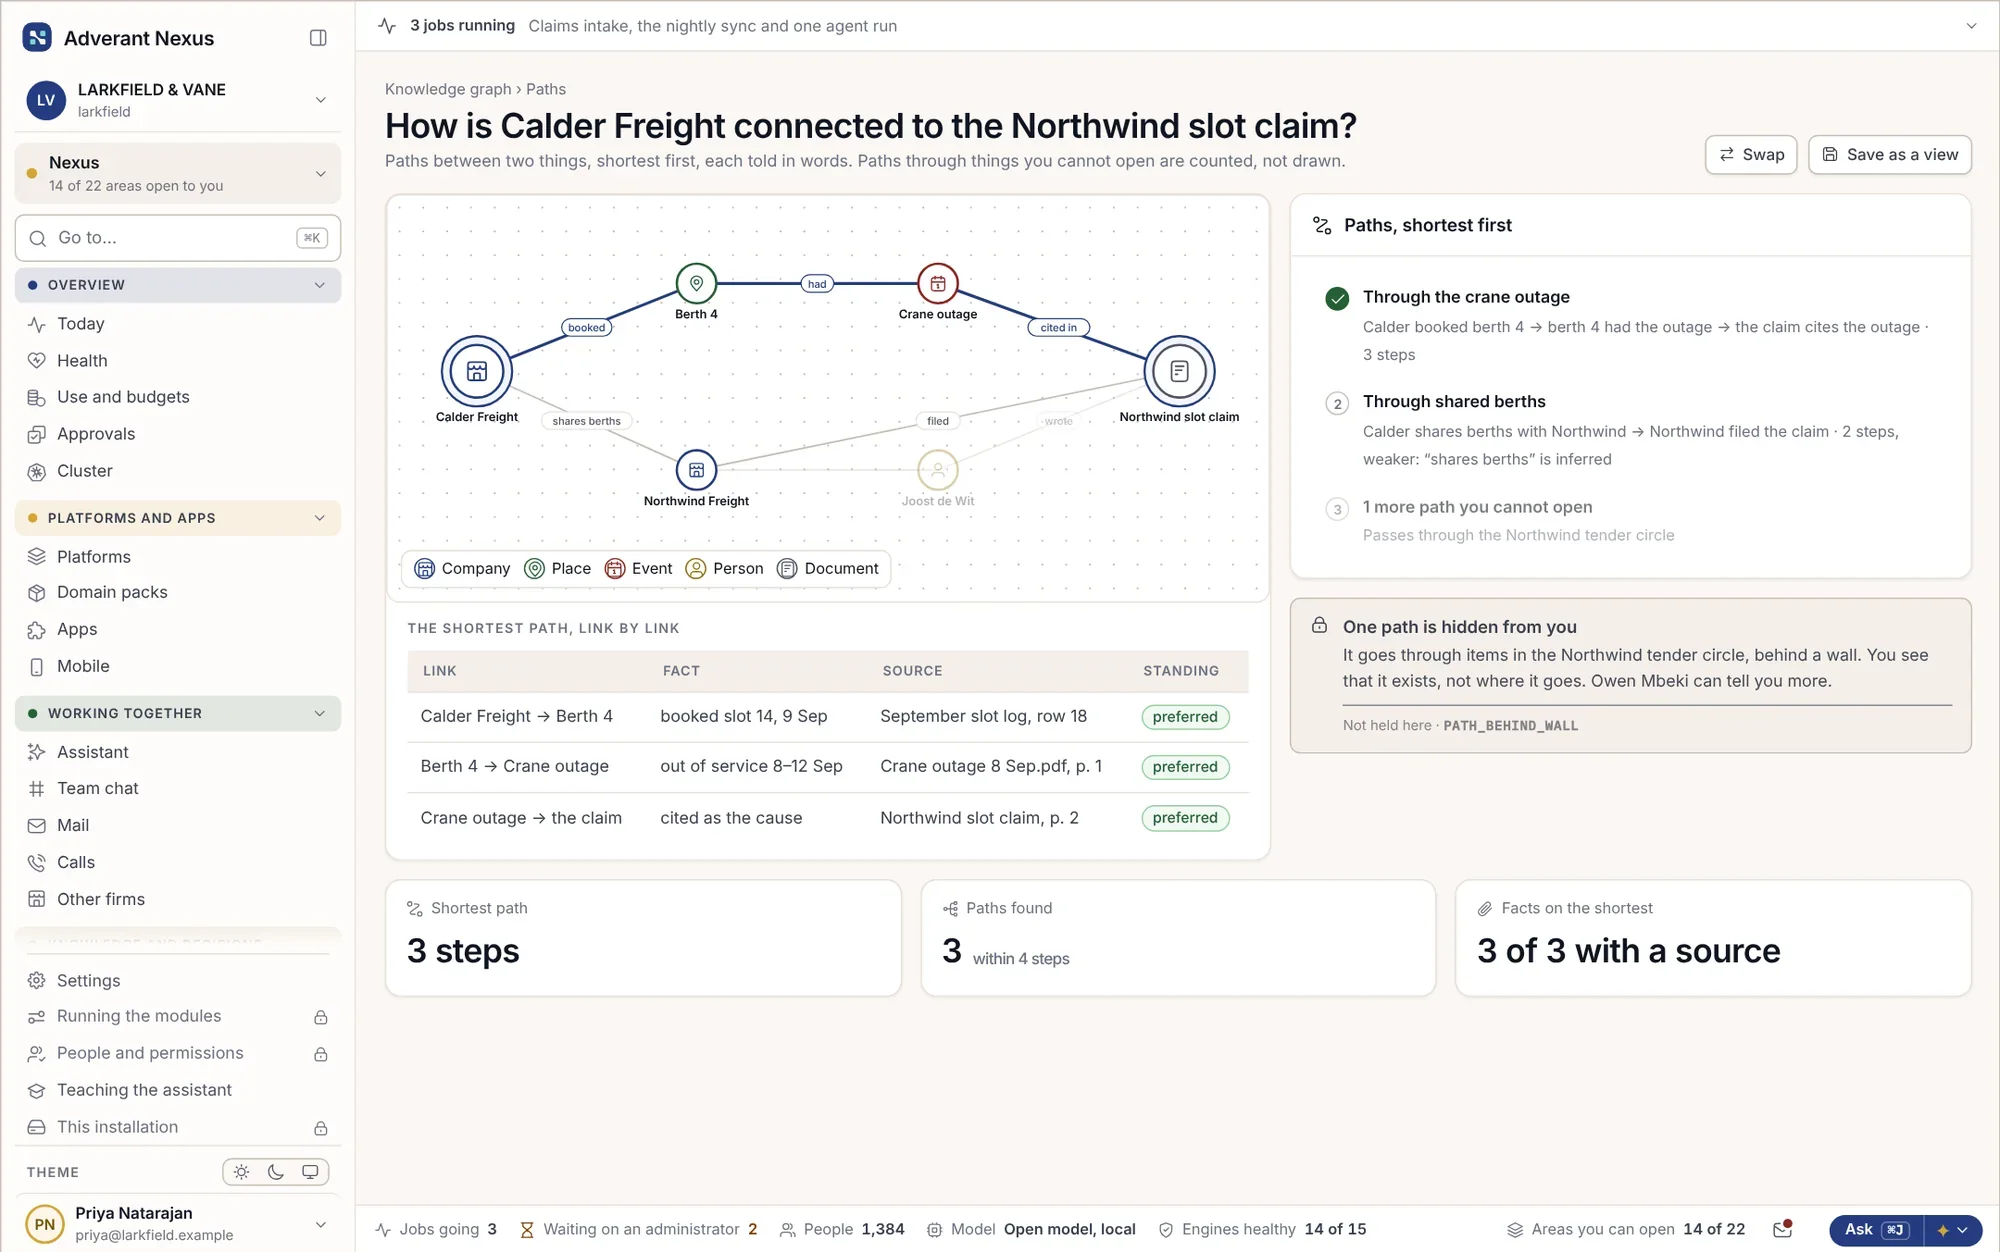
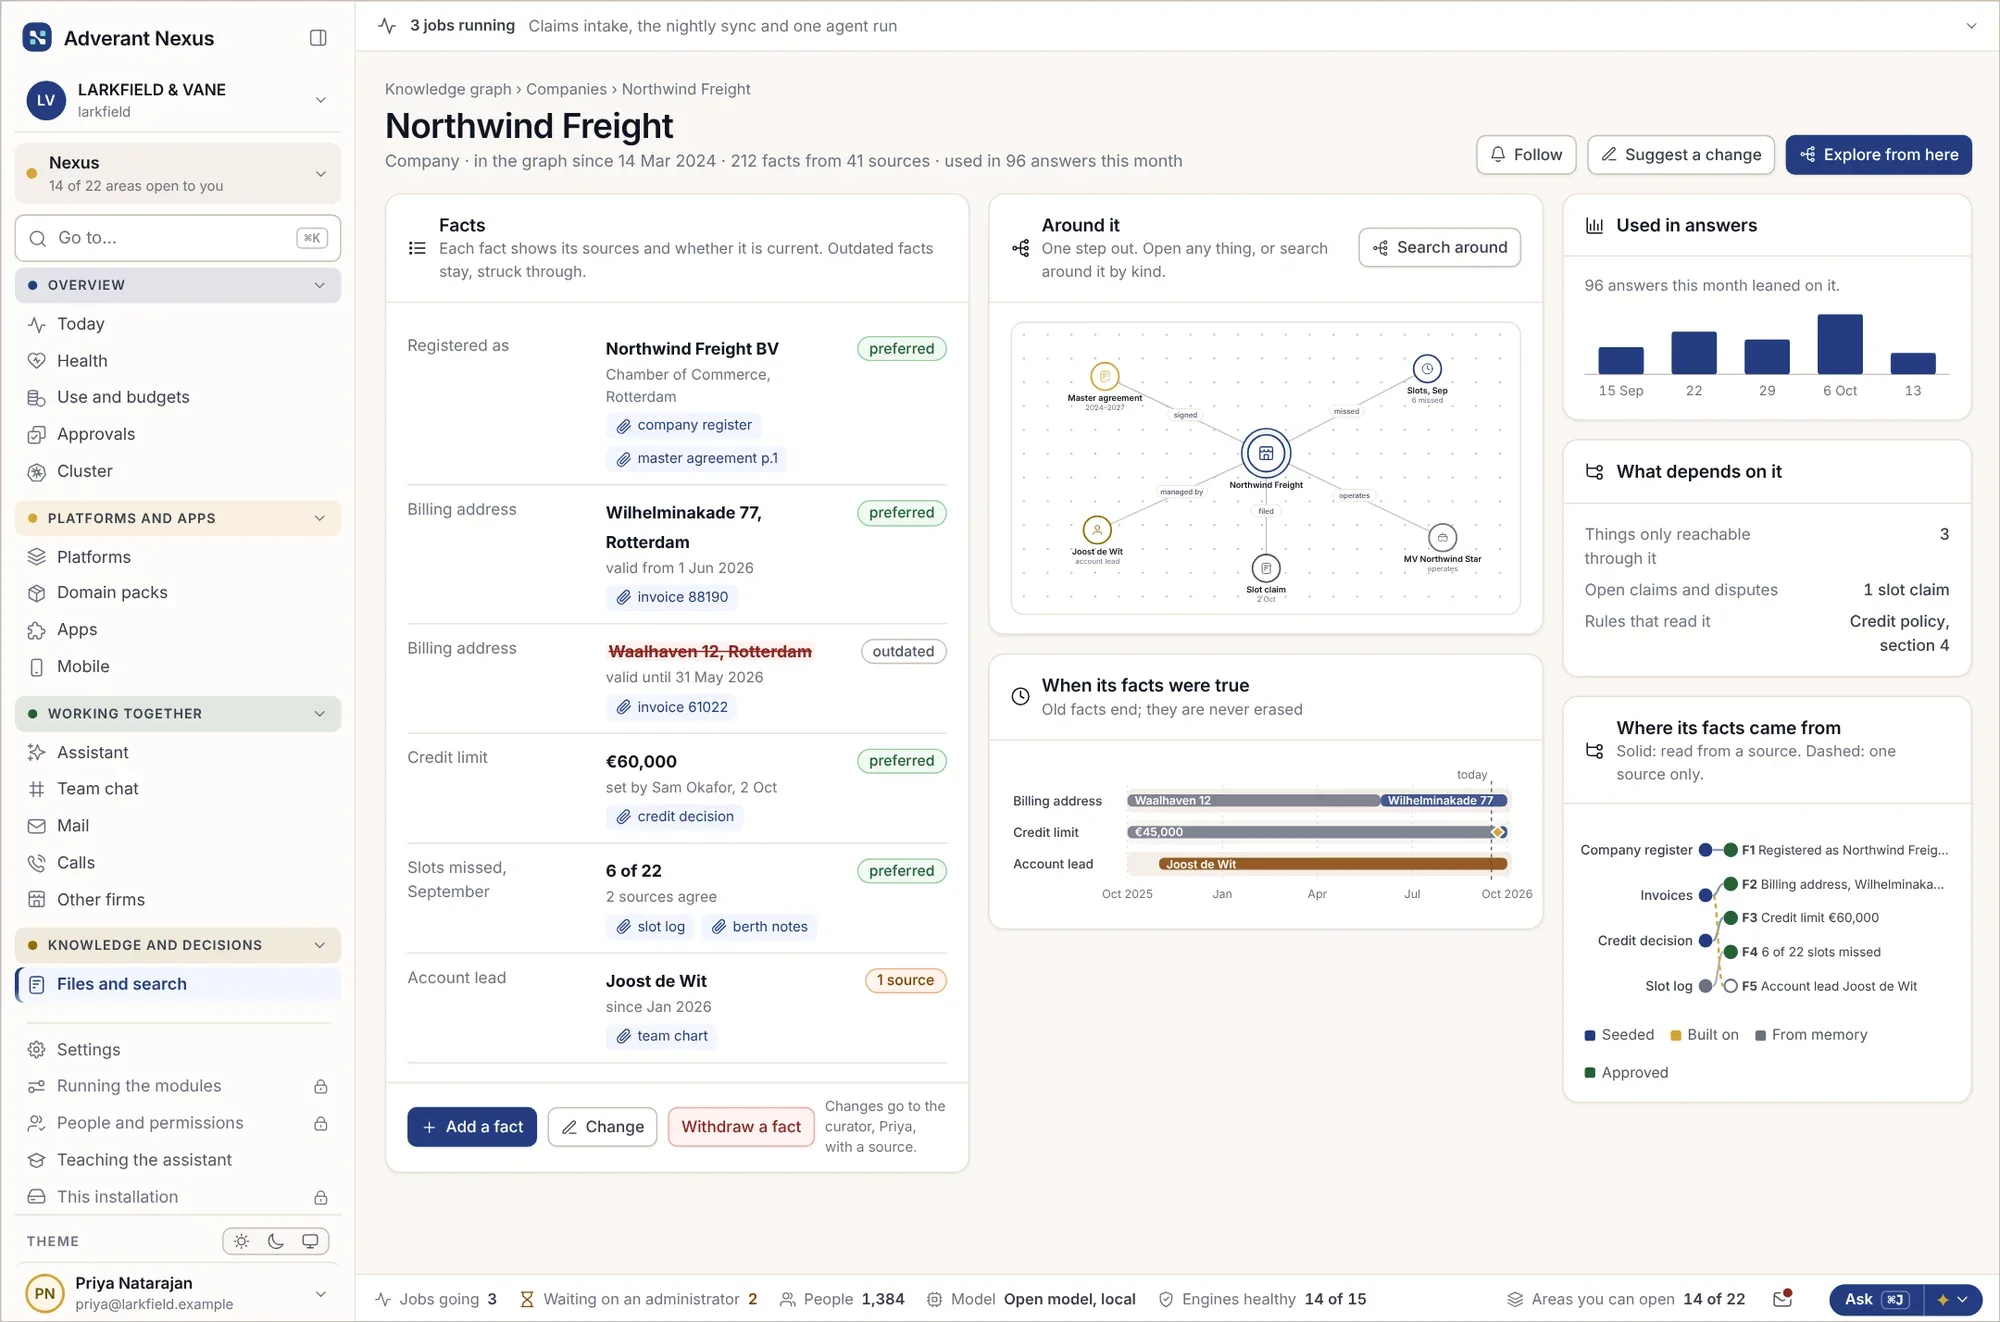
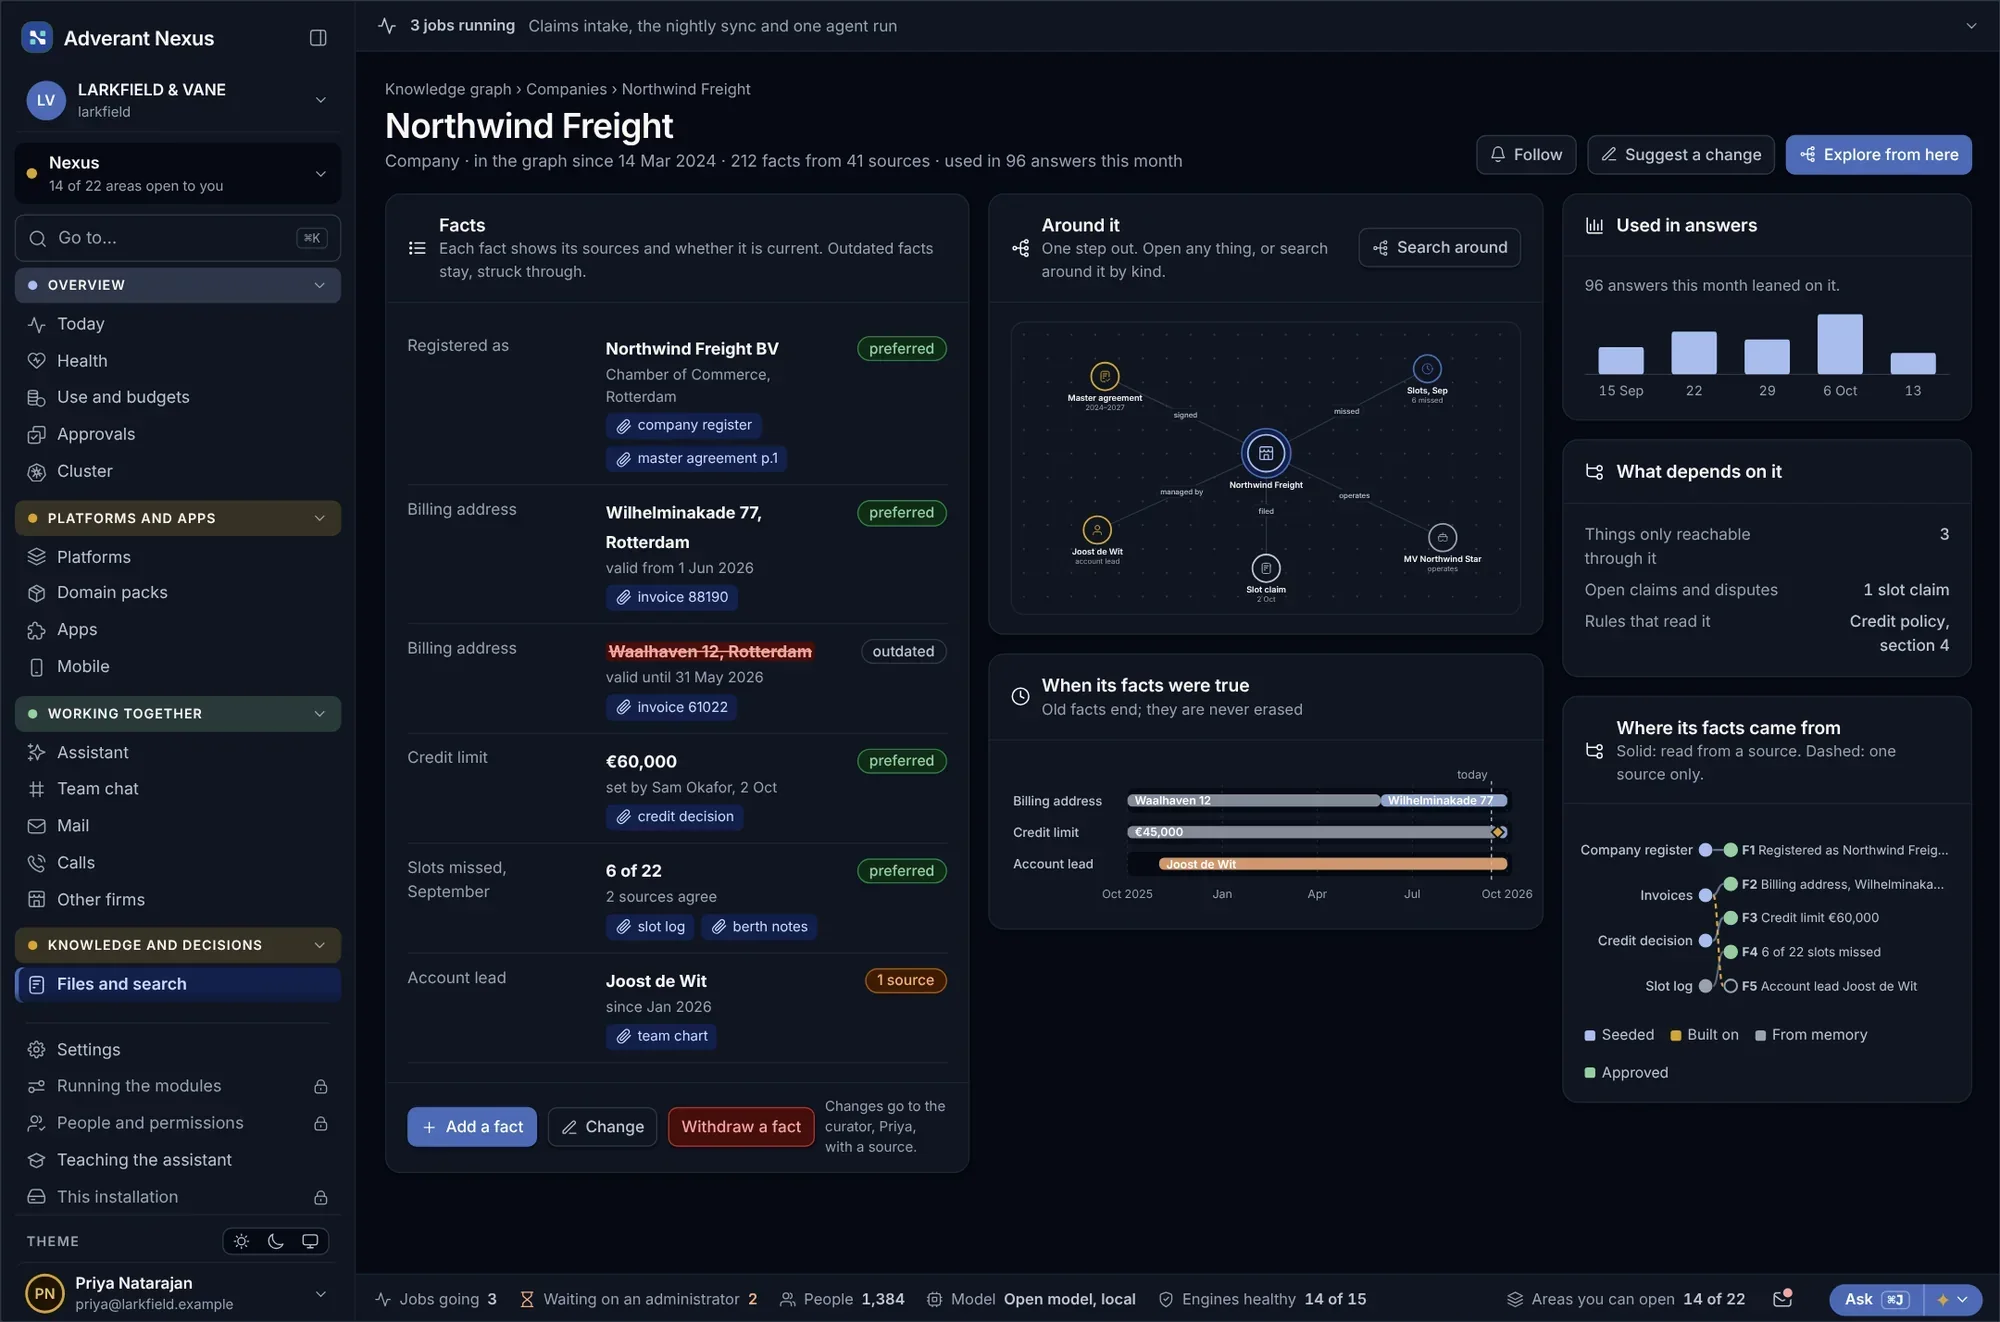
Open vóór een gesprek alles over één onderwerp op één pagina. Verken wat eromheen hangt en bewaar die weergave voor uw team. Los meningsverschillen op met de geschiedenis van elk feit.
Eén onderwerp, op één pagina
Wat we vóór een gesprek over een bedrijf weten: waarvandaan en sinds wanneer.
- Alles over één onderwerp
- Bronnen op elke regel
- Corrigeer een feit direct waar u het ziet
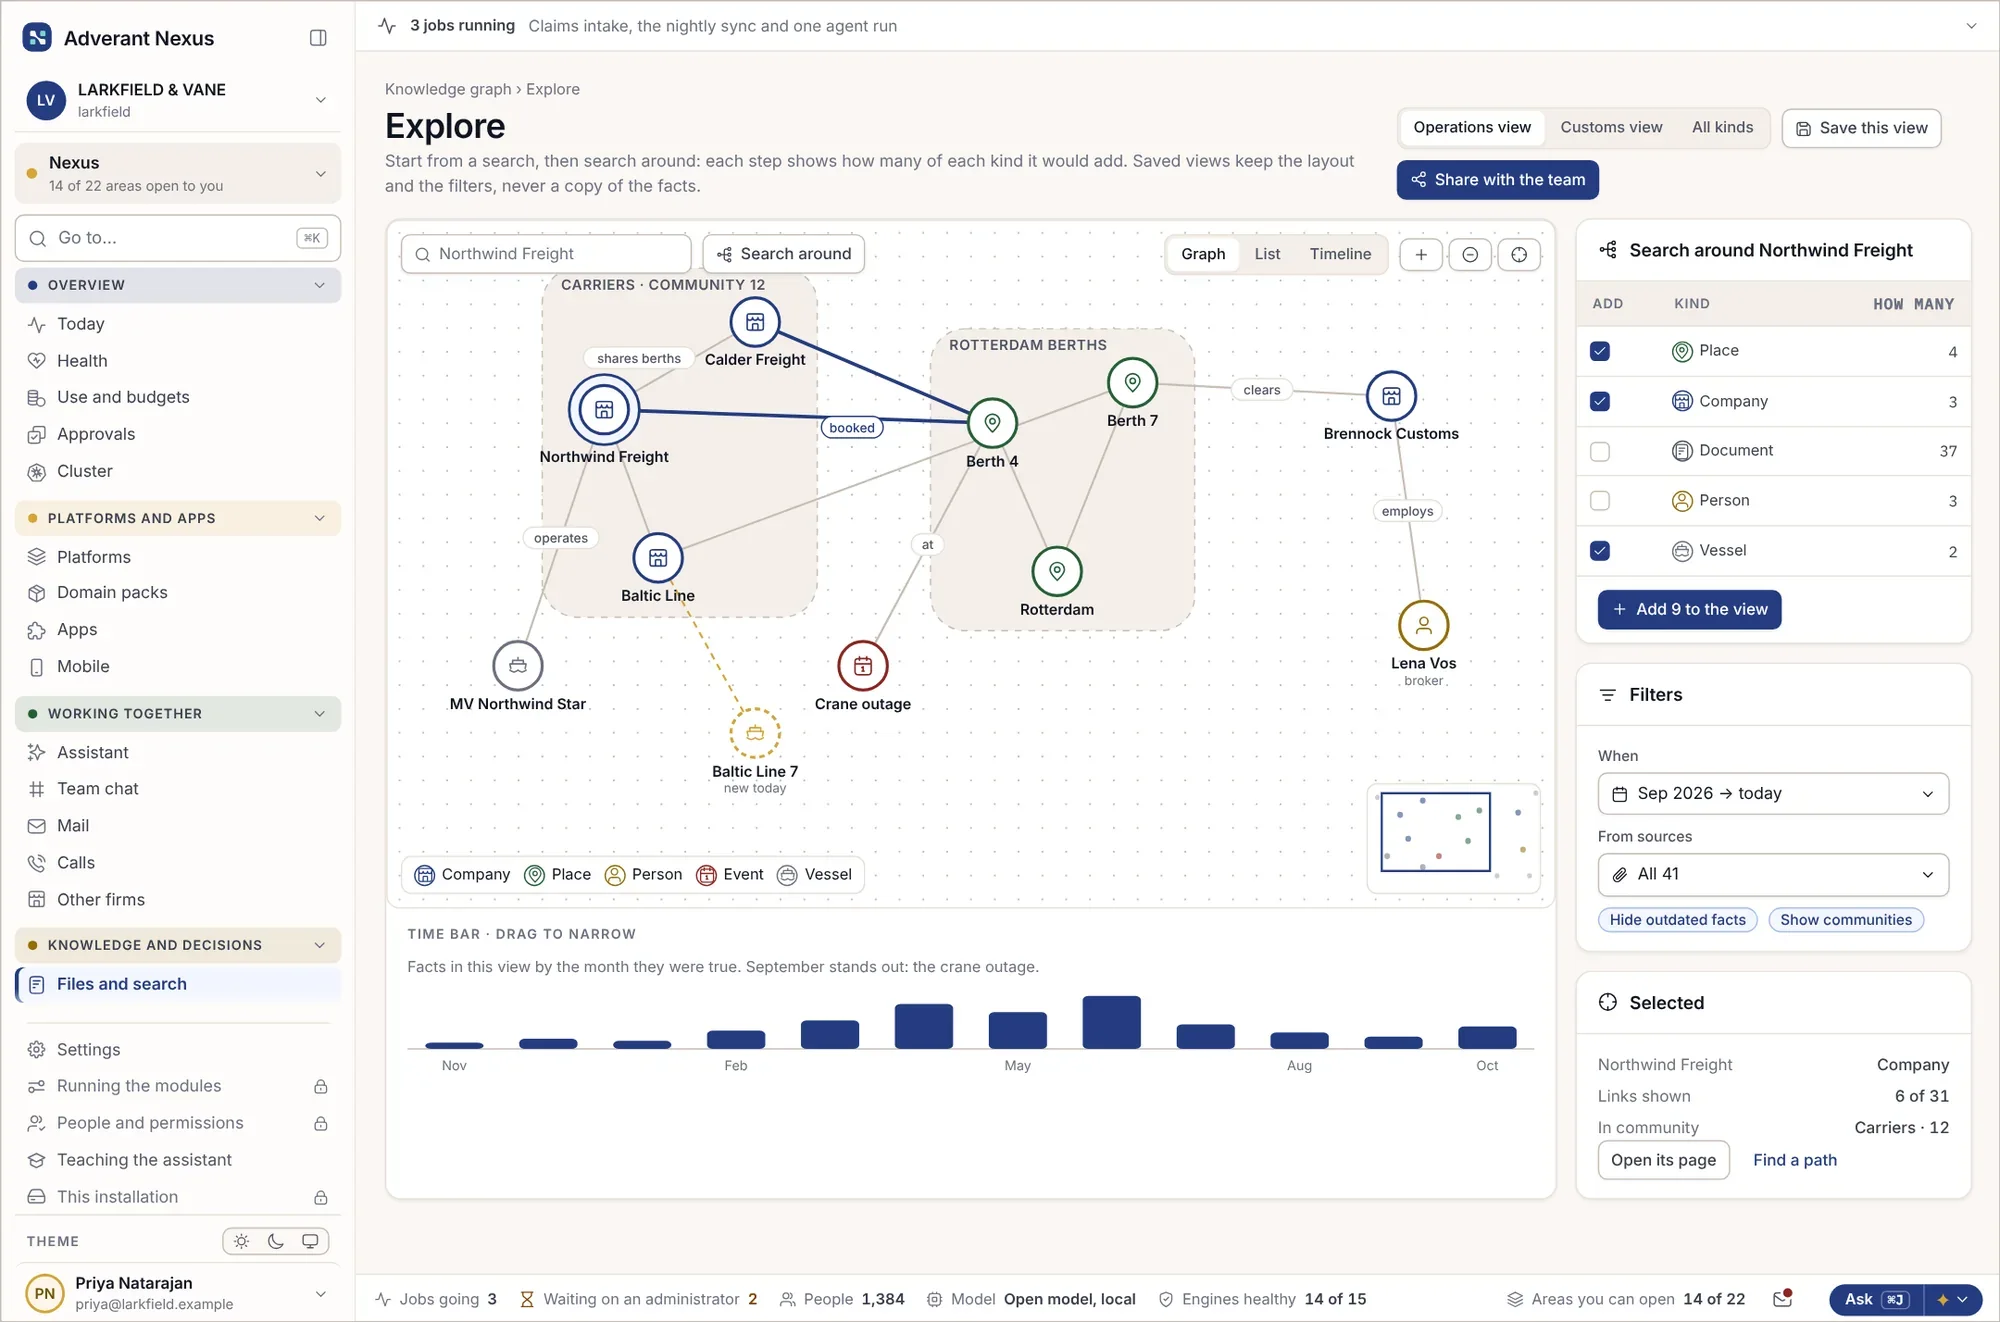
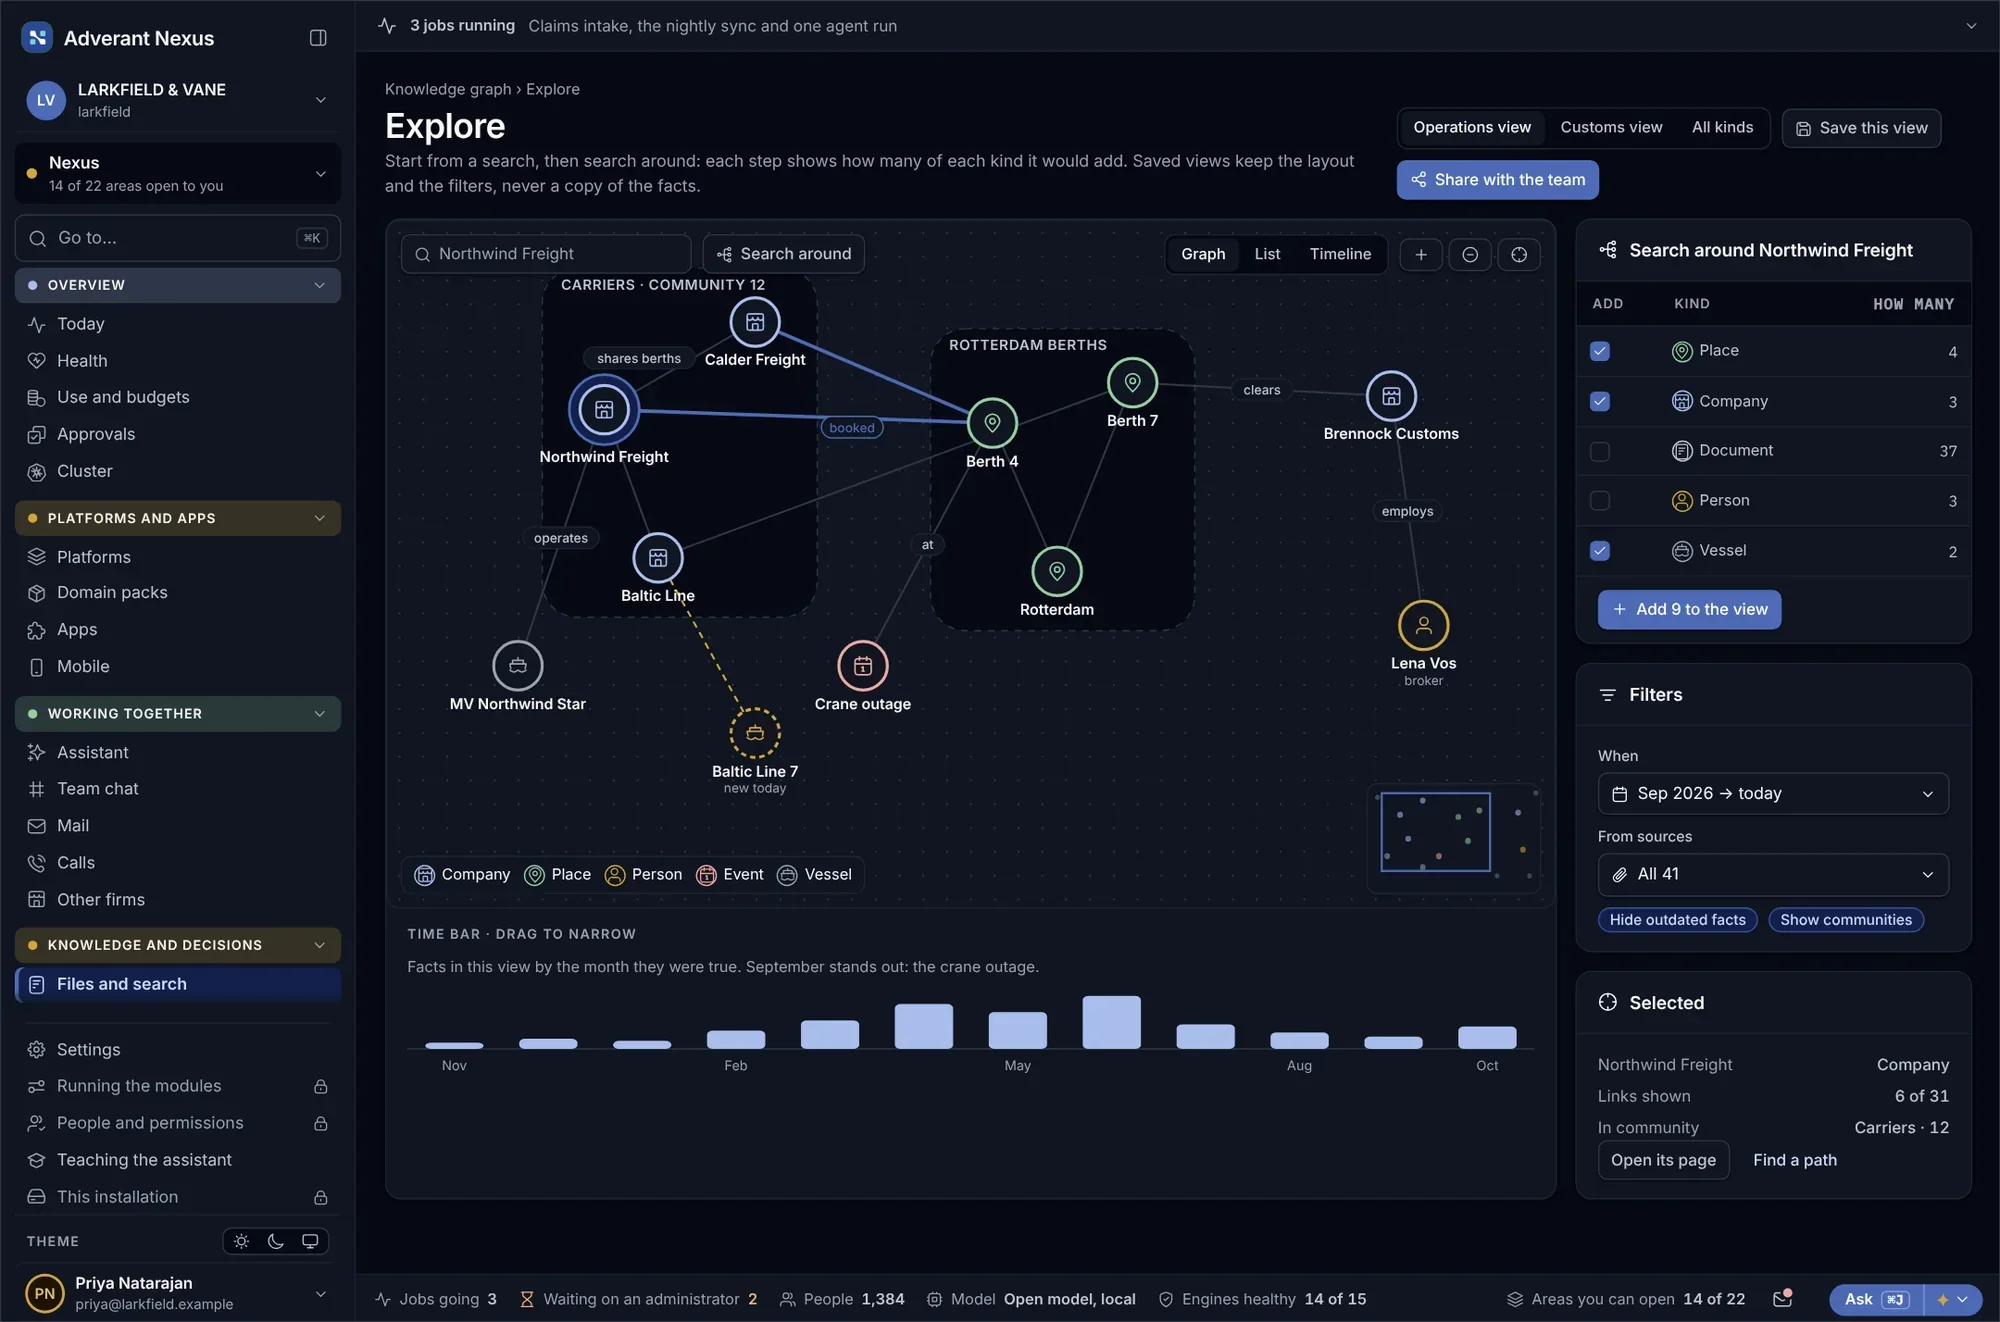
Verken de omgeving van een onderwerp
Begin bij een schip, een klant of een ligplaats en zie wat ermee samenhangt.
- Visueel verkennen
- Weergaven opgeslagen en gedeeld
- Lenzen bepalen wat elke rol ziet
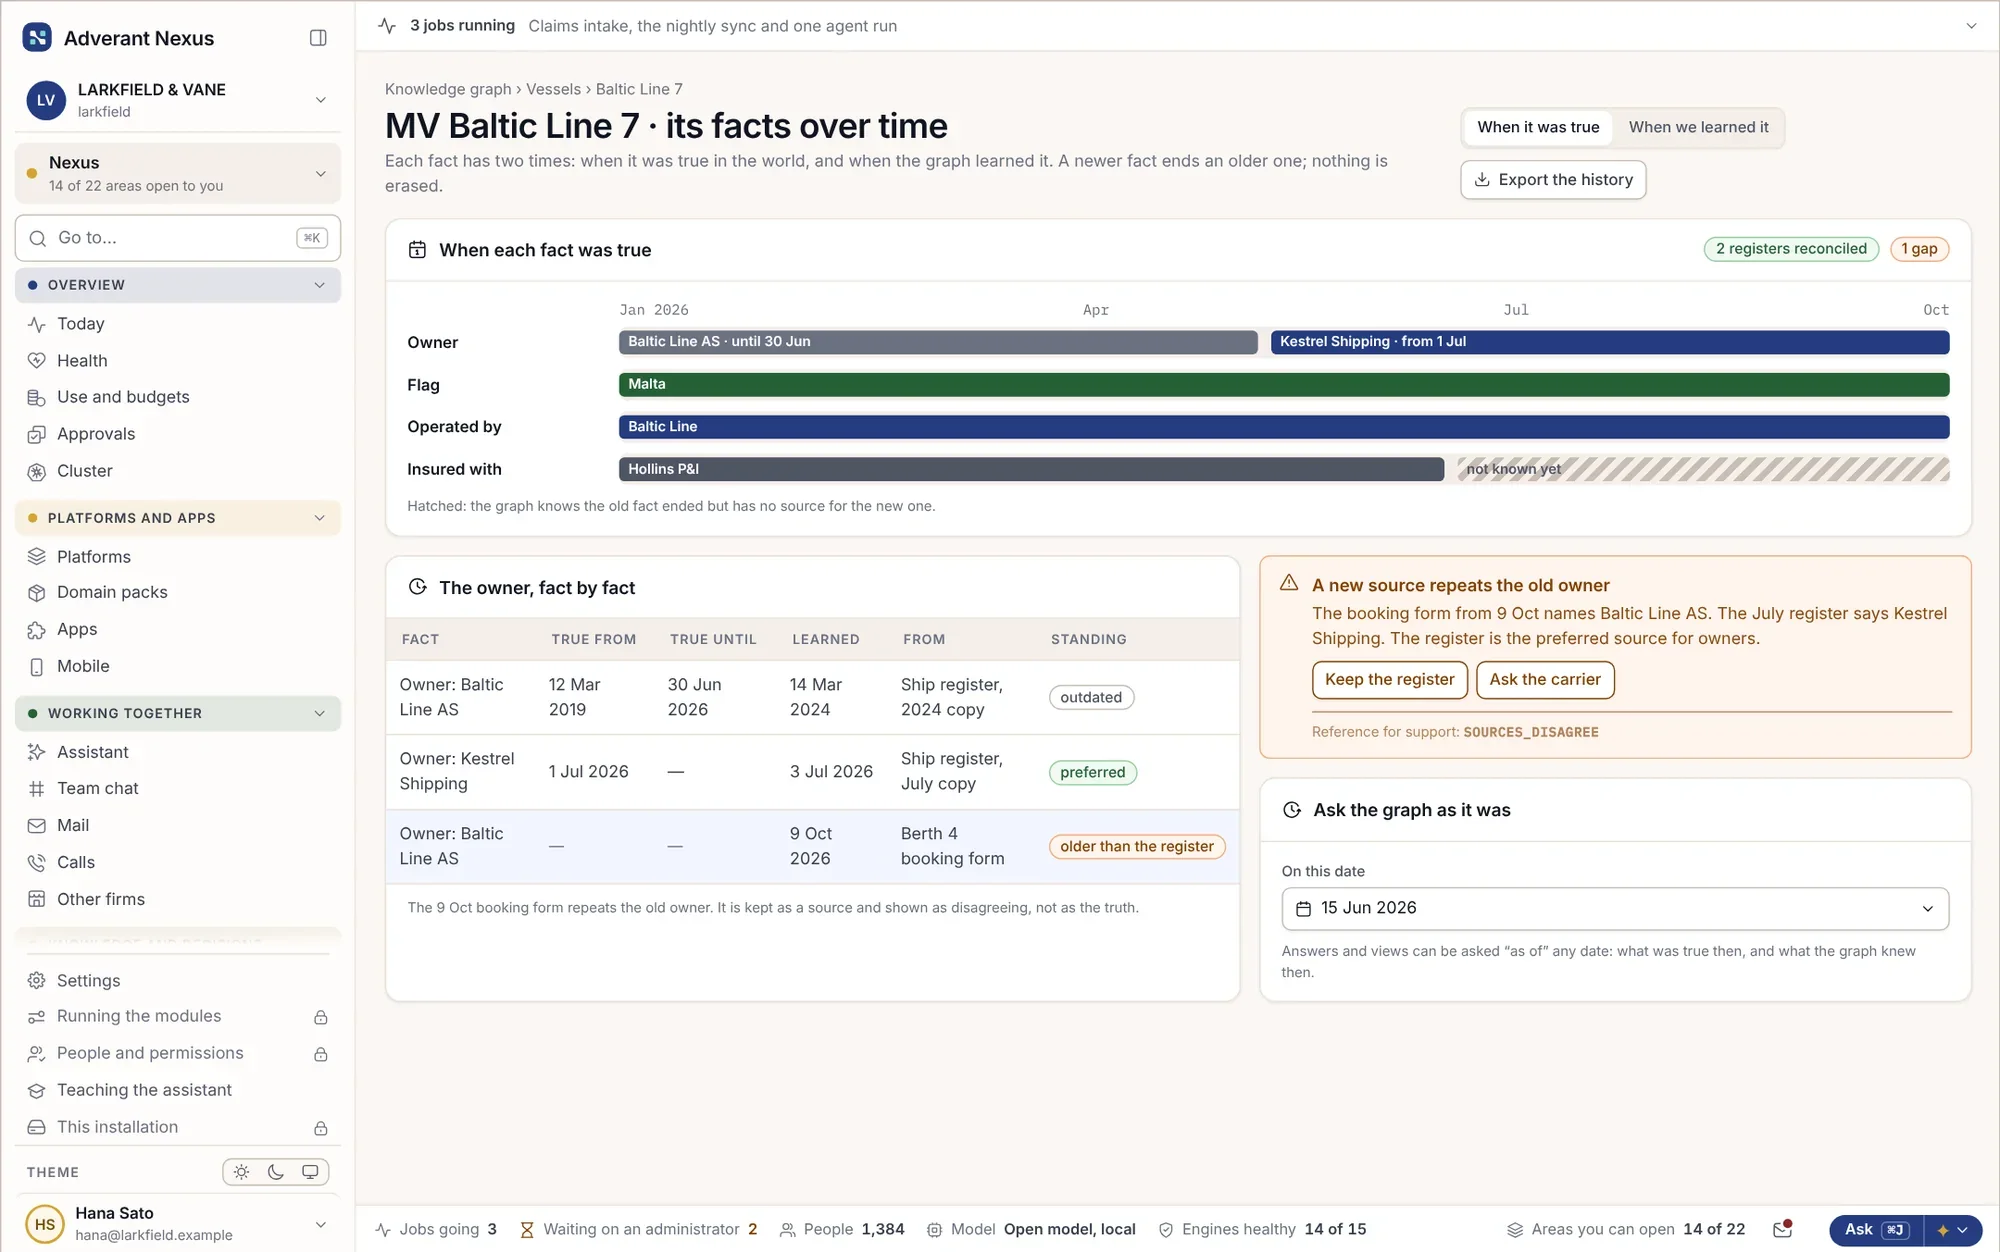
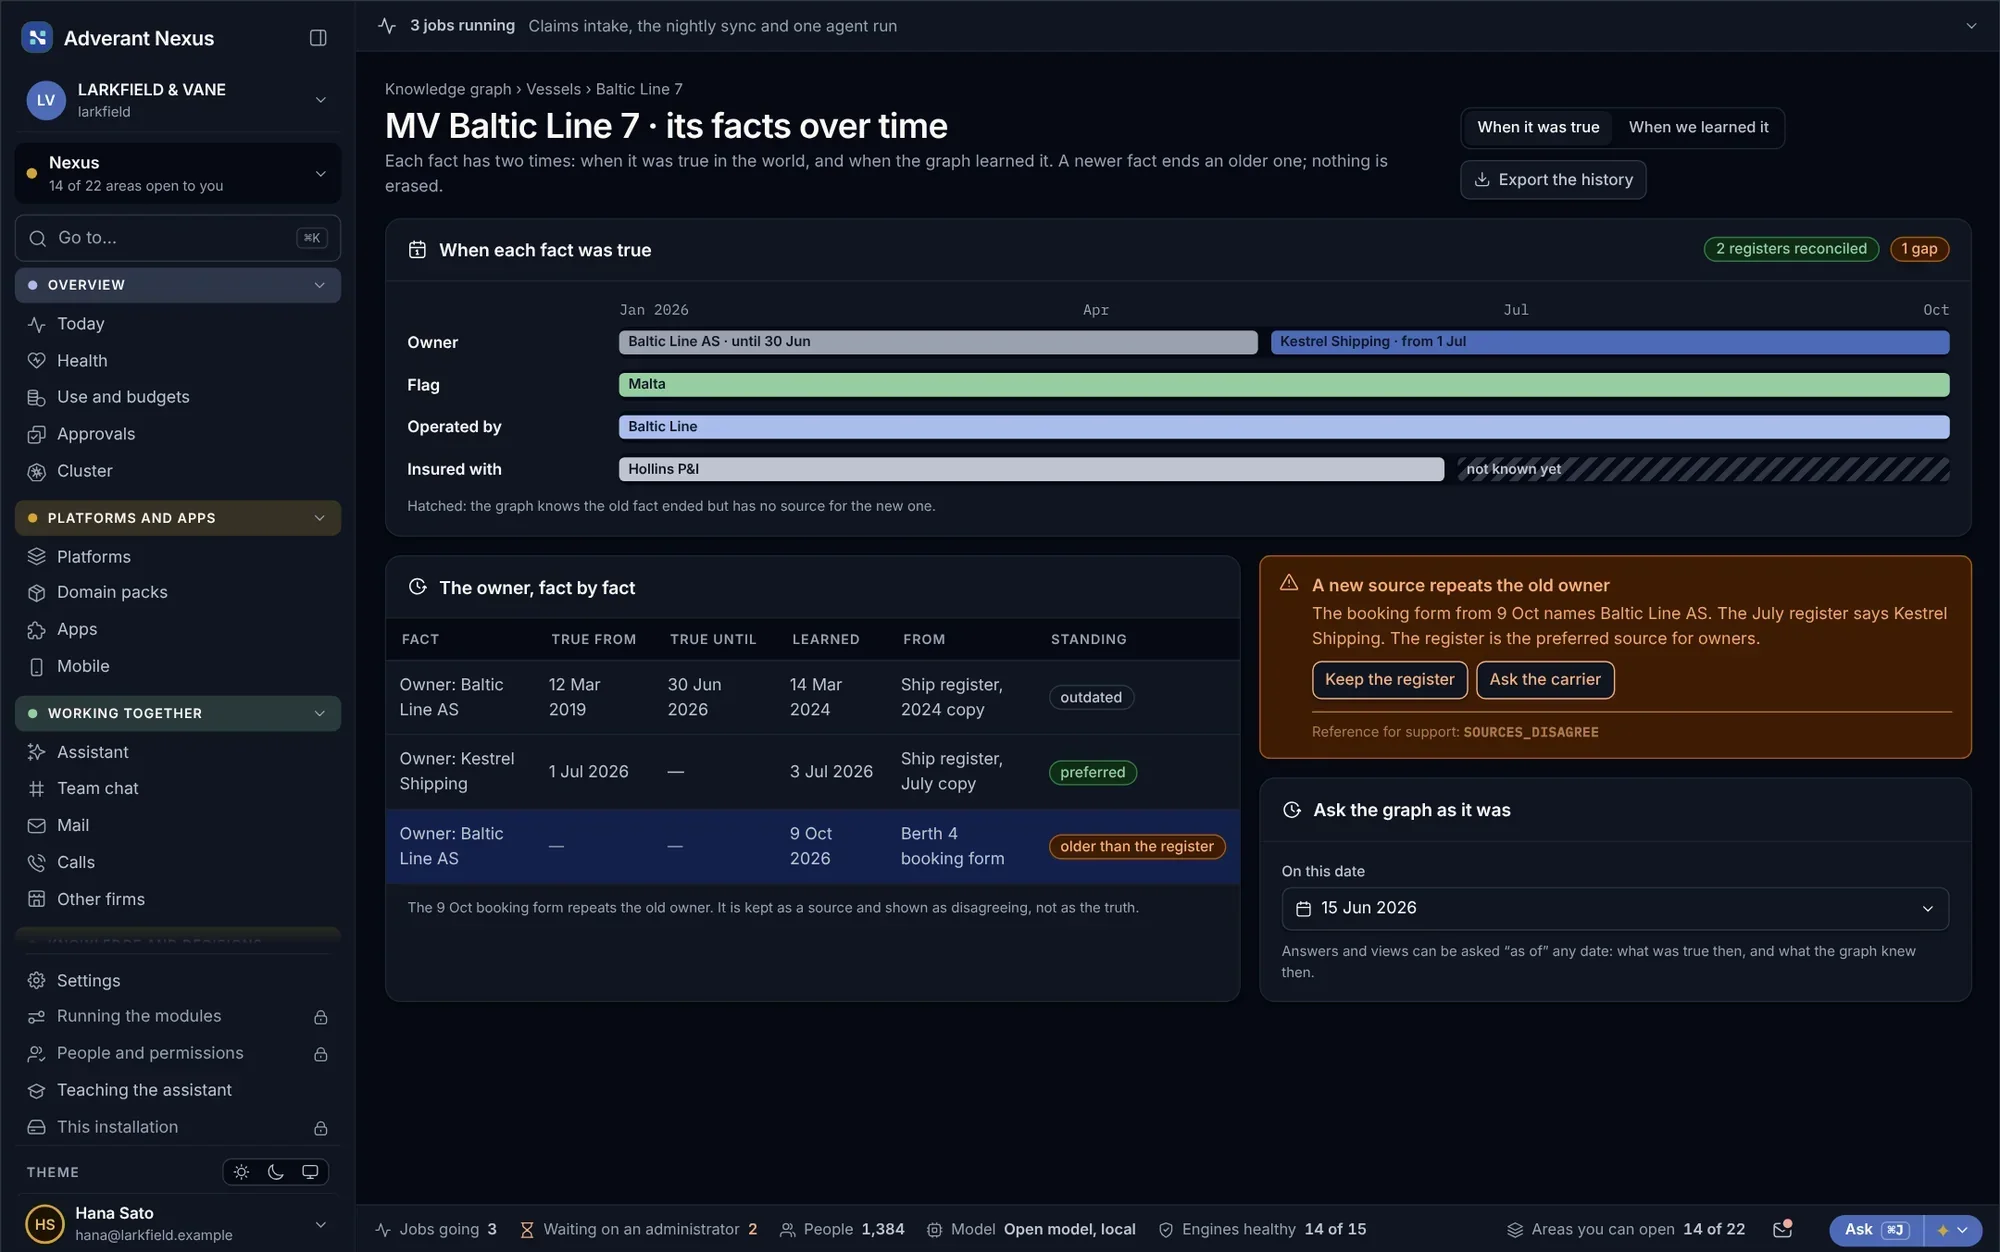
Feiten door de tijd heen
Twee registers spreken elkaar tegen over de eigenaar van een schip. Los het op met bewijs.
- Geschiedenis bij elk feit
- Bronnen naast elkaar
- Opgelost door een persoon, met opgave van reden
Beschermd, feit voor feit.
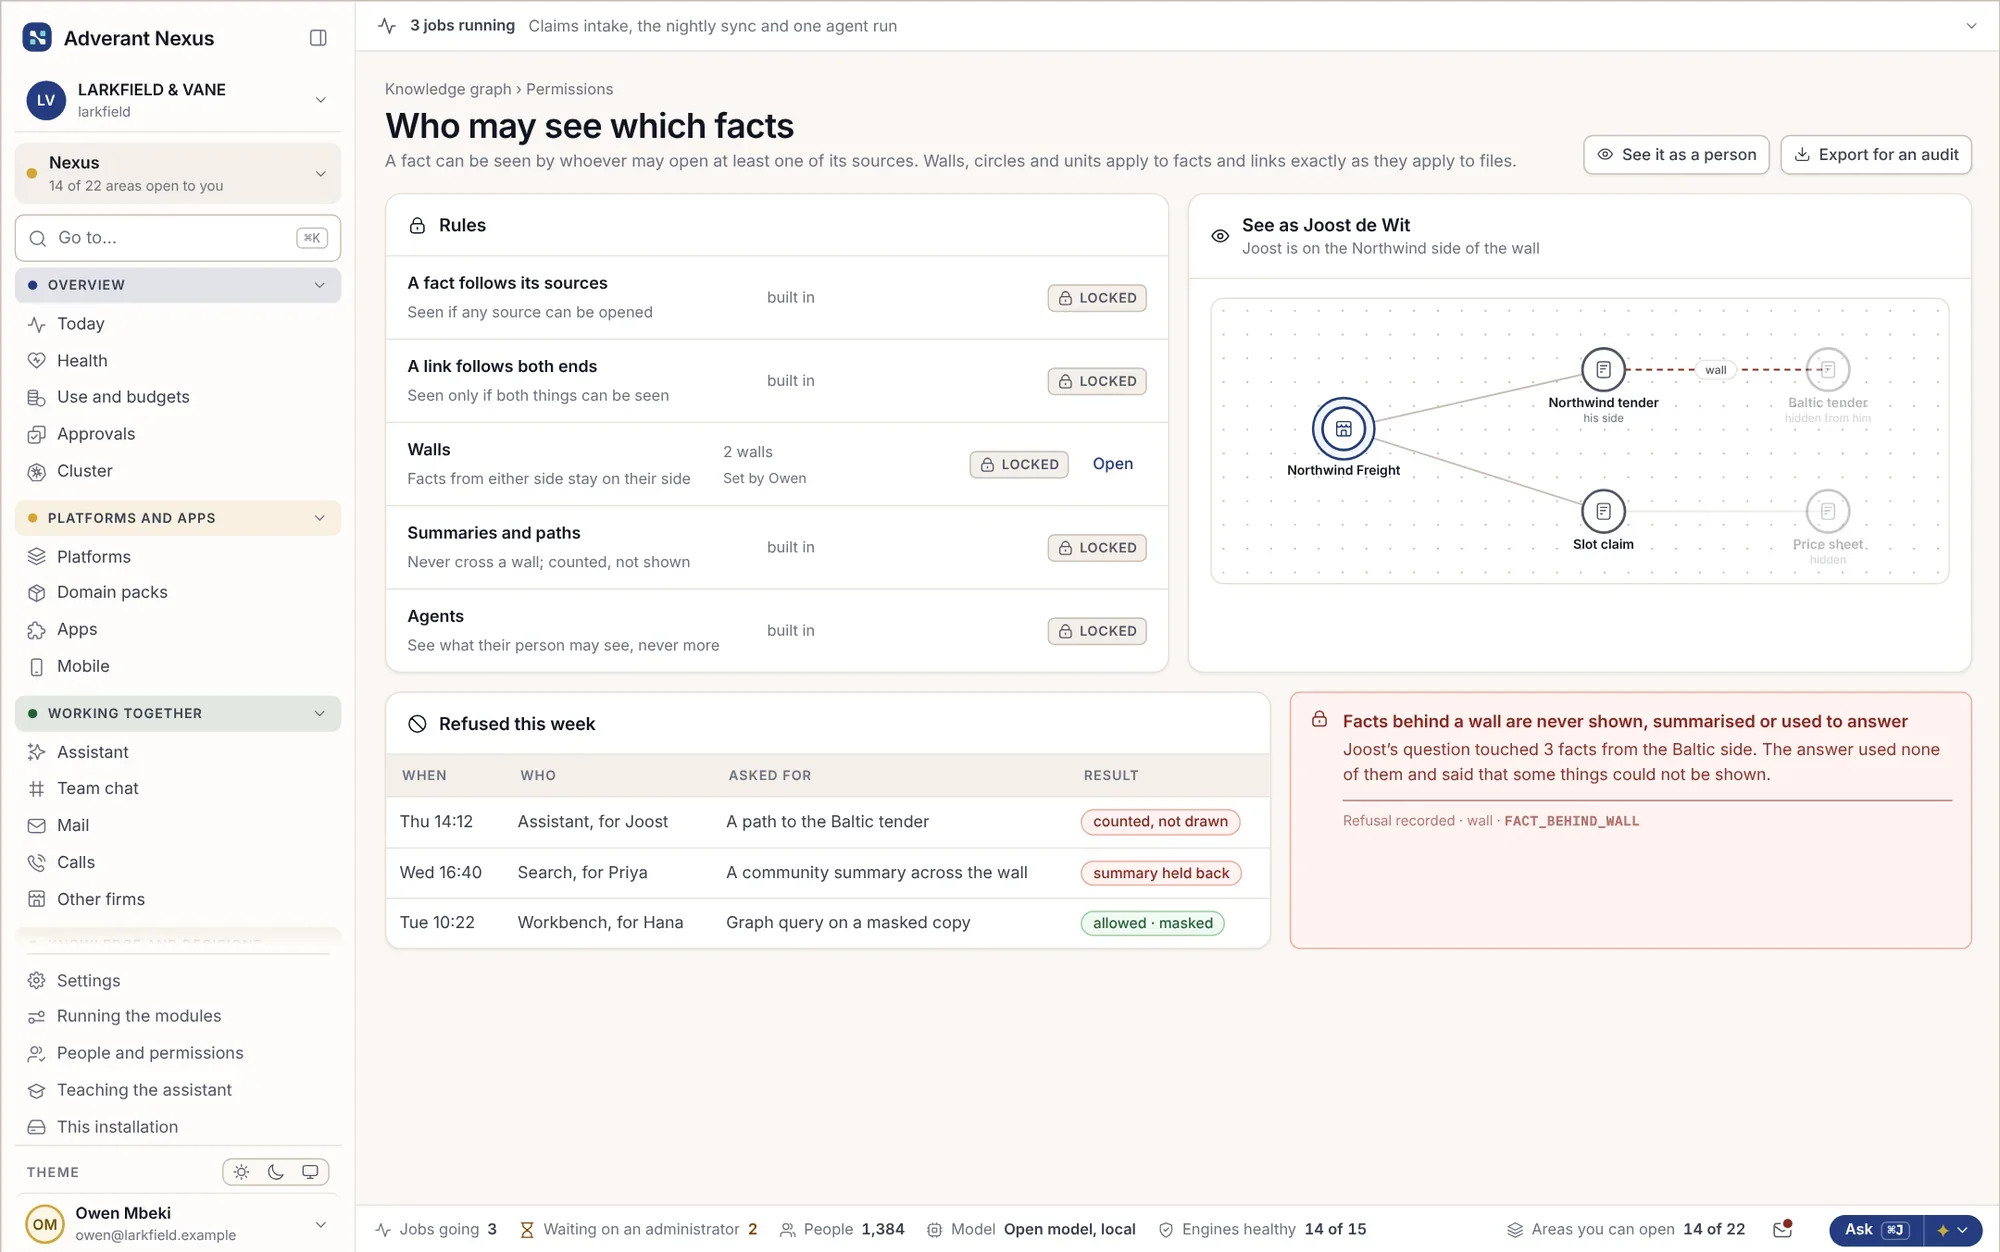
Rechten en informatiewanden gelden voor afzonderlijke feiten, niet alleen voor documenten. Twee aanbestedingsteams kunnen in dezelfde graaf werken zonder elkaars feiten te zien, en de AI antwoordt uitsluitend op basis van wat de vraagsteller mag zien.
- Rechten op feitniveau
- Informatiewanden blijven in de graaf overeind
- Antwoorden alleen opgebouwd uit zichtbare feiten
Over de kennisgraaf.
Wat is GraphRAG?
Informatie-ophaling voor AI die werkt over een kennisgraaf in plaats van losse tekst. Het vindt door het hele bedrijf heen de feiten die samenhangen met een vraag en geeft ze met hun bronnen door aan het model, zodat antwoorden steunen op veel meer context dan er in een prompt past.
Hebben we een ontologie nodig voordat we beginnen?
Nee. Begin met het model uit een domeinpakket of met wat Nexus in uw documenten aantreft, en verfijn het gaandeweg.
Raakt het opbouwen van de graaf onze systemen?
Nee. Nexus leest uit uw systemen, maar schrijft er niets naar terug. De graaf wordt ernaast opgebouwd.
Kunnen we de kennisbank exporteren?
Ja, als een ondertekende bundel, bijvoorbeeld om deze naar een testcluster te verplaatsen.
Ga dieper
Zie uw bedrijf als een graaf.
Neem een register en een handvol documenten mee. Samen met u bouwen we de eerste versie van uw model en stellen we er vragen aan.