

Tot ce știe compania dvs., conectat și gata să răspundă.
În centrul Nexus se află un graf de cunoștințe construit din documentele, corespondența, sistemele și evidențele dvs. Priviți-l ca pe propriul motor de căutare al companiei. Ontologia definește ce sunt clienții, contractele, navele sau dosarele dvs. de daună și cum se leagă între ele. Apoi, GraphRAG oferă fiecărui sistem IA informațiile relevante pentru o întrebare, extrase din întreaga organizație și însoțite de sursa lor. Acesta oferă mult mai mult context decât poate cuprinde orice instrucțiune (prompt) și este motivul pentru care vă puteți baza pe răspunsuri.
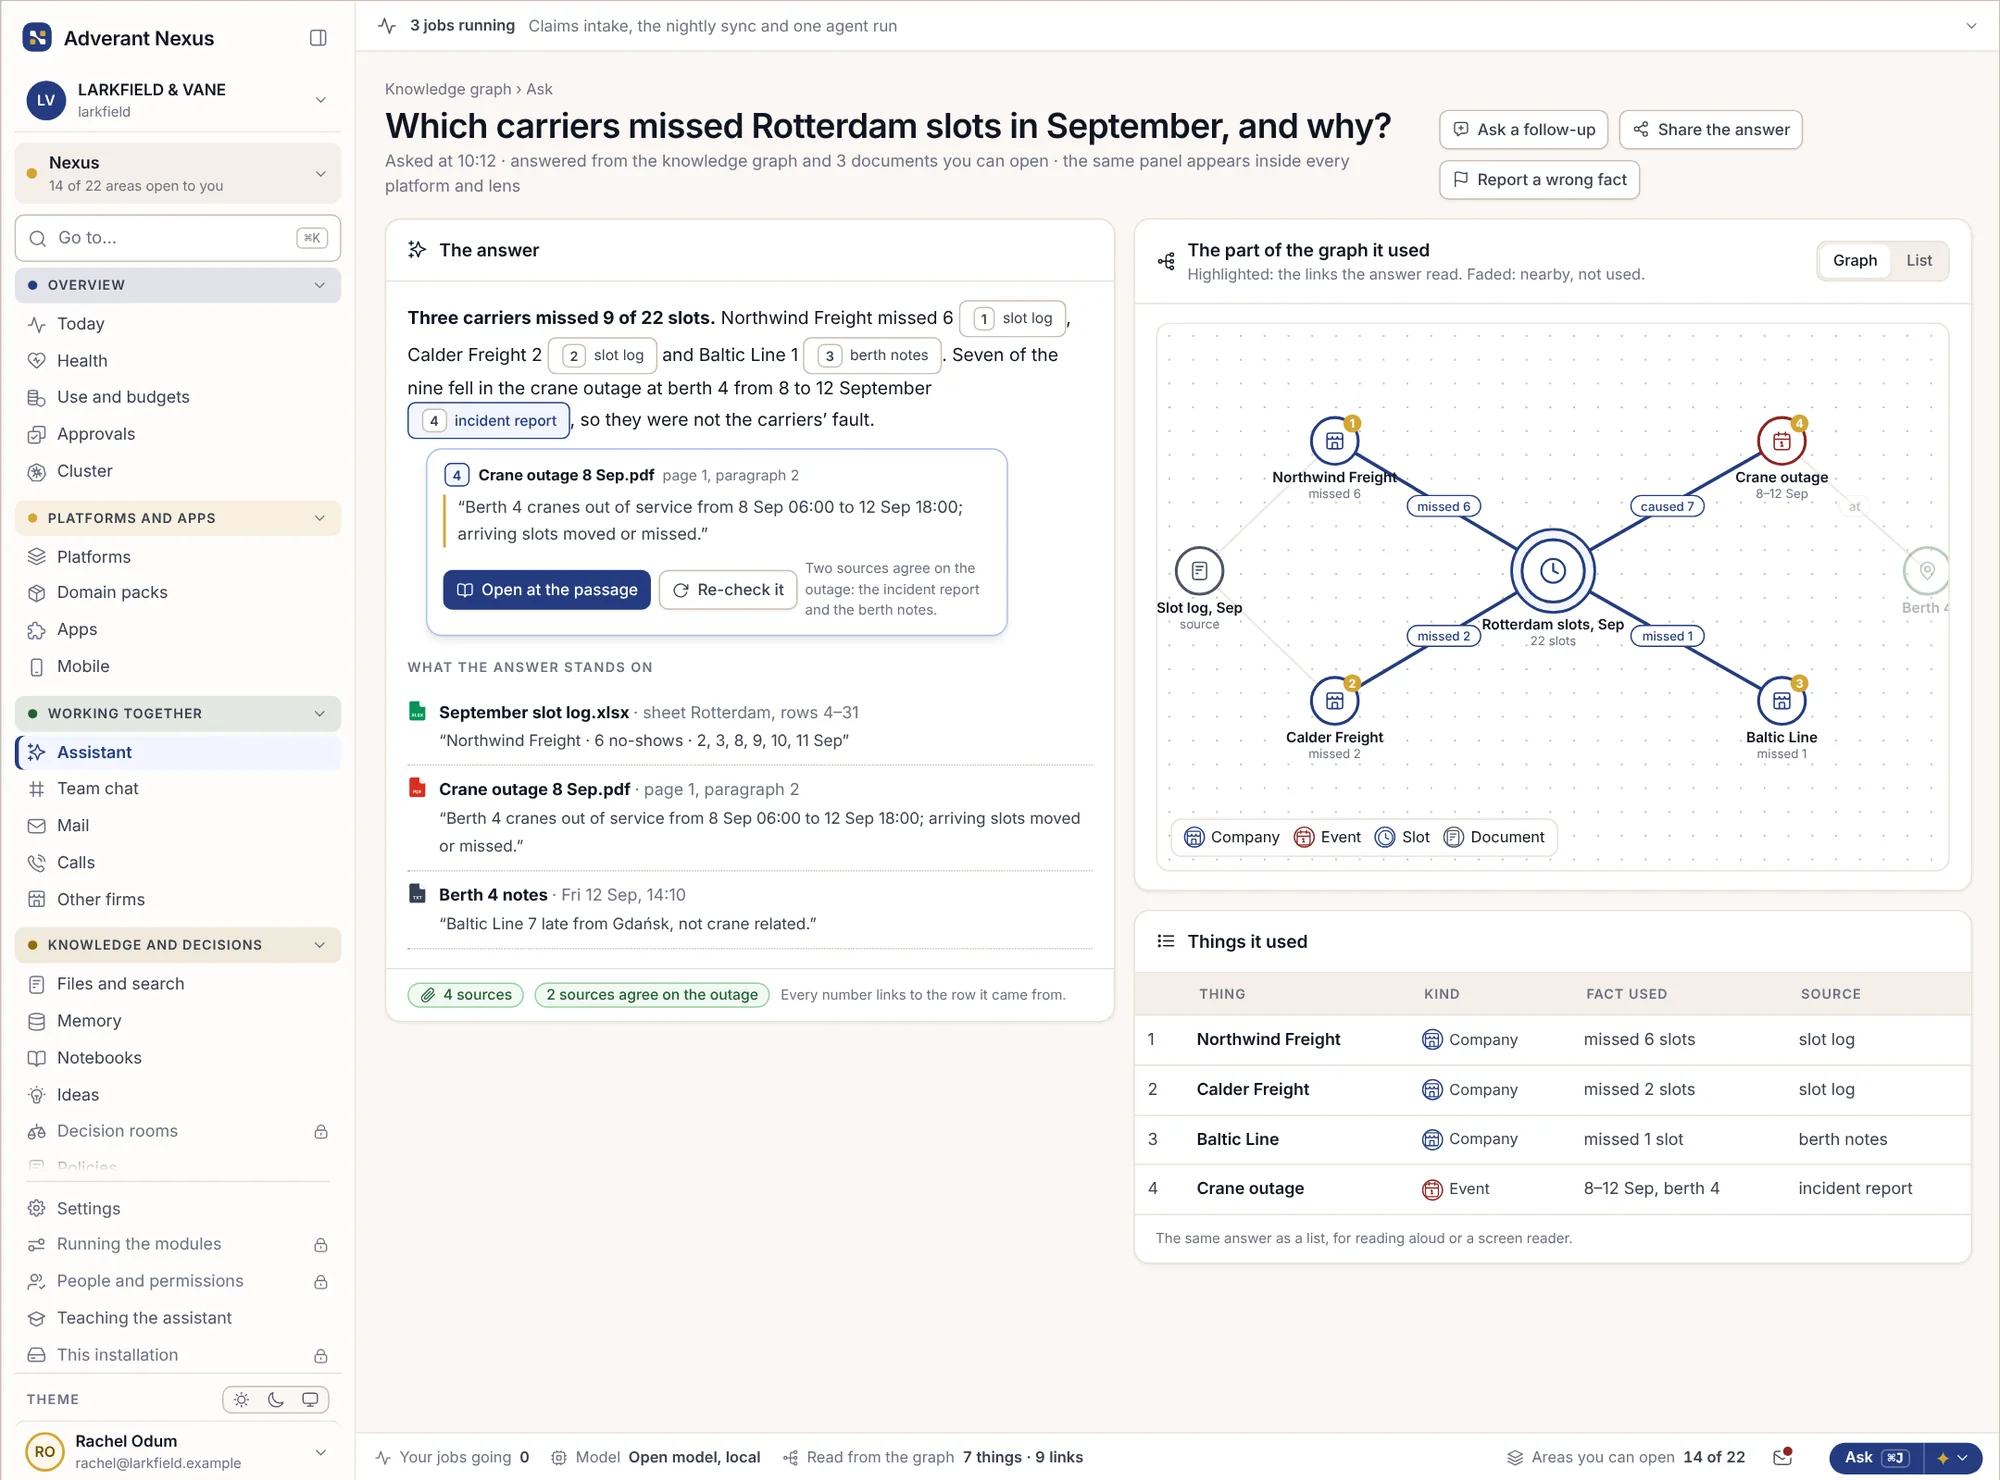
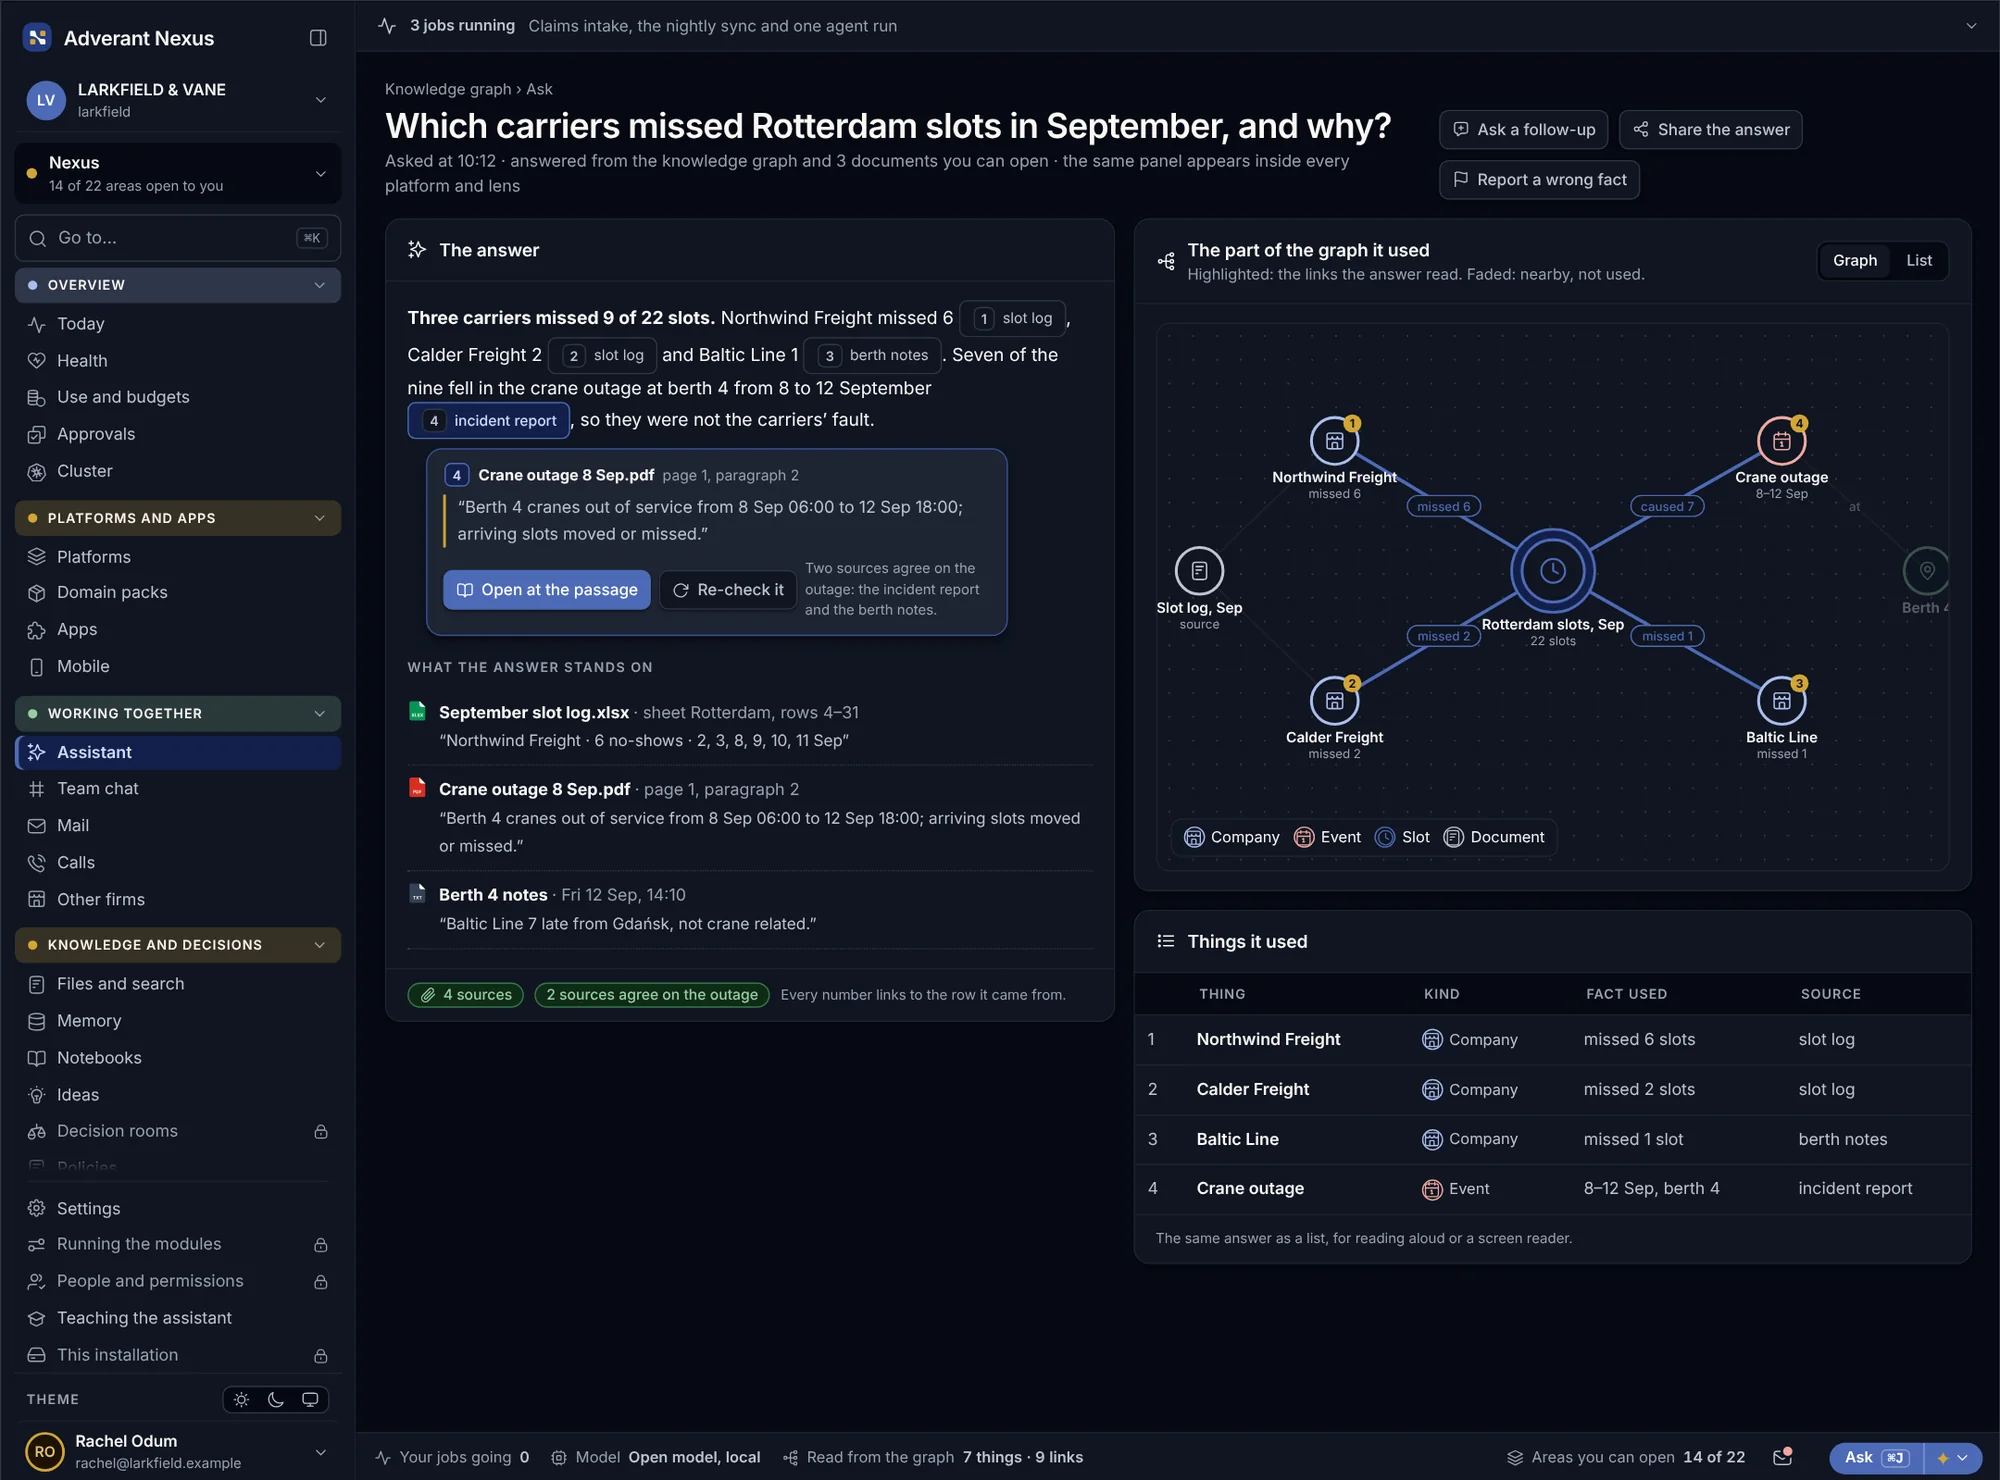
Contextul complet, nu doar cel mai apropiat paragraf.
Căutarea obișnuită găsește documente care folosesc aceleași cuvinte. GraphRAG urmărește conexiunile: o întrebare despre un transportator ajunge la contractele sale, la dosarele de daună, la navele pe care le operează și la corespondența despre acestea, chiar și atunci când niciunul dintre documente nu folosește aceiași termeni. IA răspunde pe baza acestei imagini de ansamblu și indică fiecare informație folosită.
- Răspunsuri extrase din întreaga companie
- Urmărește conexiuni, nu doar cuvinte-cheie
- Sinteze ale unor subiecte întregi pentru întrebări generale
- Doar informațiile pe care solicitantul are dreptul să le vadă
Modelați structura. Vedeți mai întâi ce afectează.
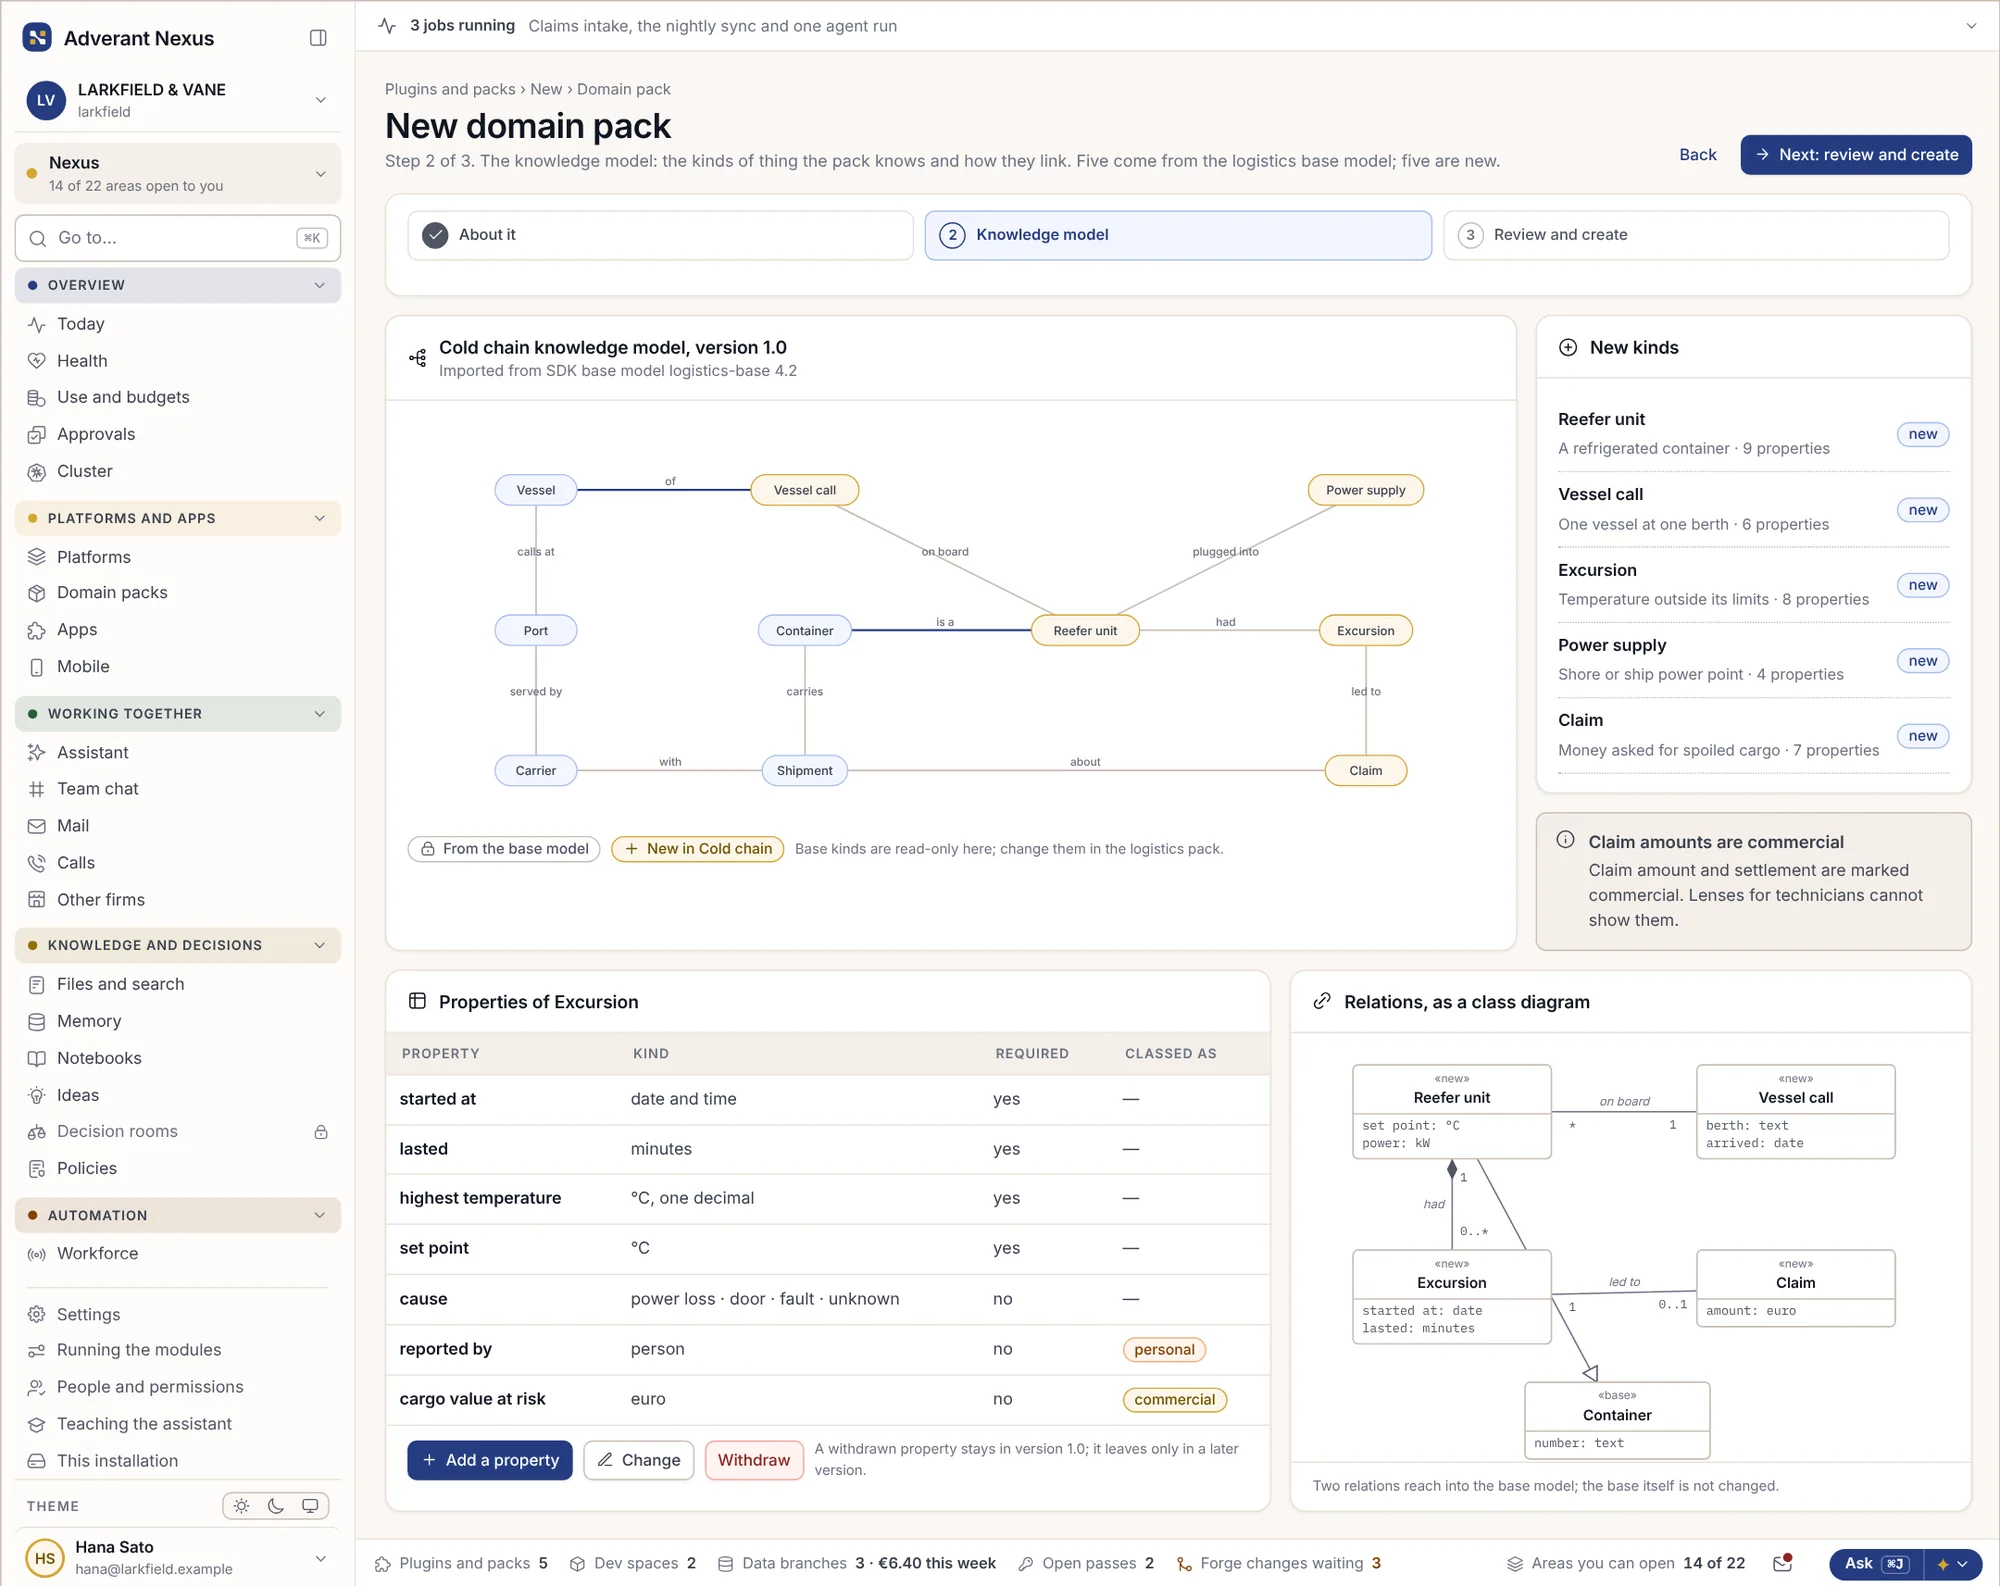
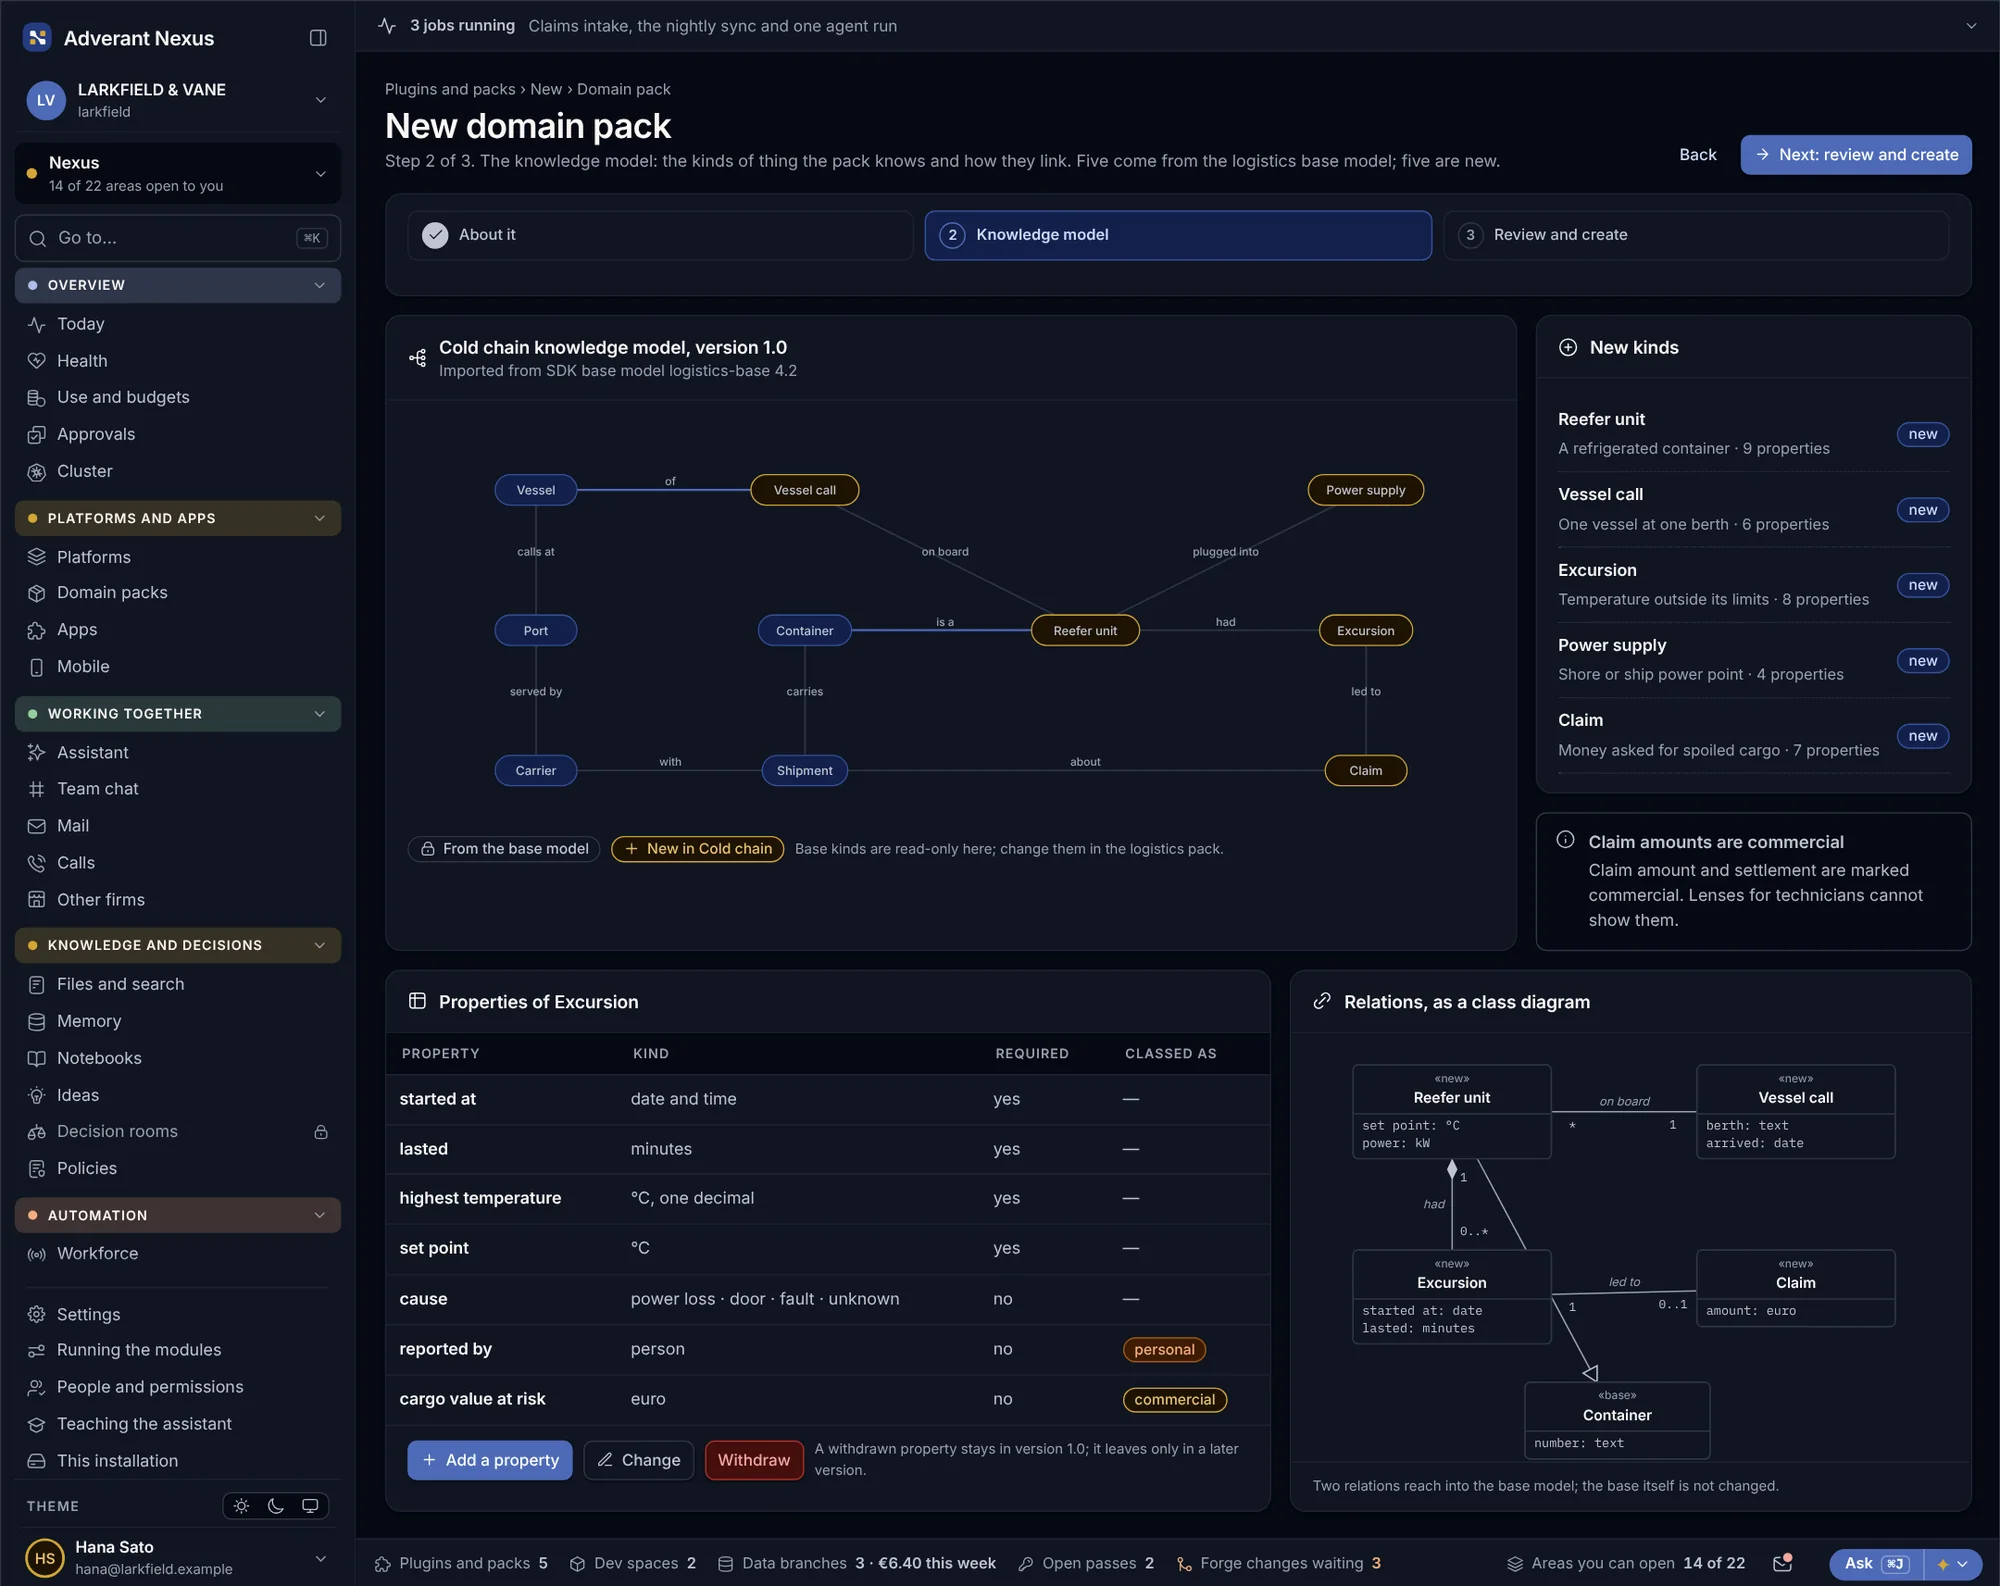
Adăugați un tip de entitate, o proprietate sau o legătură și vedeți câte informații existente ar modifica înainte să salvați. Pachetele de domeniu oferă un model de bază pentru sectorul respectiv, pe care îl puteți extinde pentru propria activitate.
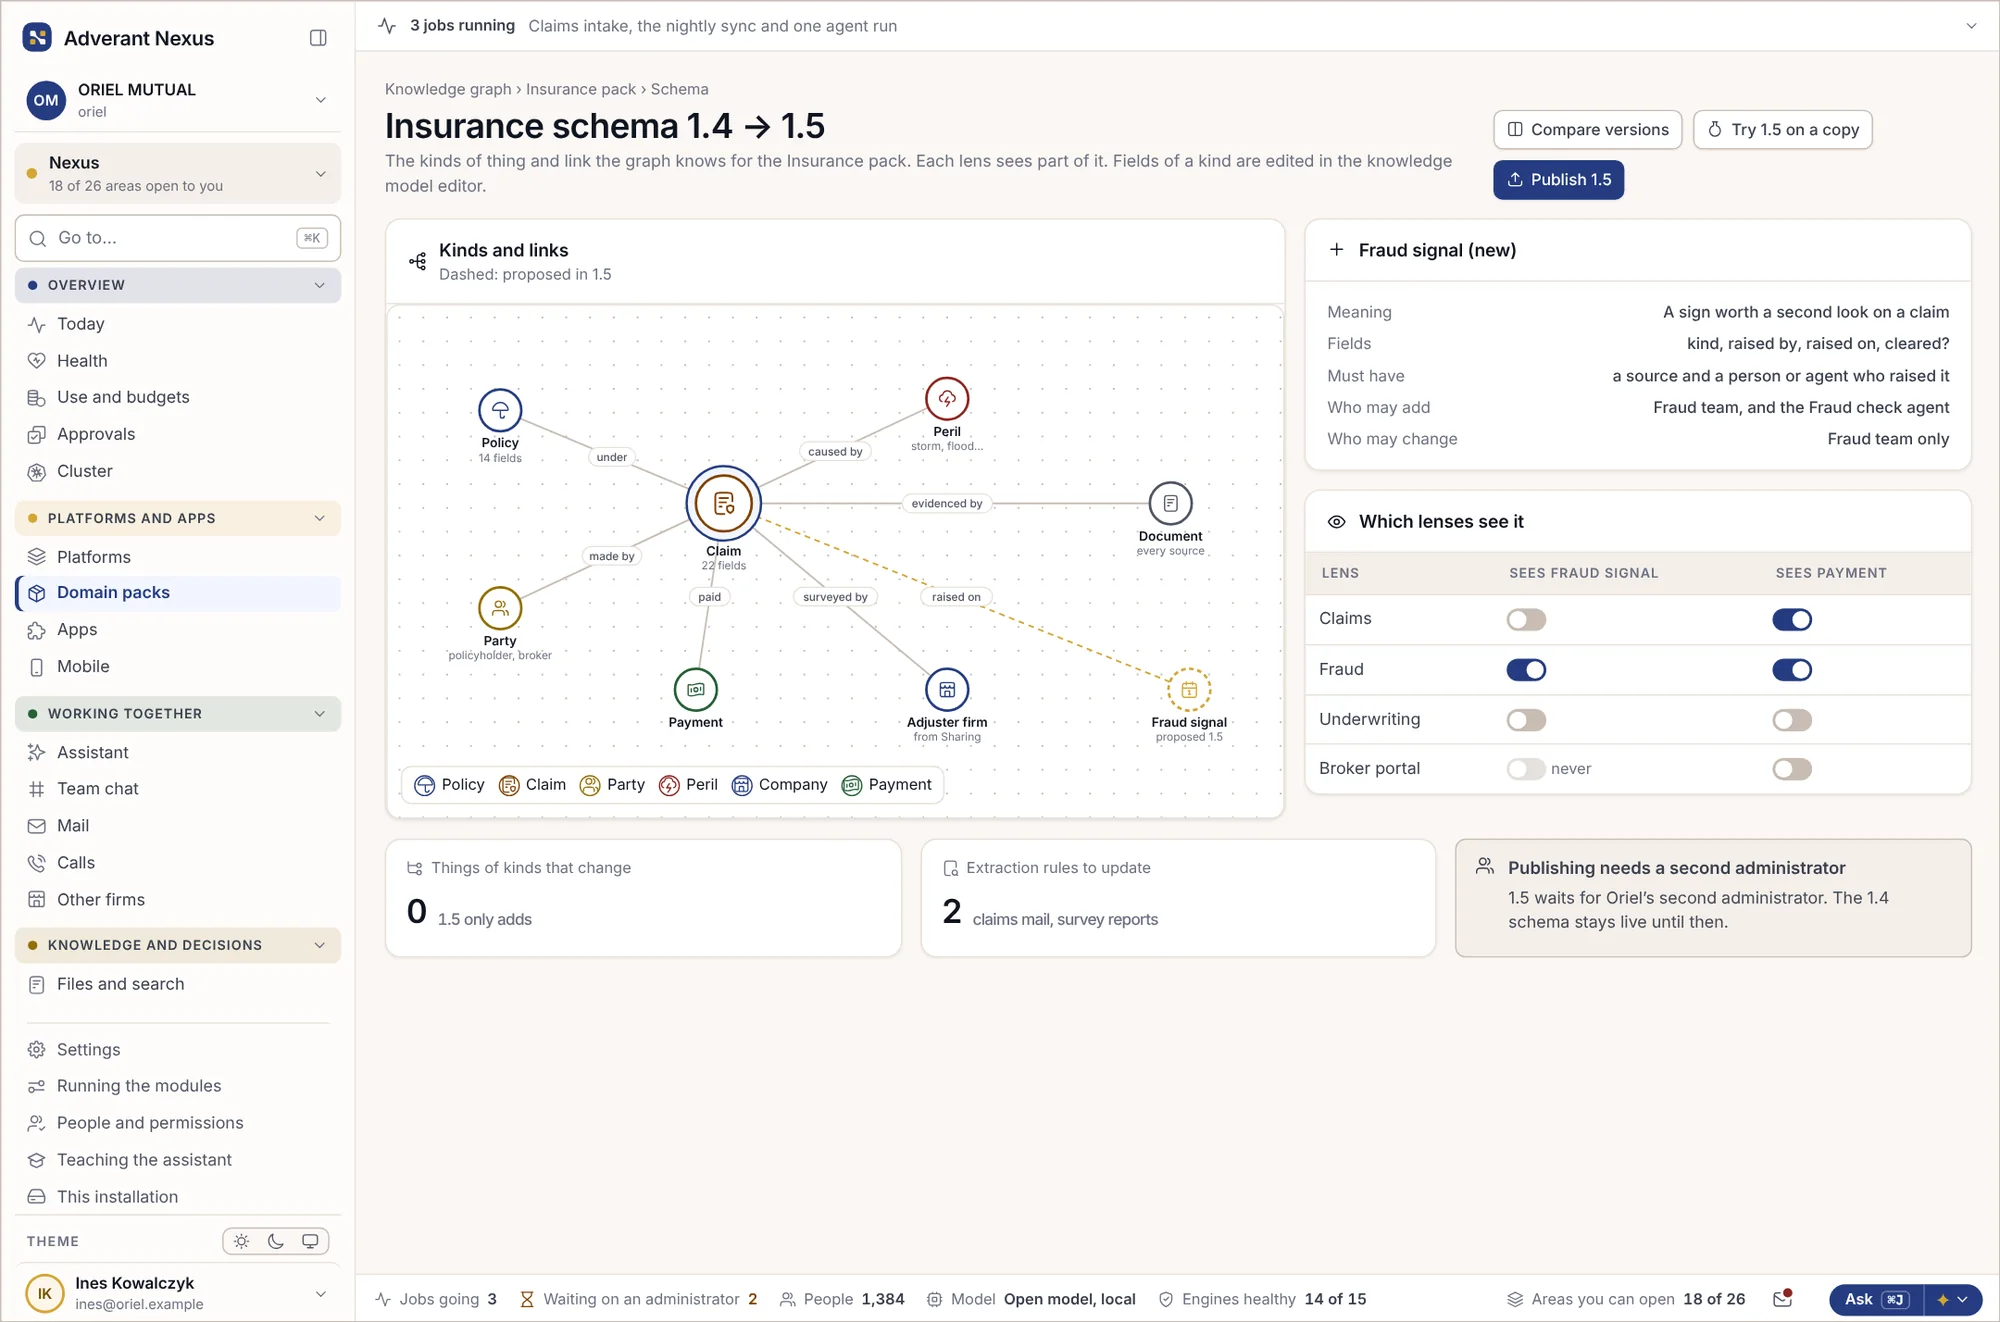
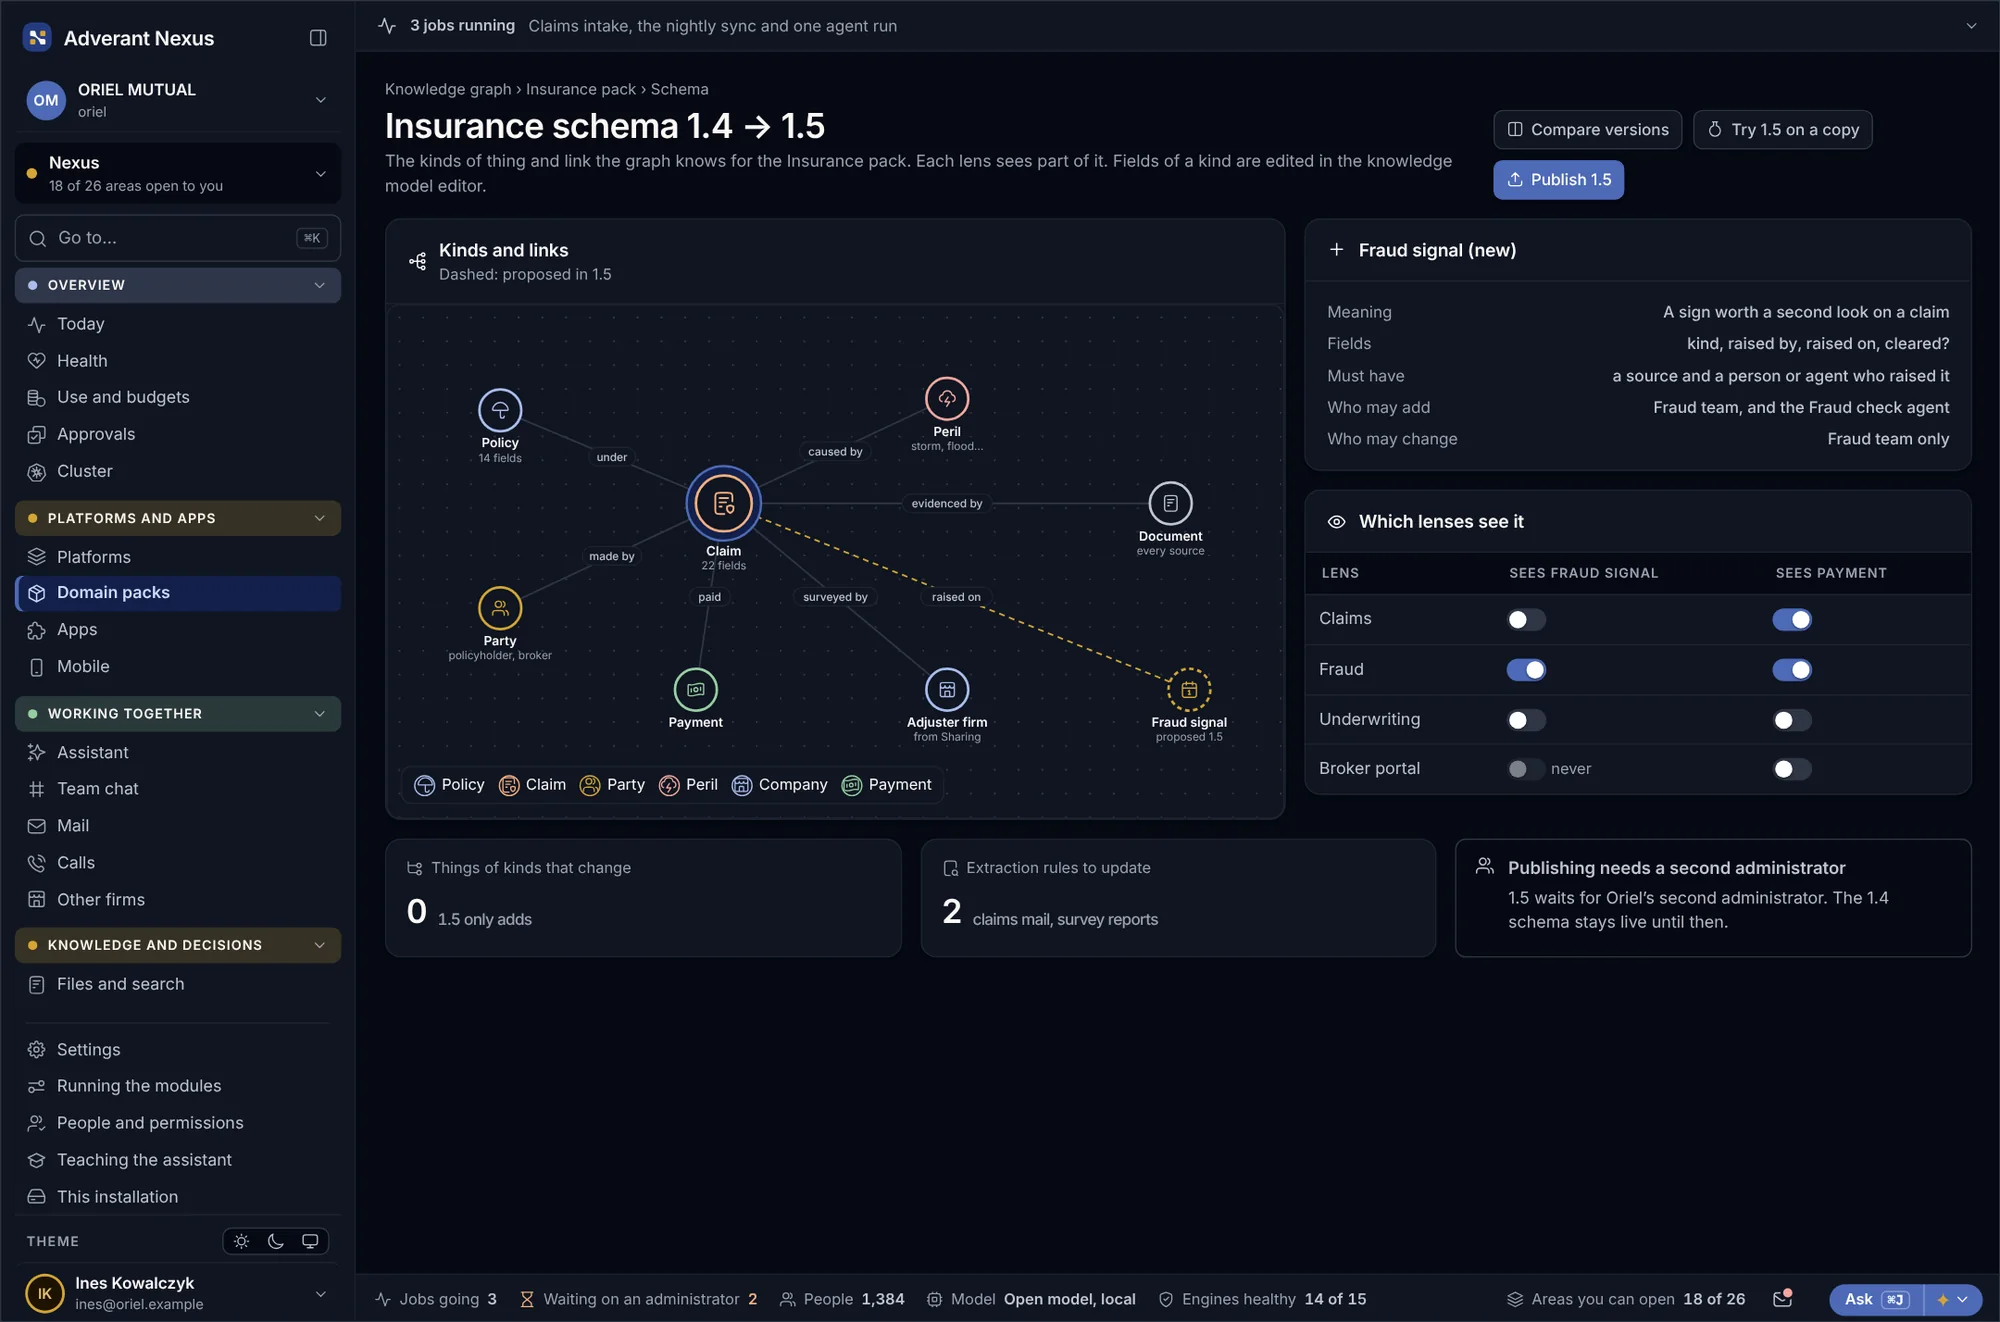
Schema unui domeniu
Adăugați un nou tip de entitate în schema unui domeniu și alegeți ce perspective îl pot vedea.
- Tipuri, proprietăți și legături pe ecran
- Perspectivele decid ce vede fiecare rol
- Fiecare modificare are o versiune
Editorul modelului de cunoștințe
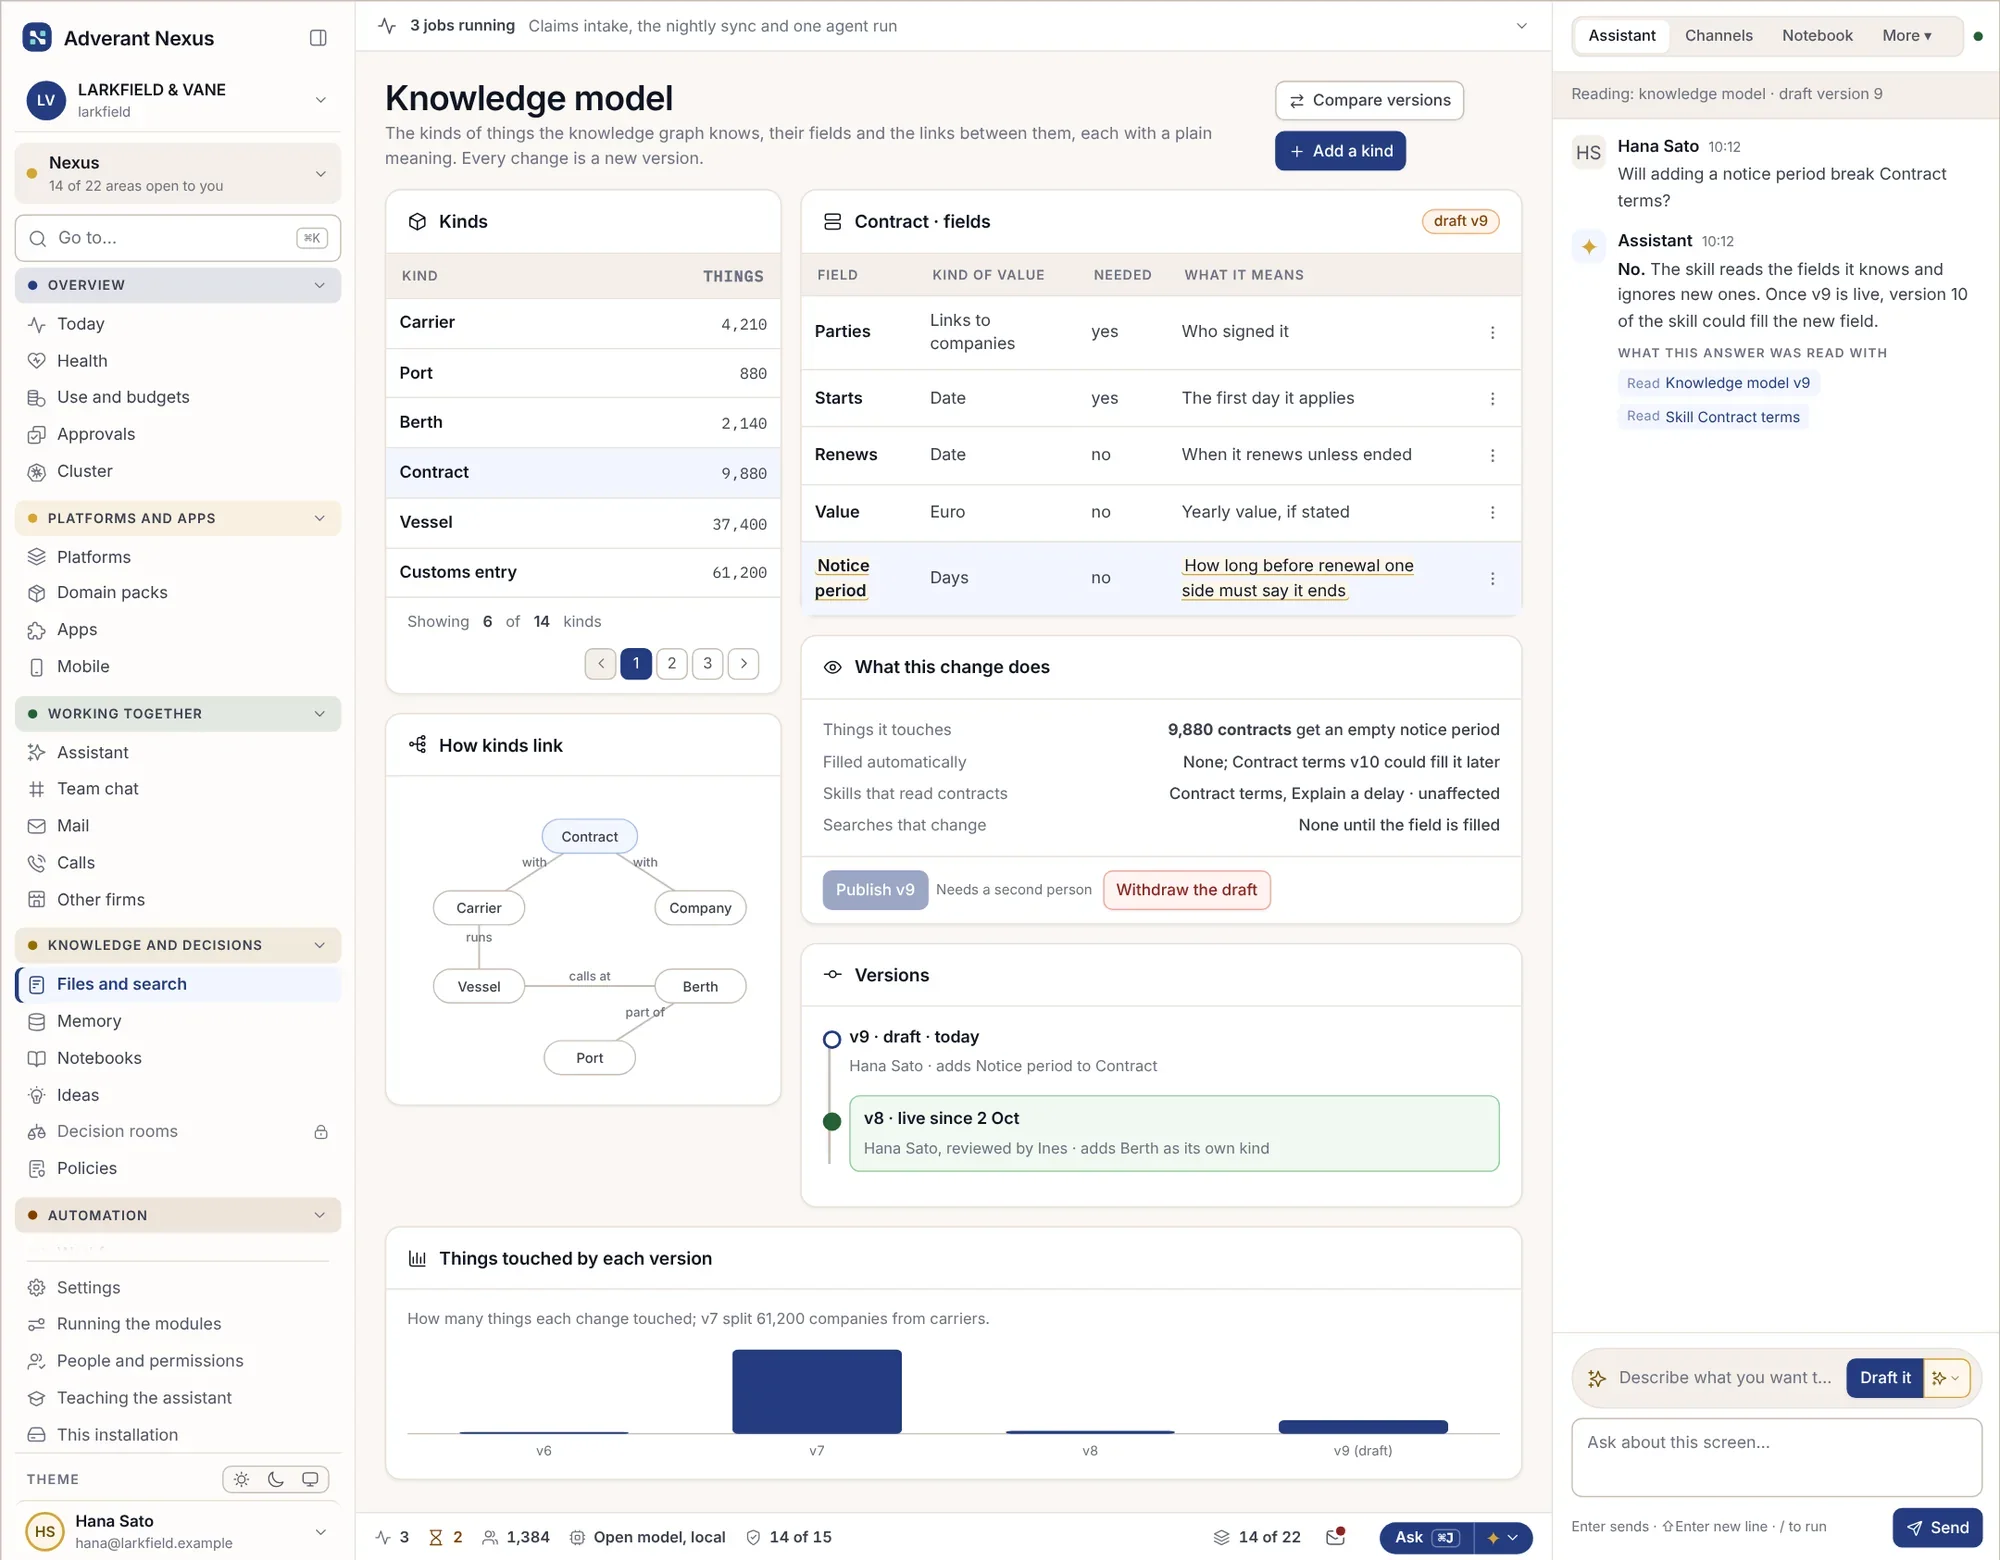
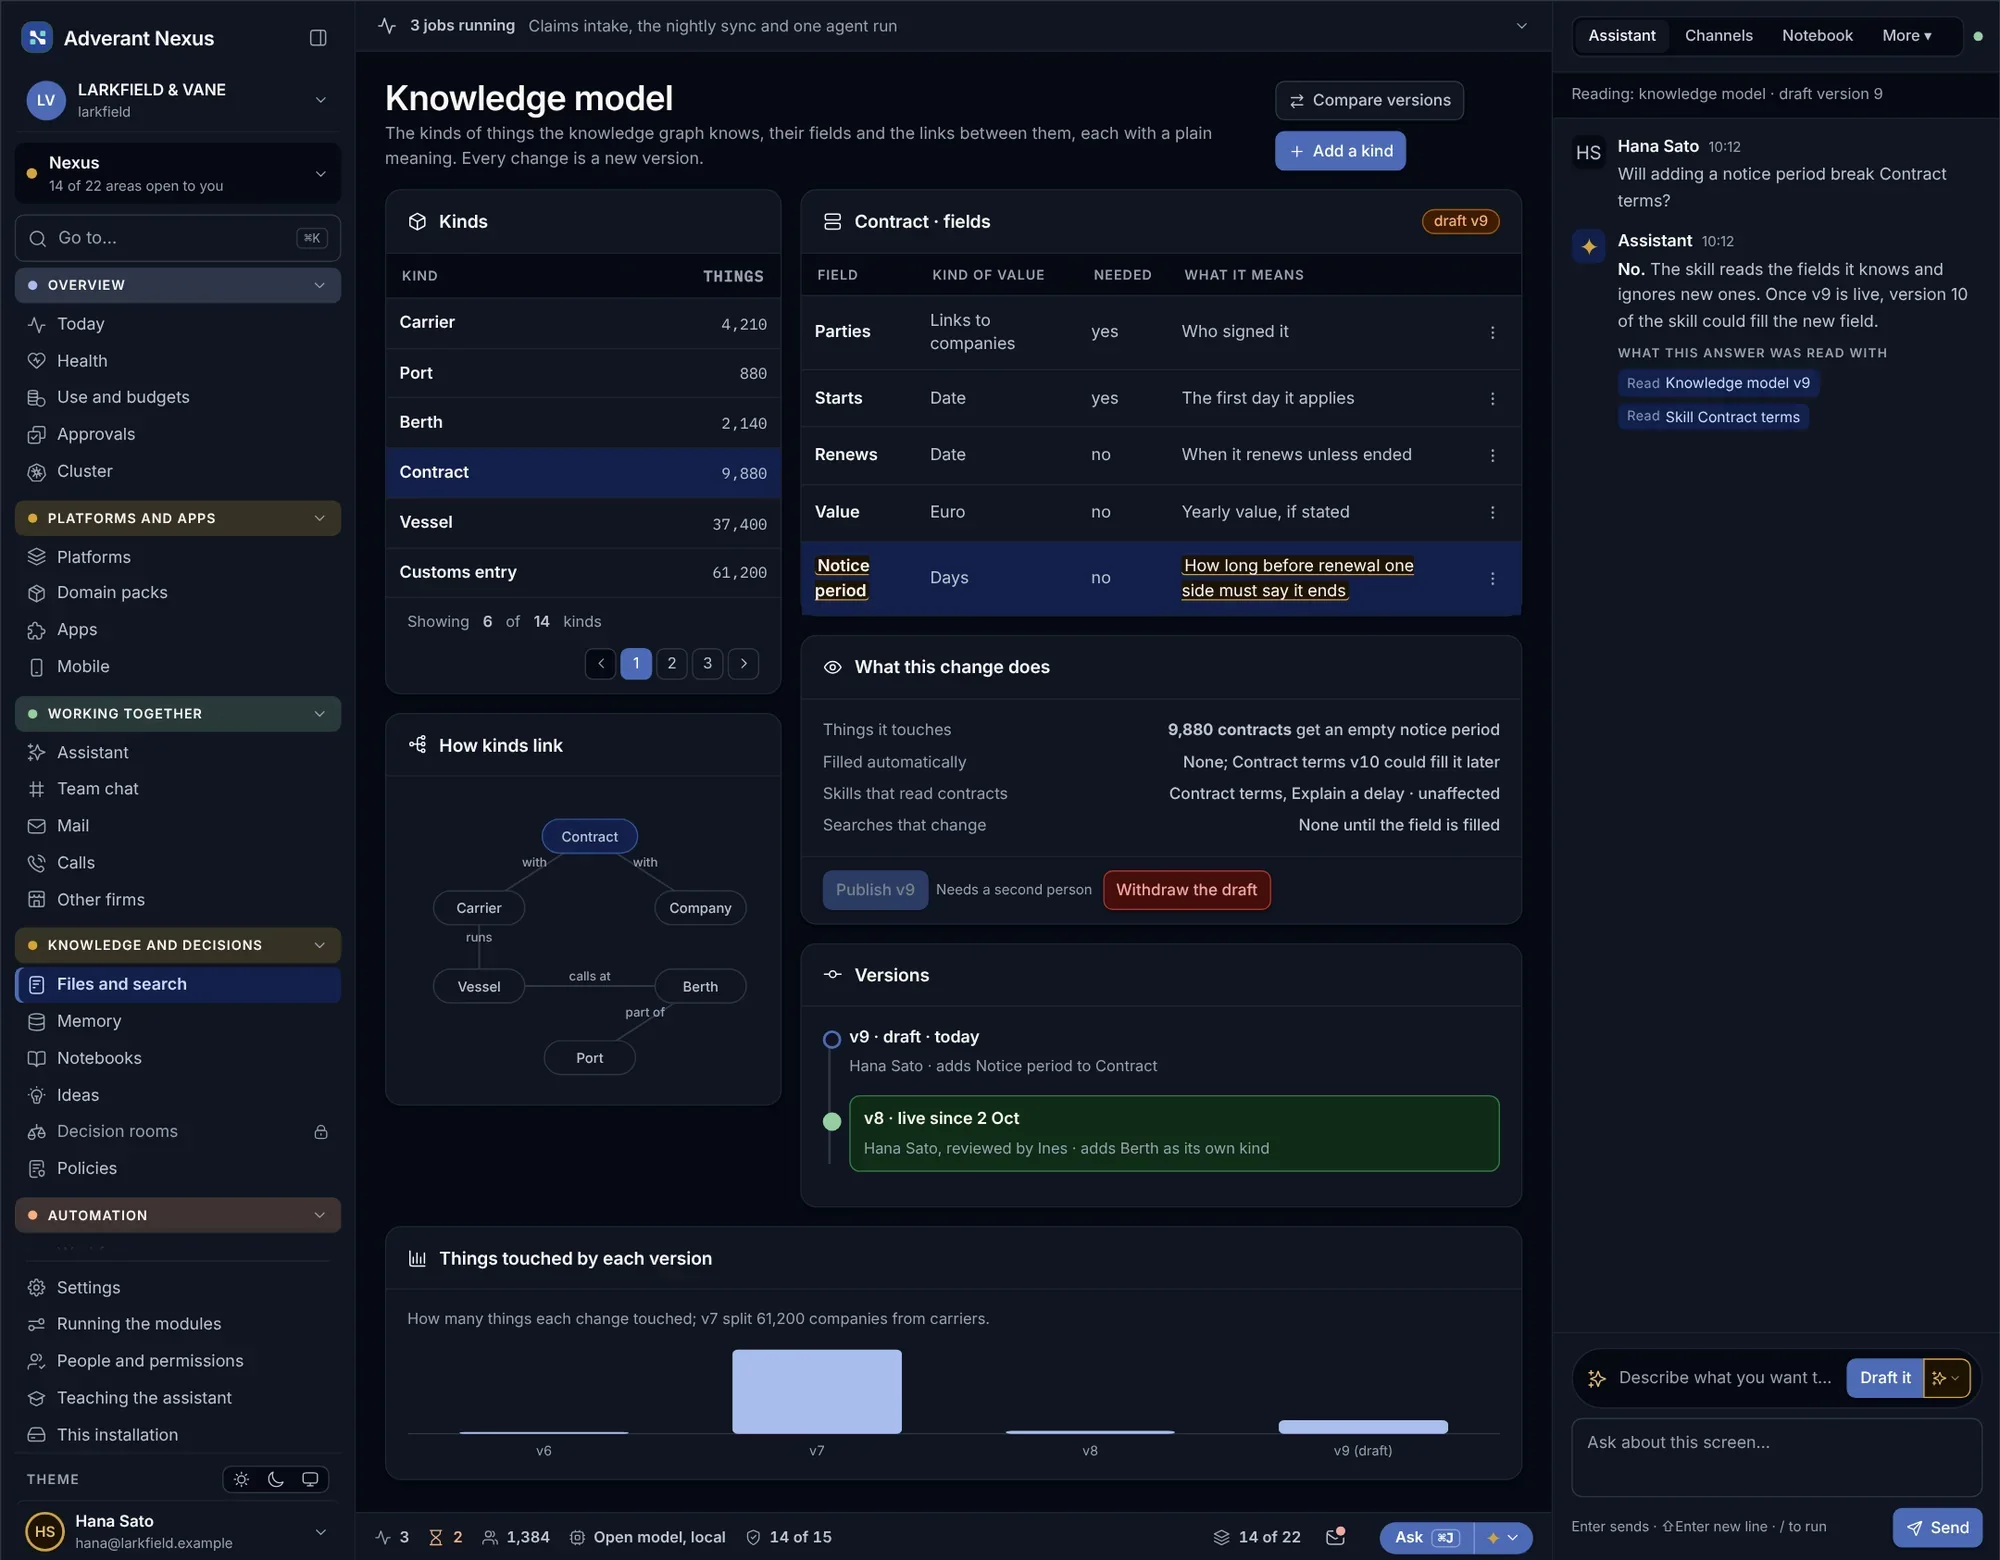
Adăugați o perioadă de preaviz la contracte și vedeți fiecare înregistrare afectată înainte de aplicarea modificării.
- Impact afișat înainte de salvare
- Reversibil
- Revizuit ca un cod sursă
Porniți de la un model sectorial
Pachetele de domeniu oferă un model de bază. Adăugați peste acesta tipurile de entități specifice doar companiei dvs.
- Modele de bază pentru fiecare sector
- Propriile tipuri adăugate peste bază
- Actualizările vă păstrează adăugirile
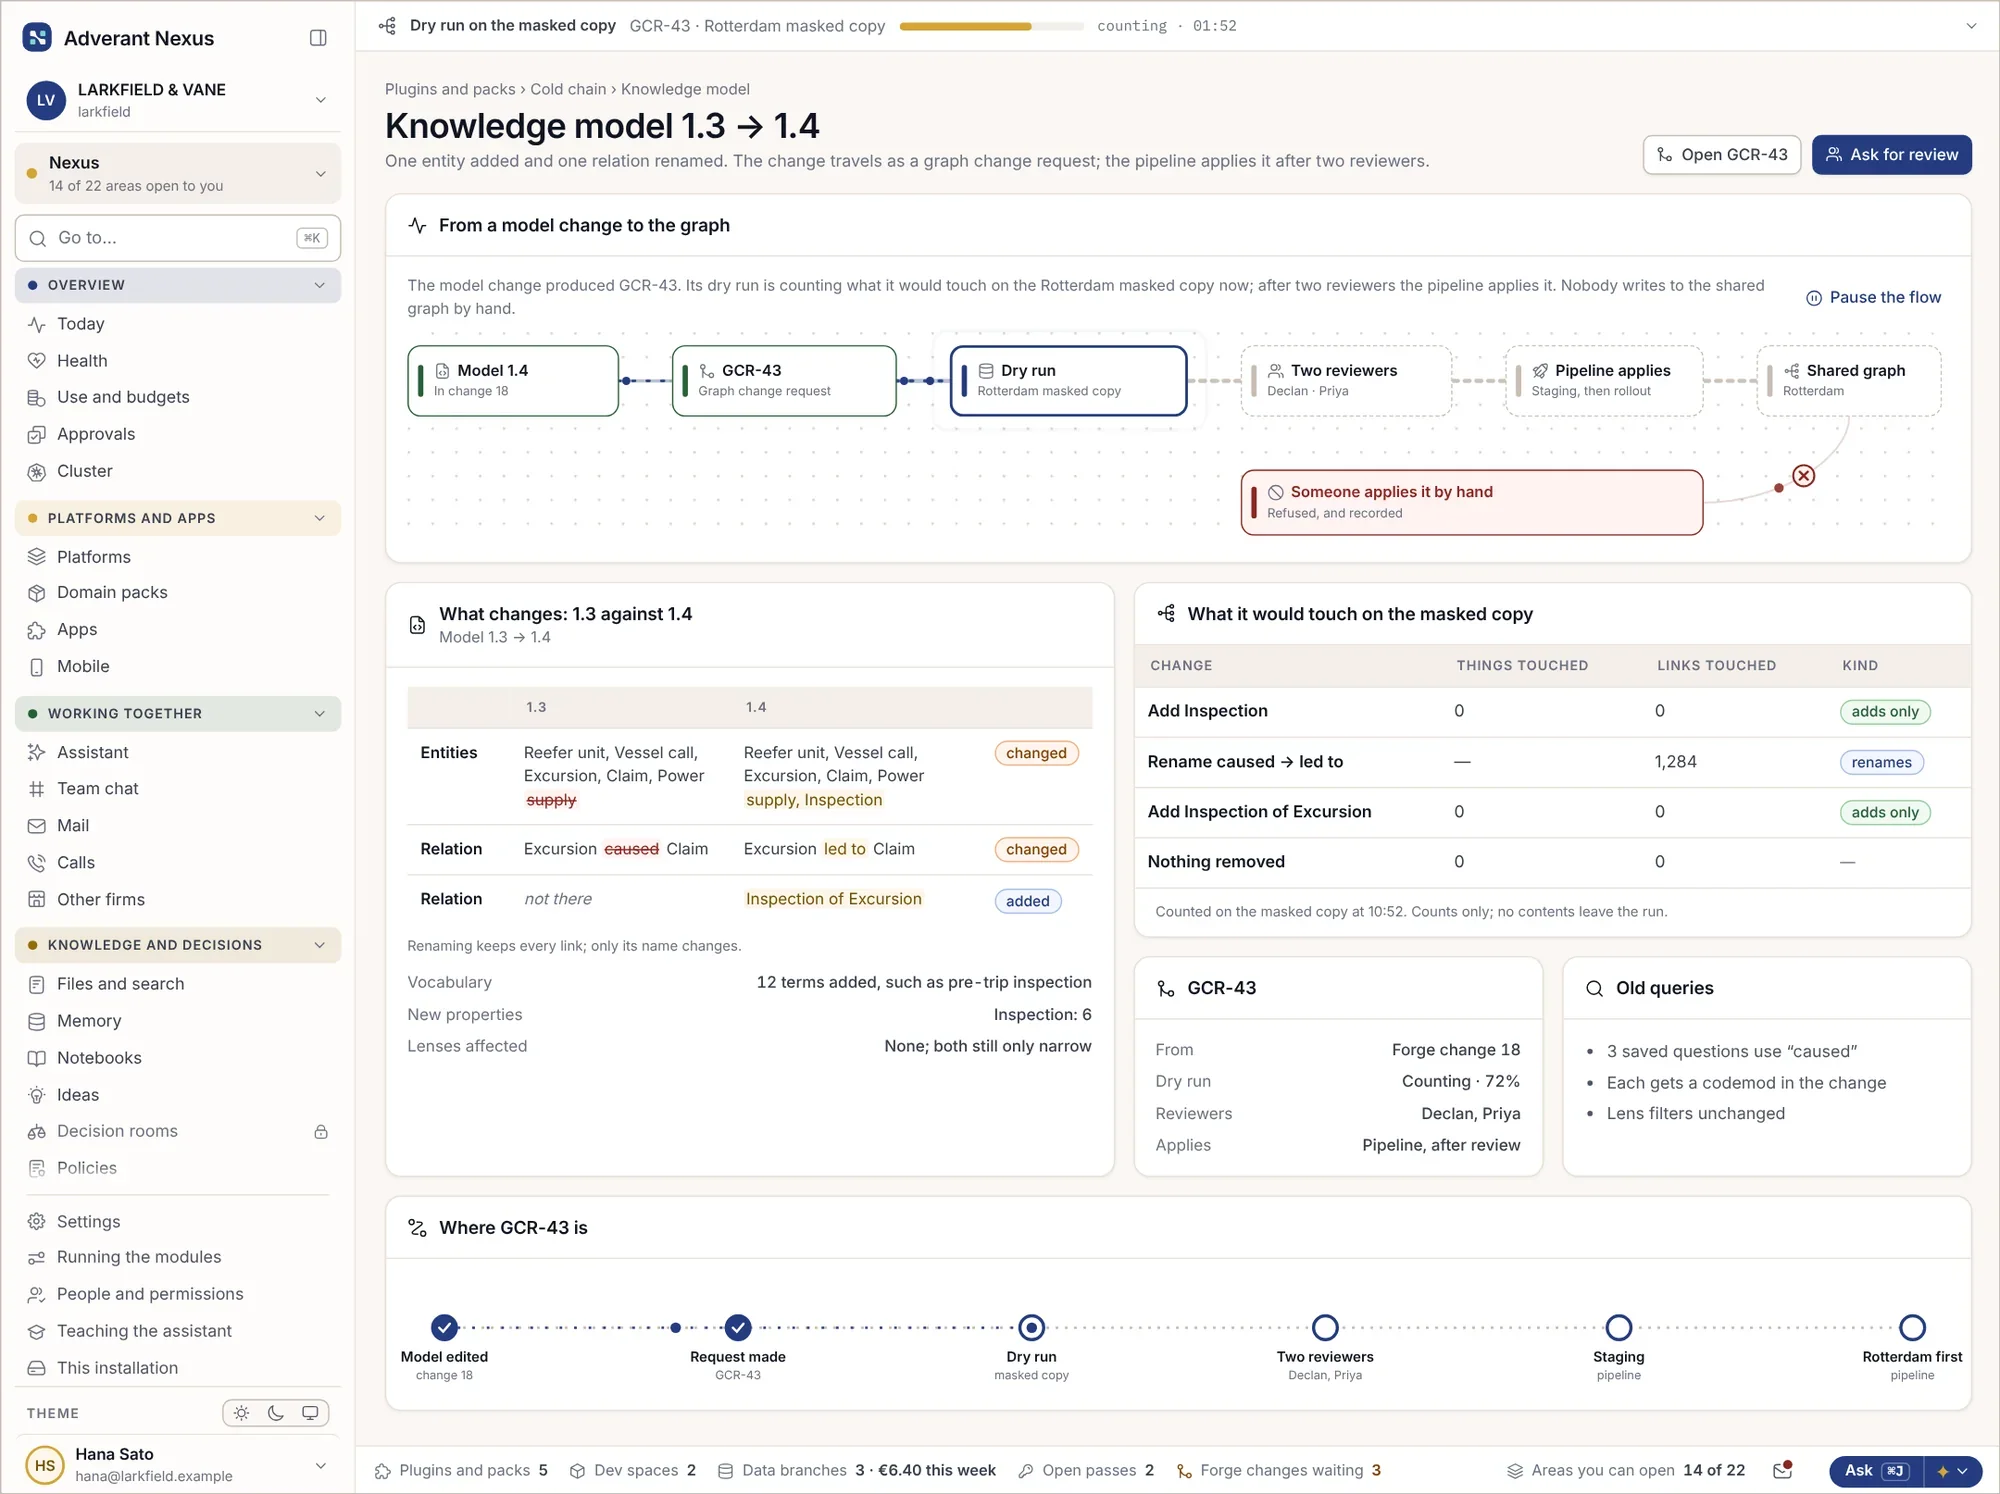
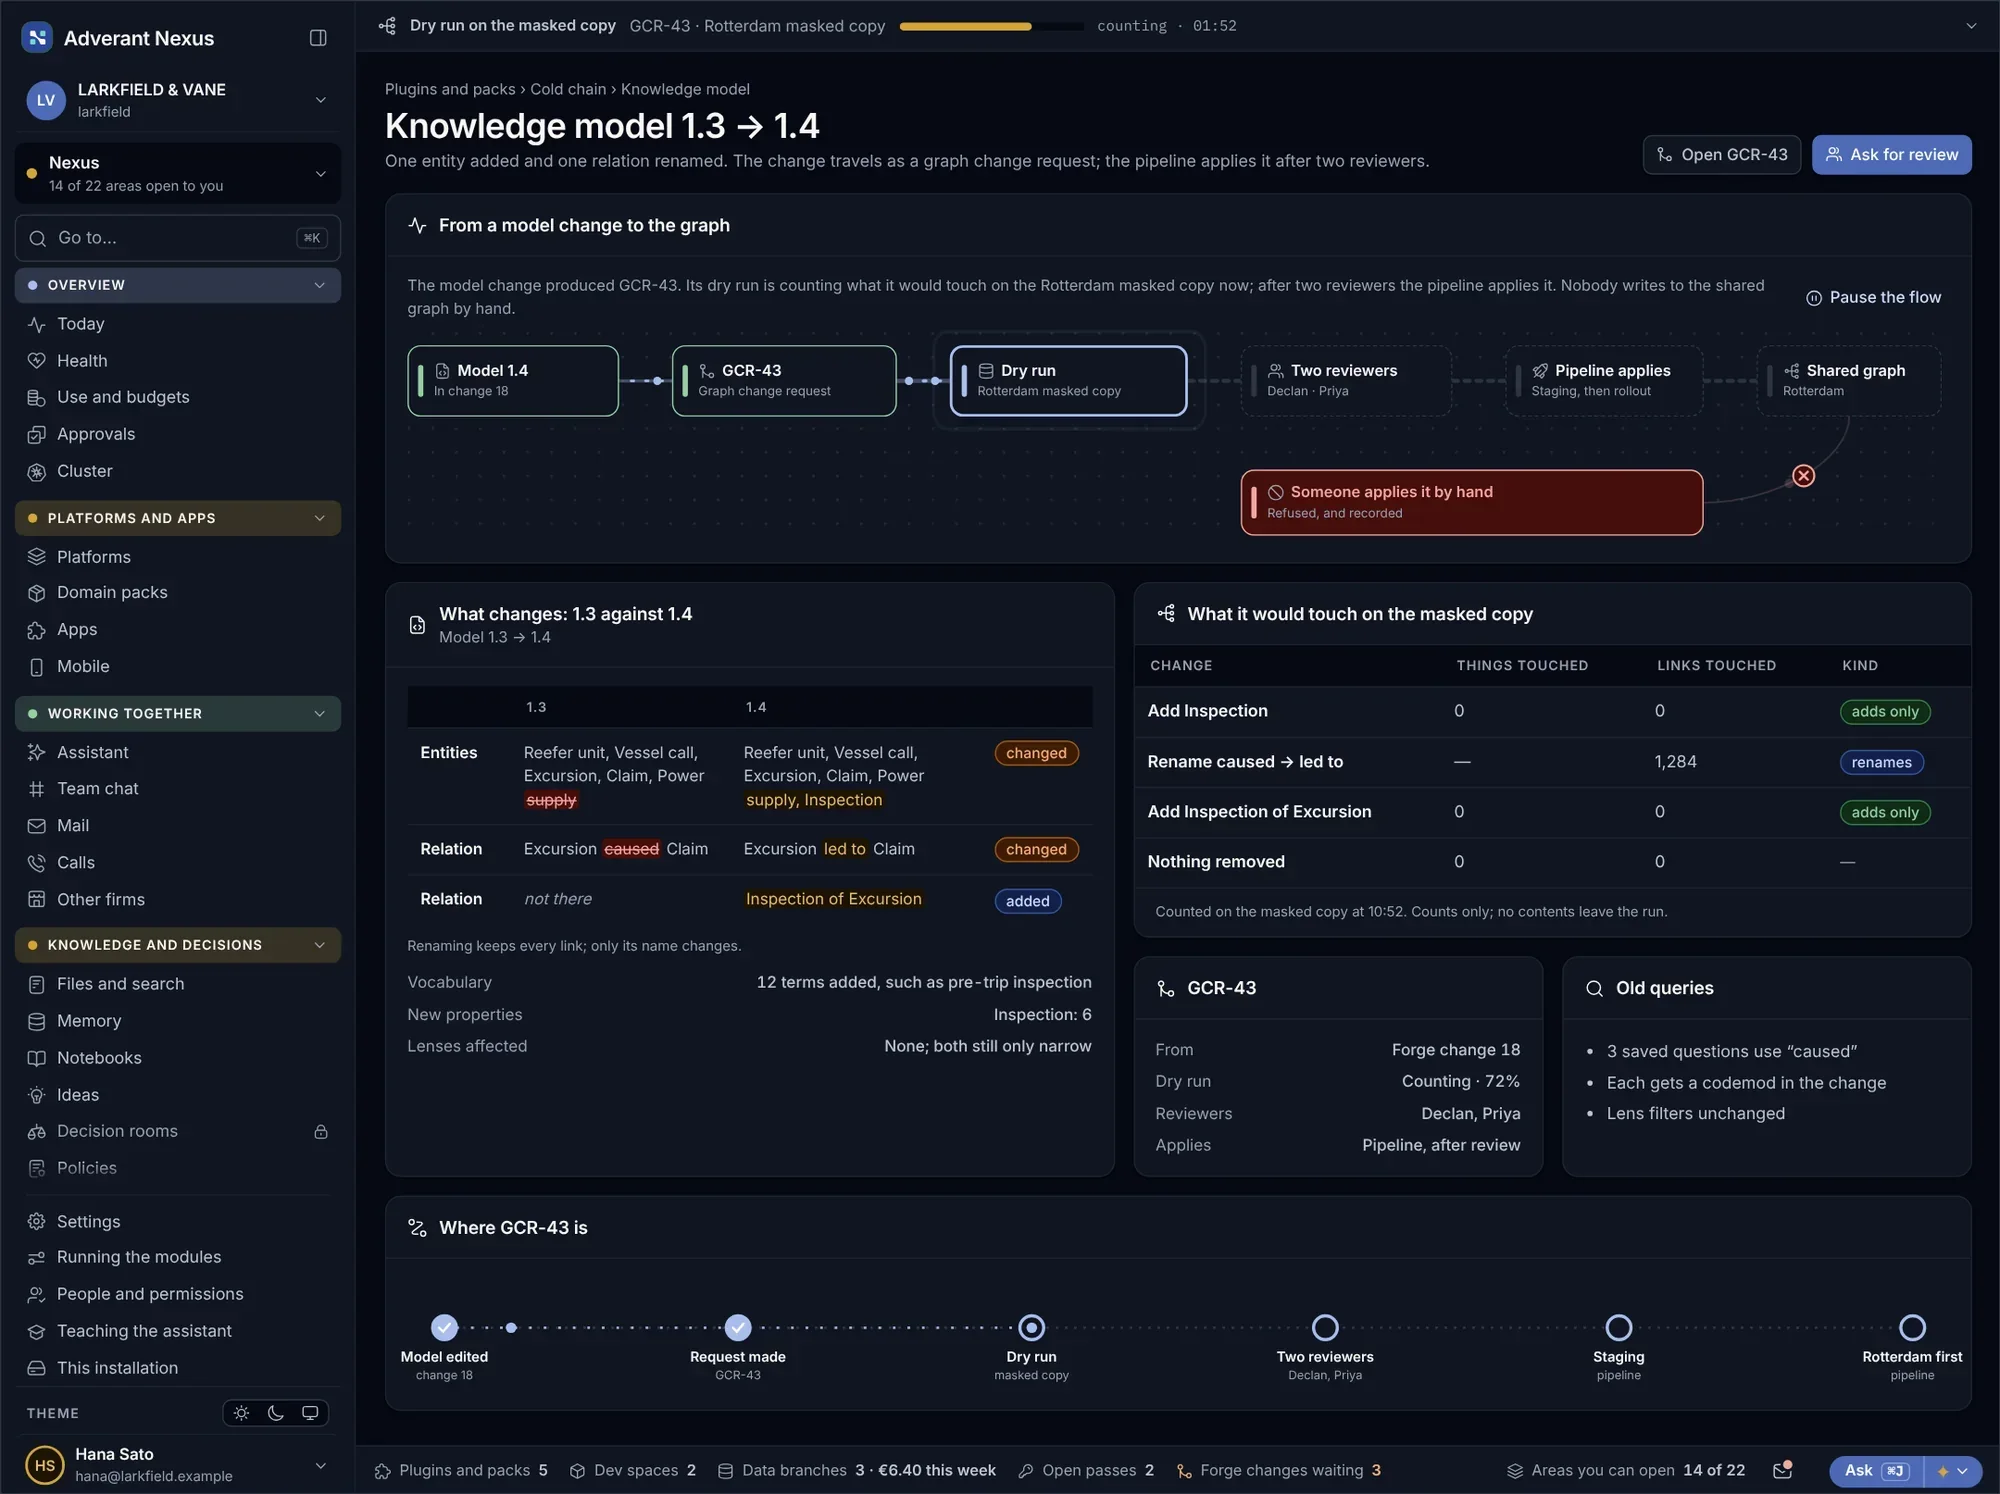
Modificați modelul în siguranță
- Versiuni comparate în paralel
- Simulare pe o copie mascată
- Cale de revenire pentru fiecare modificare
Alimentat din documentele și sistemele dvs., verificat pe parcurs.
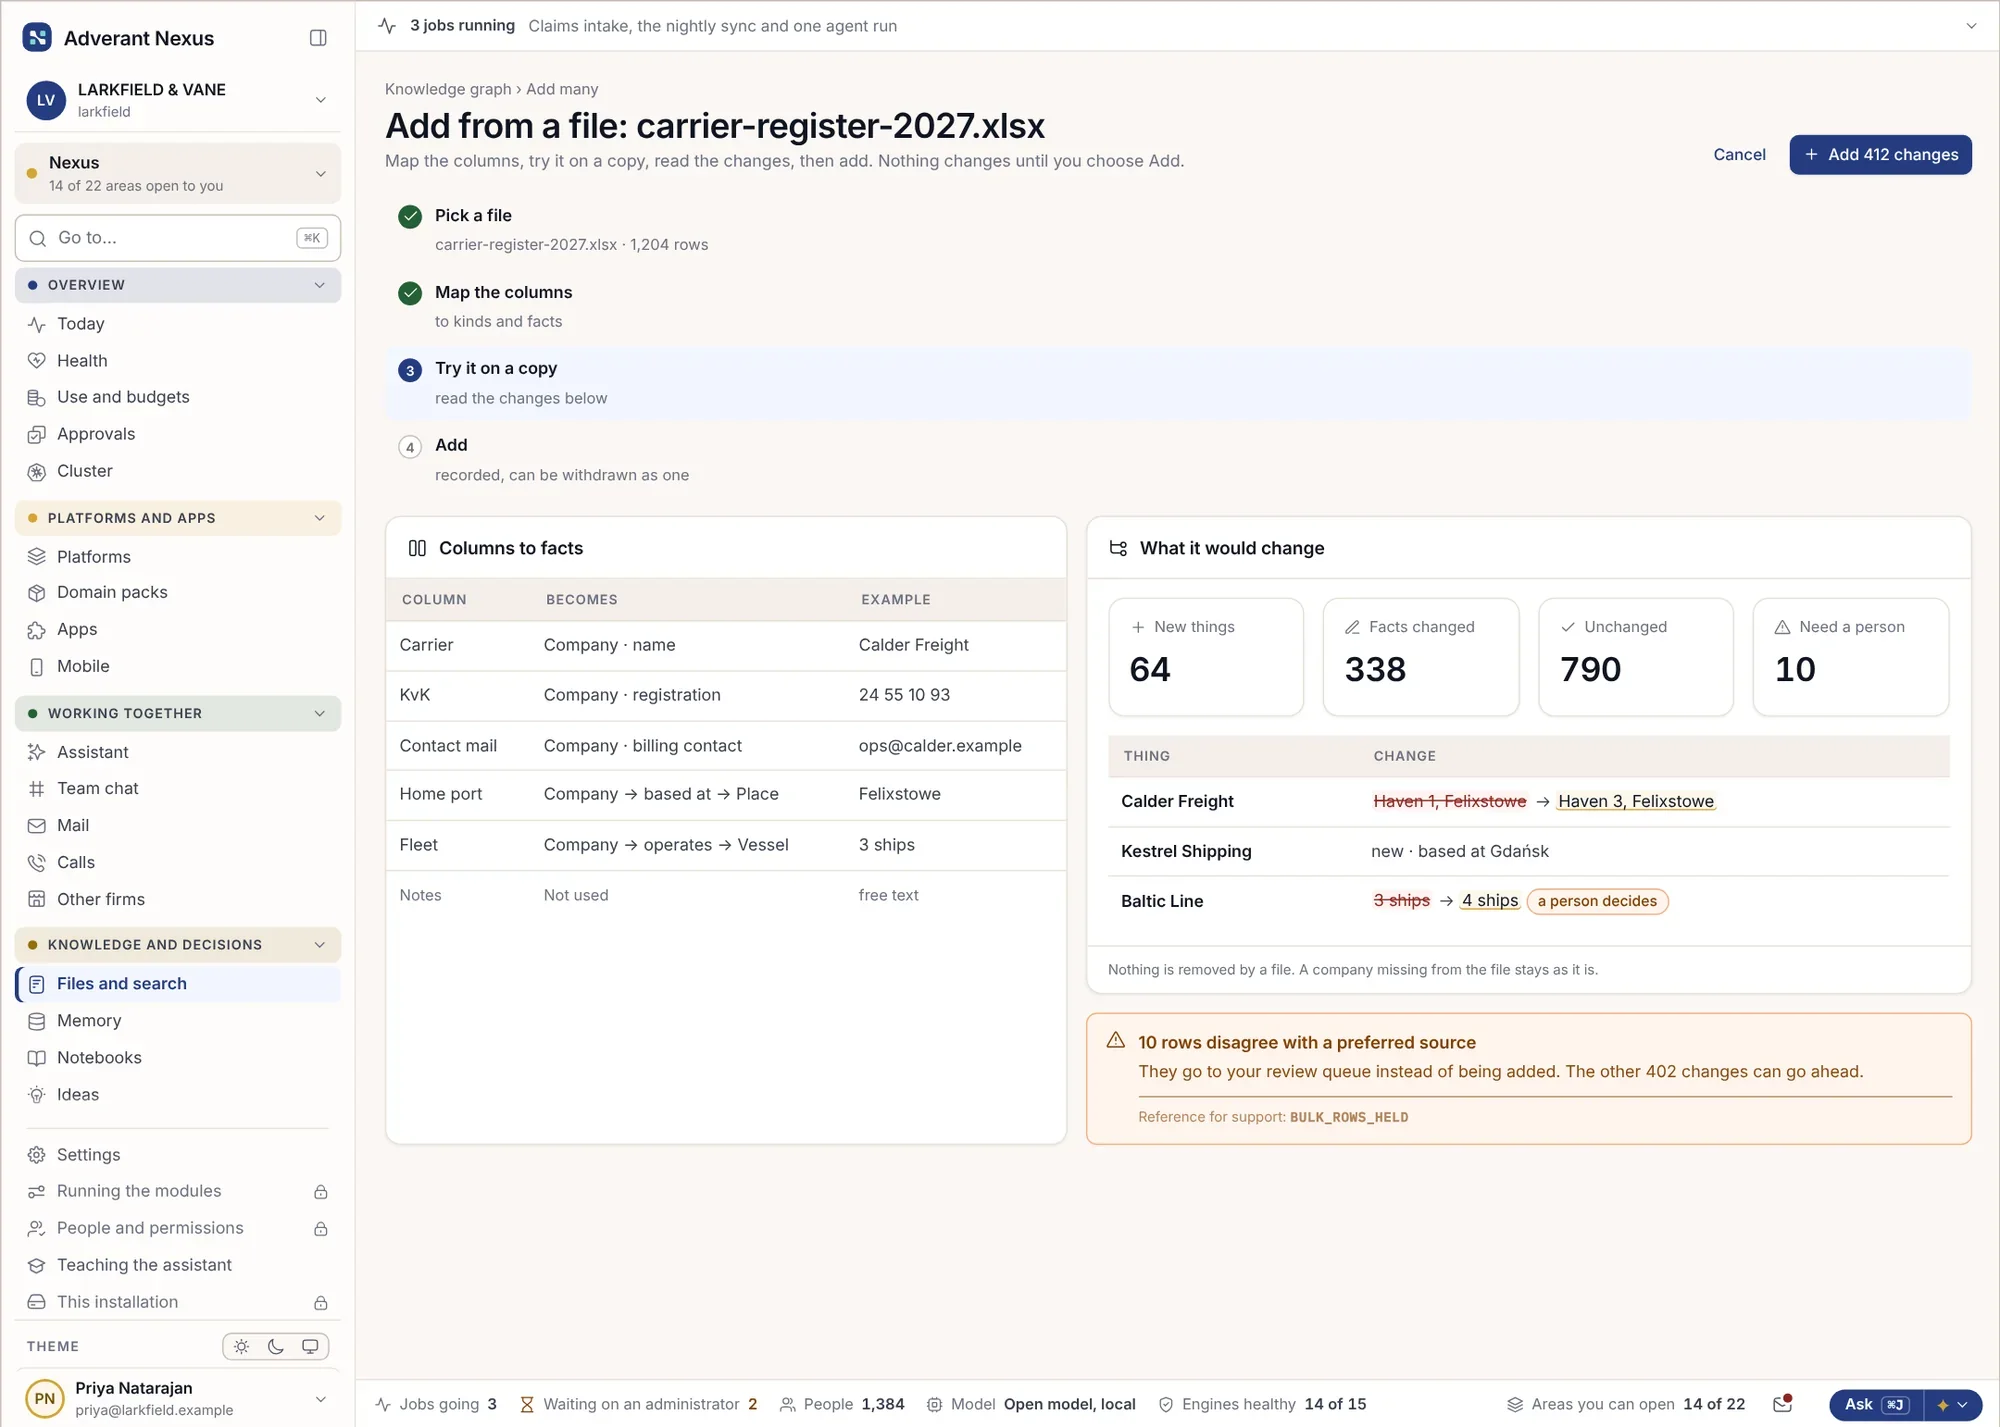
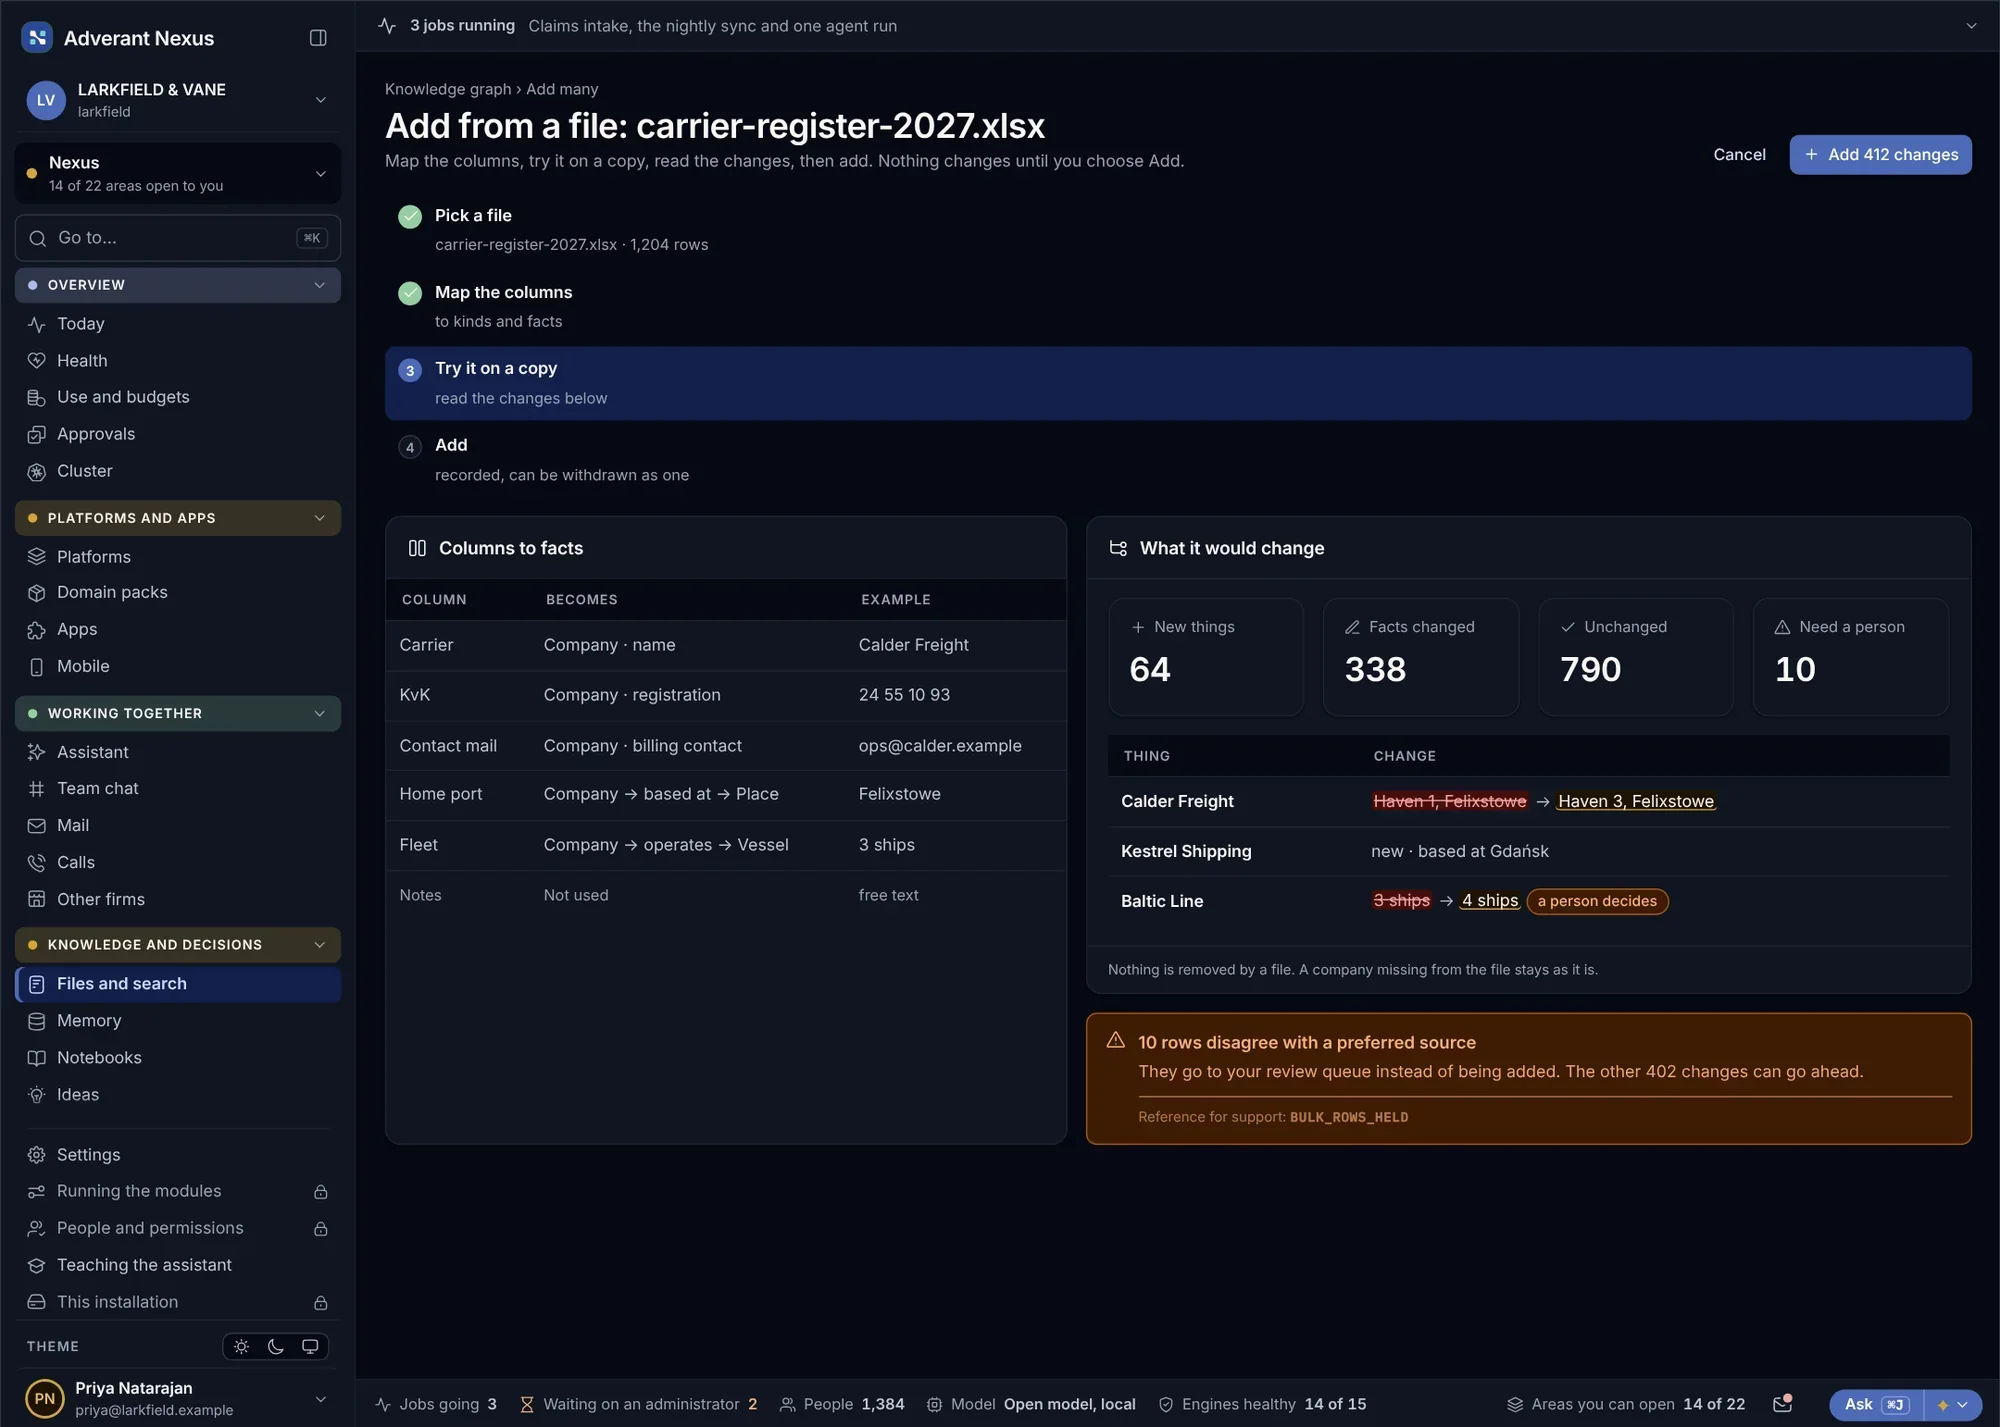
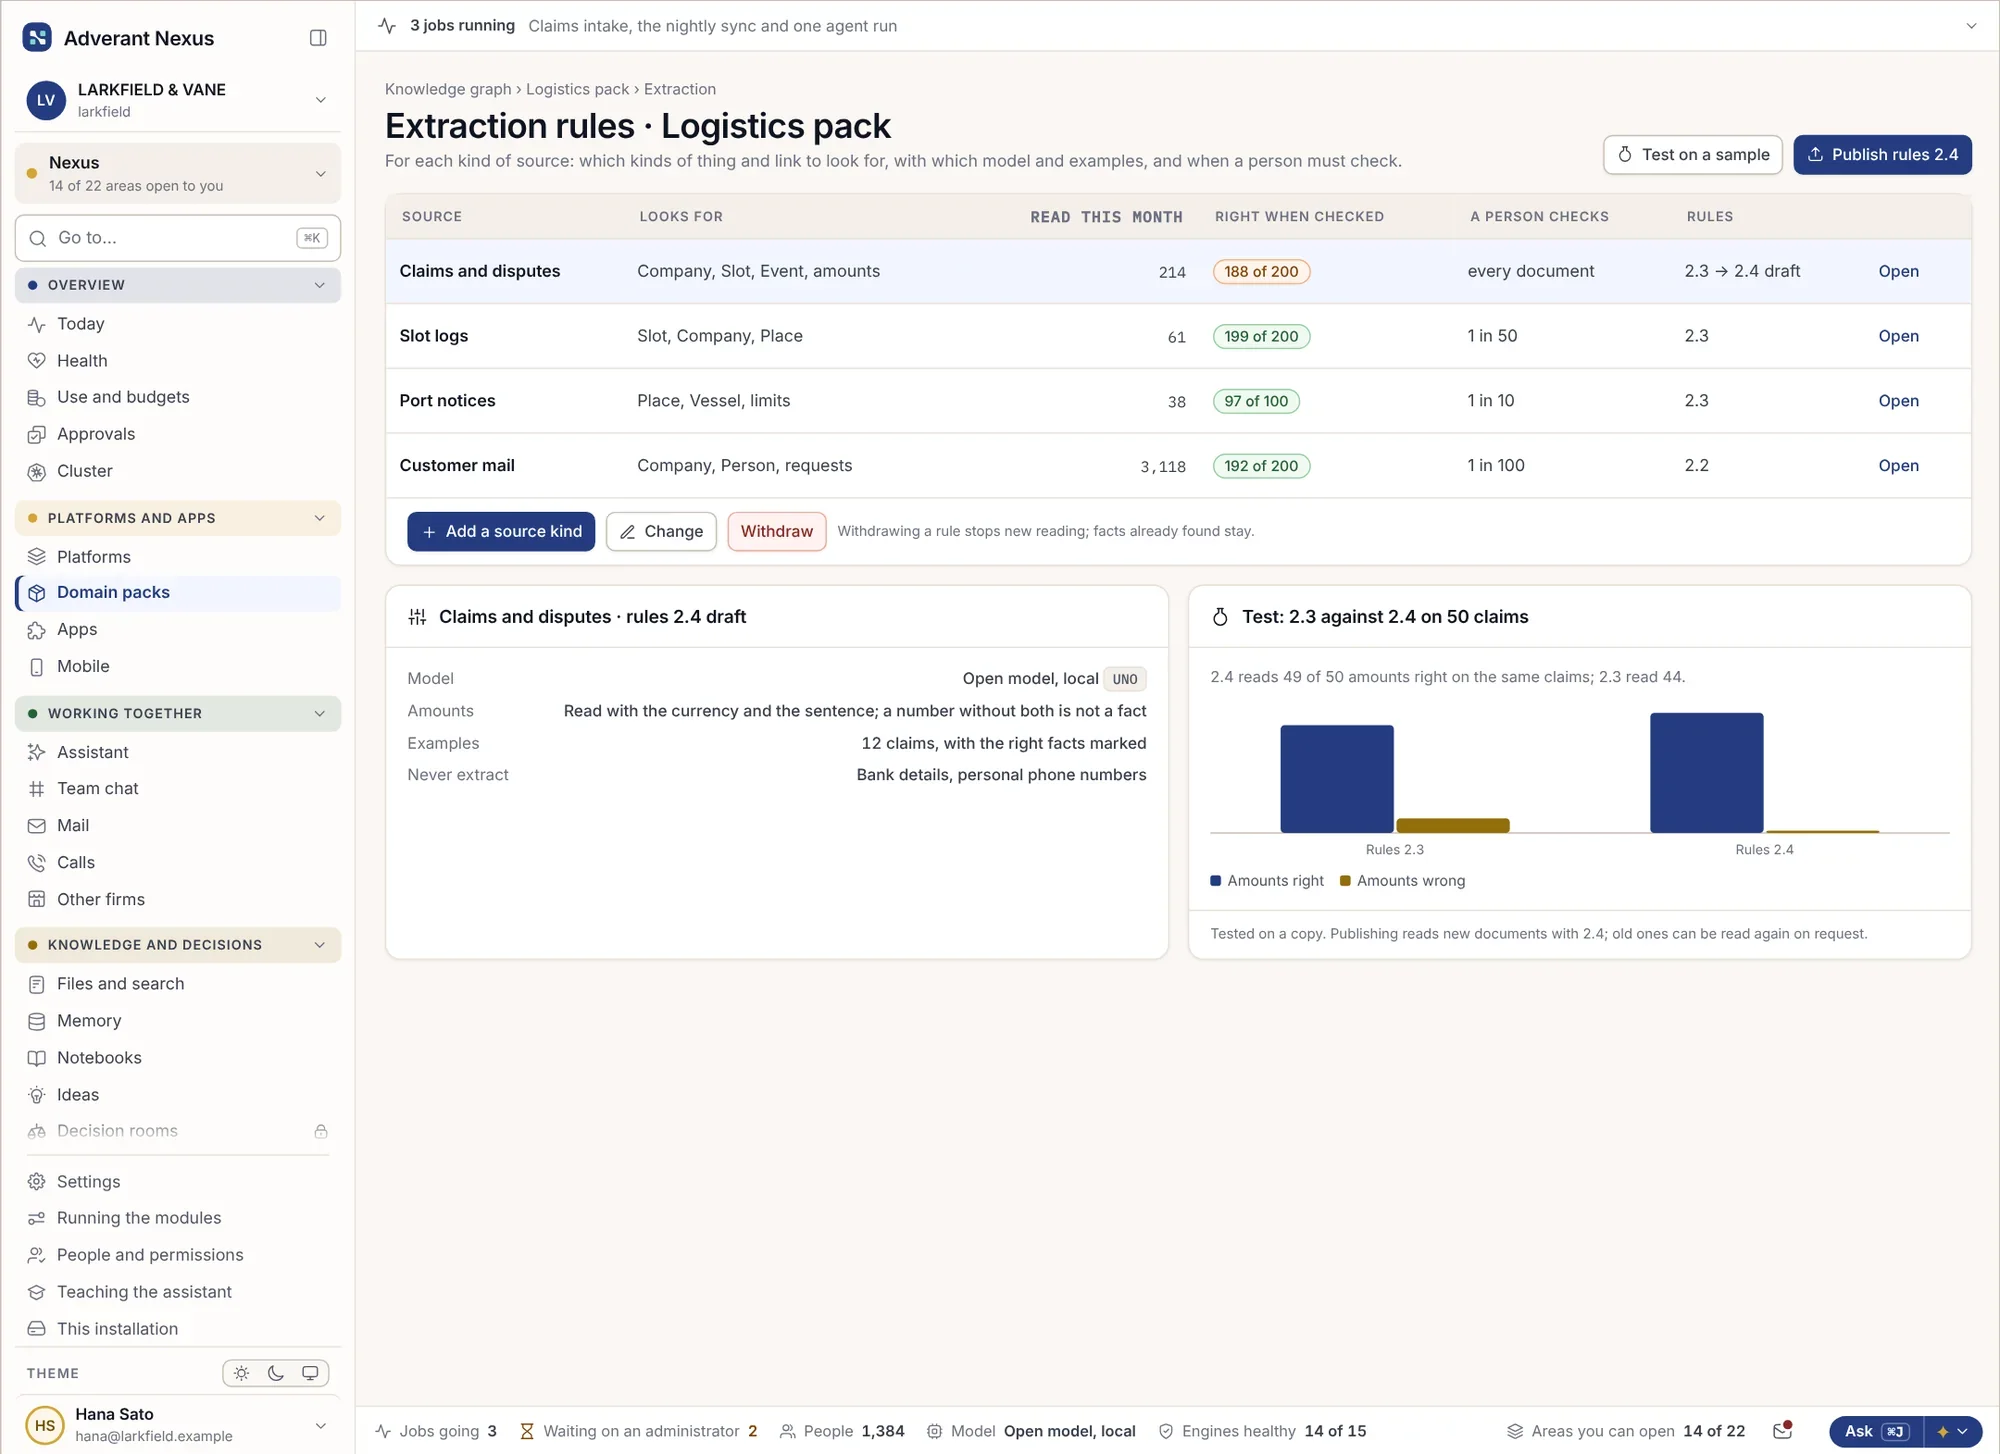
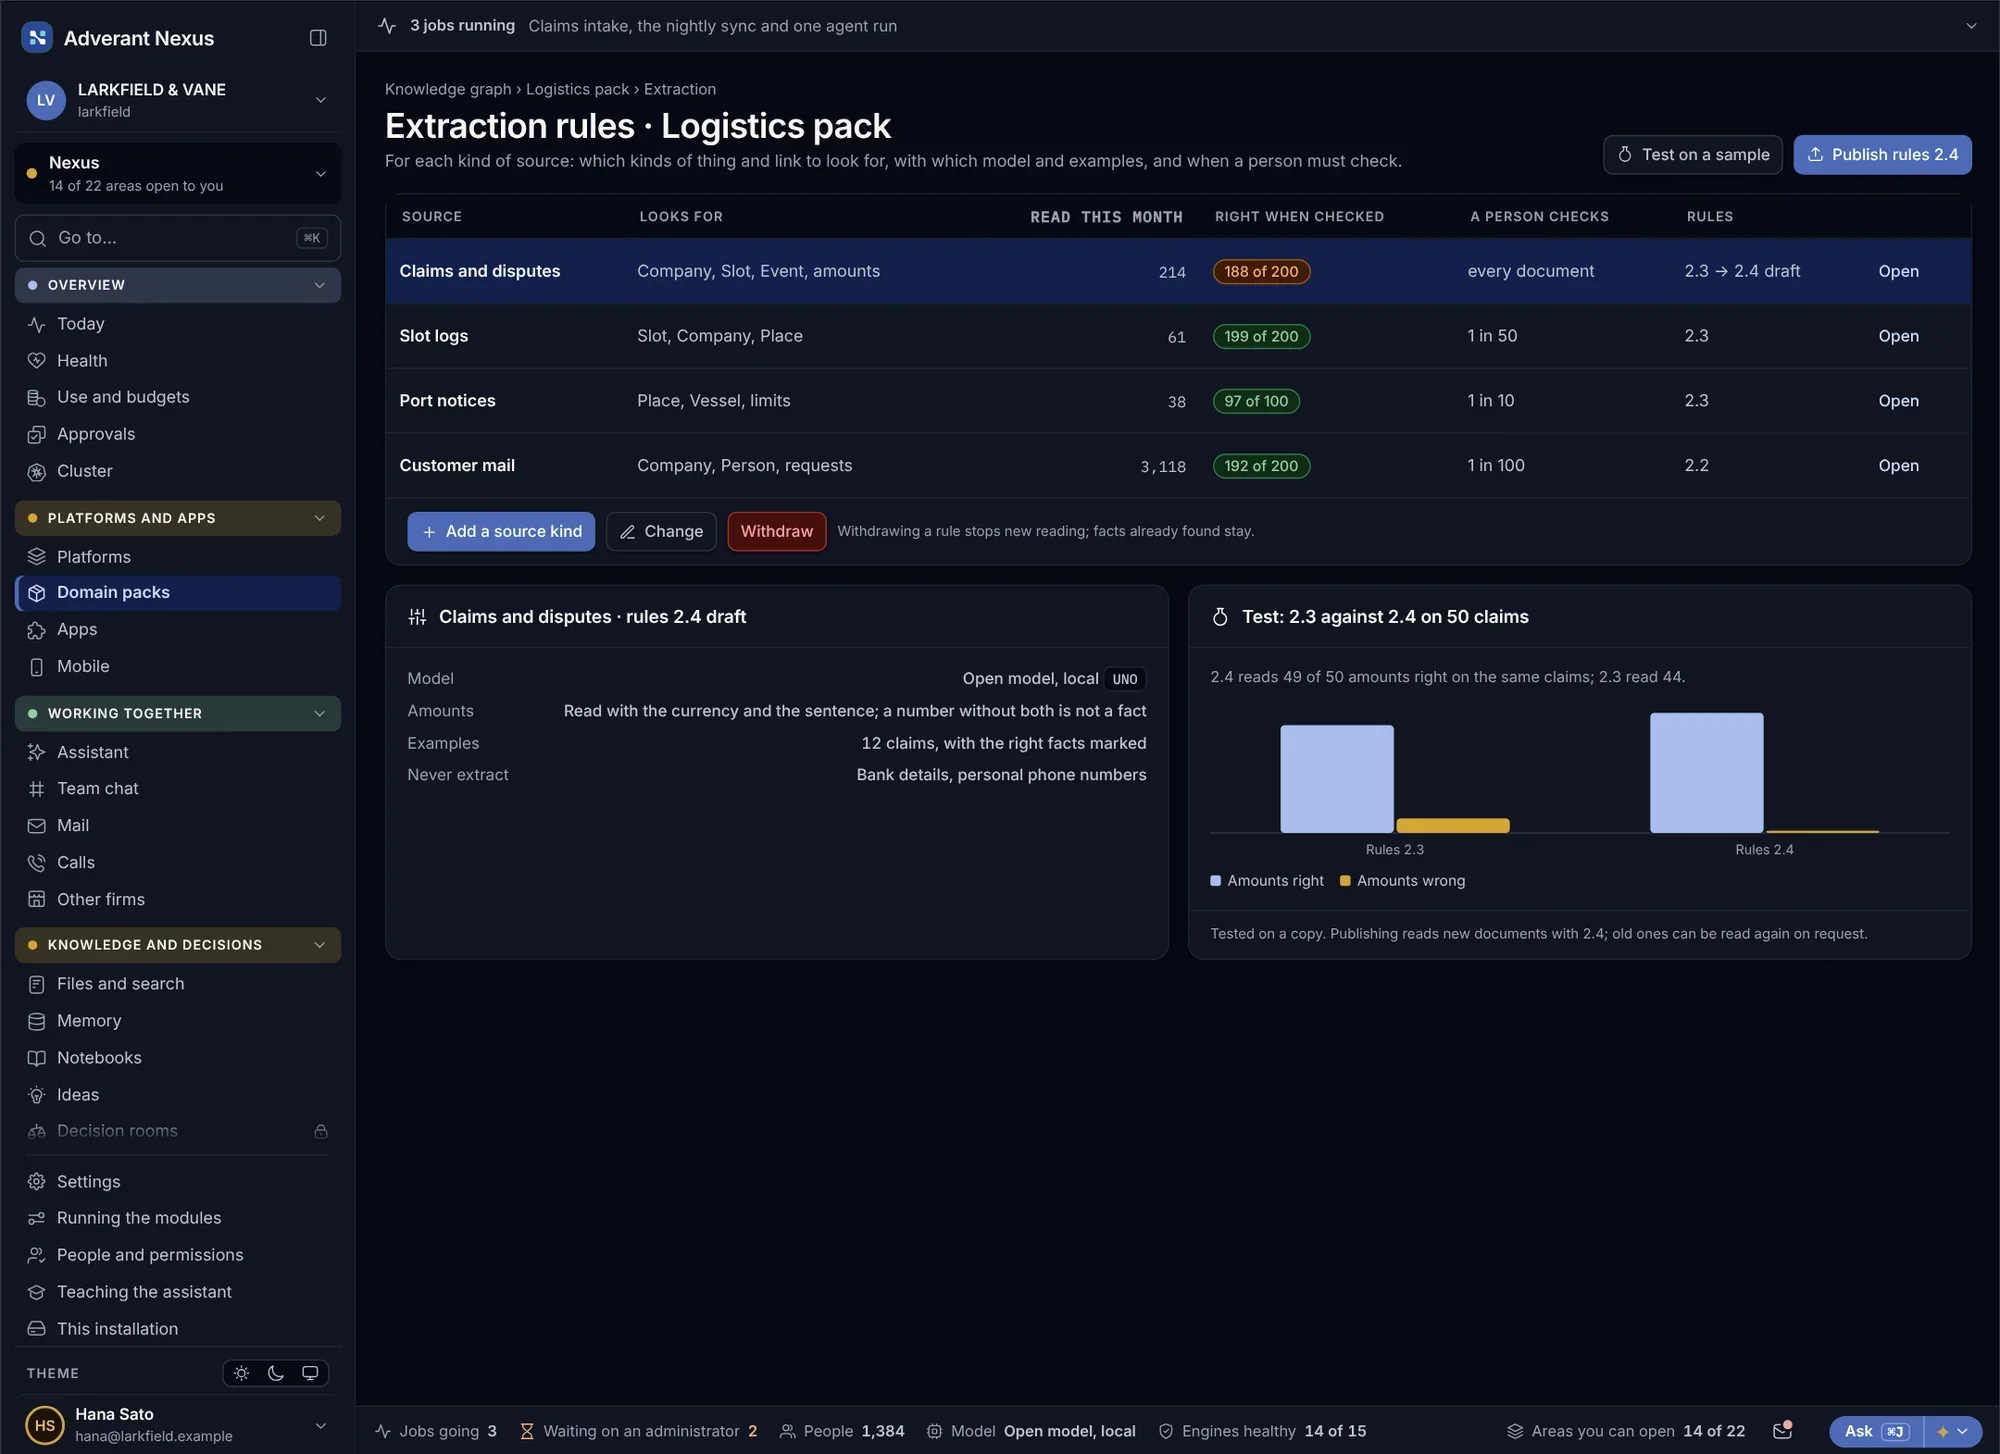
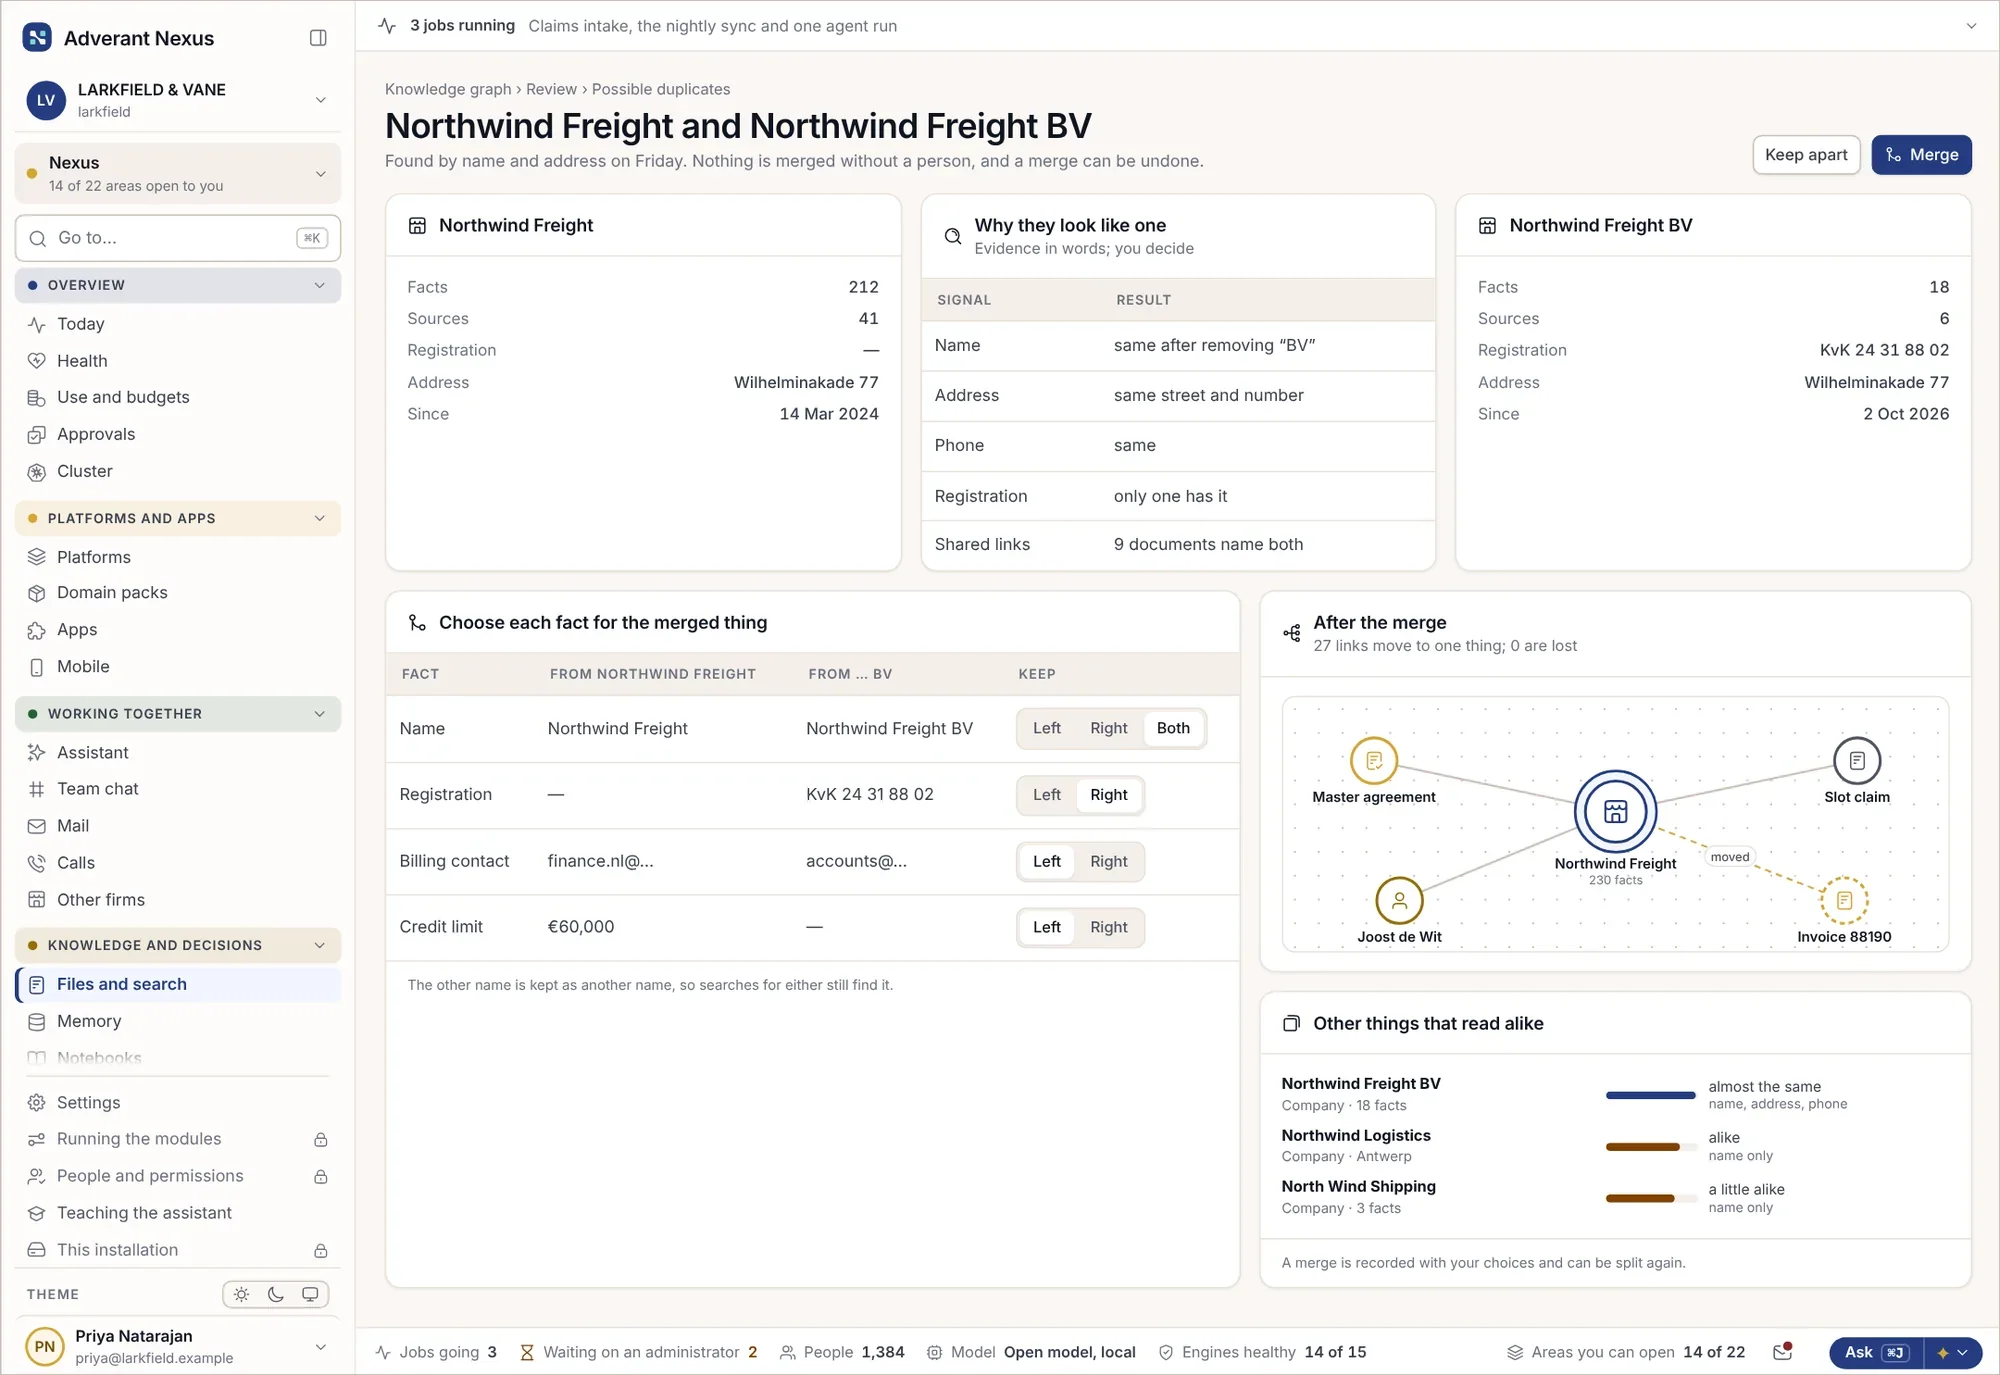
Informațiile sunt extrase din documente și încărcate din registre și baze de date. Regulile de extragere sunt testate înainte de a modifica ceva, încărcările mari își arată efectul înainte de rulare, iar duplicatele așteaptă decizia unei persoane.
Adăugare în masă
- Verificare înainte de încărcare
- Duplicate identificate
- Anulare în caz de eroare
Reguli de extragere
- Reguli pe tip de document
- Testate pe eșantioane
- Apoi aplicate
Același element de două ori
- Dovezi alăturate
- Îmbinate sau păstrate separat de o persoană
- Separate din nou în caz de eroare
Căutați orice și vedeți de unde provine.
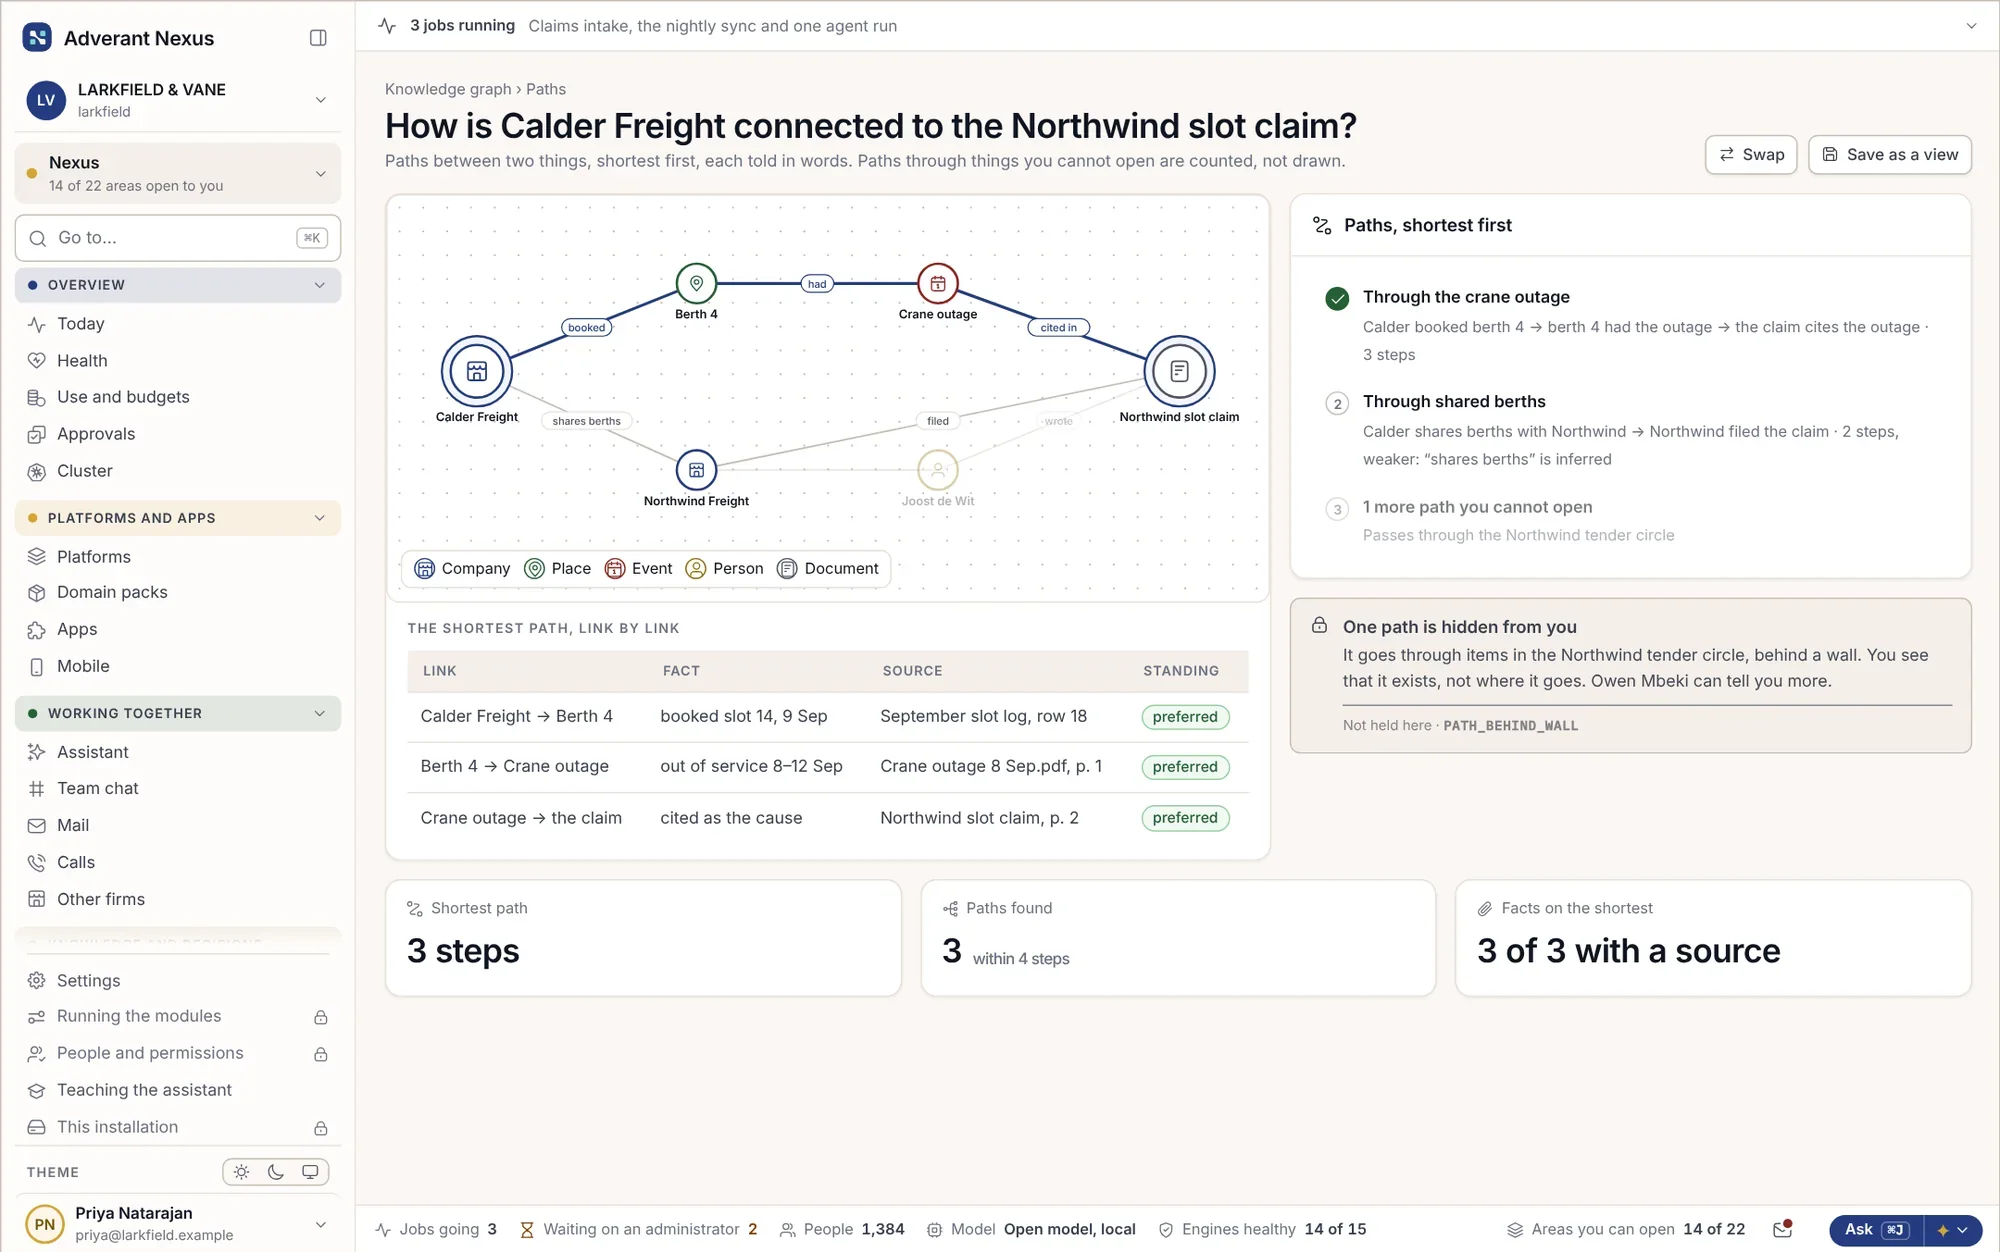
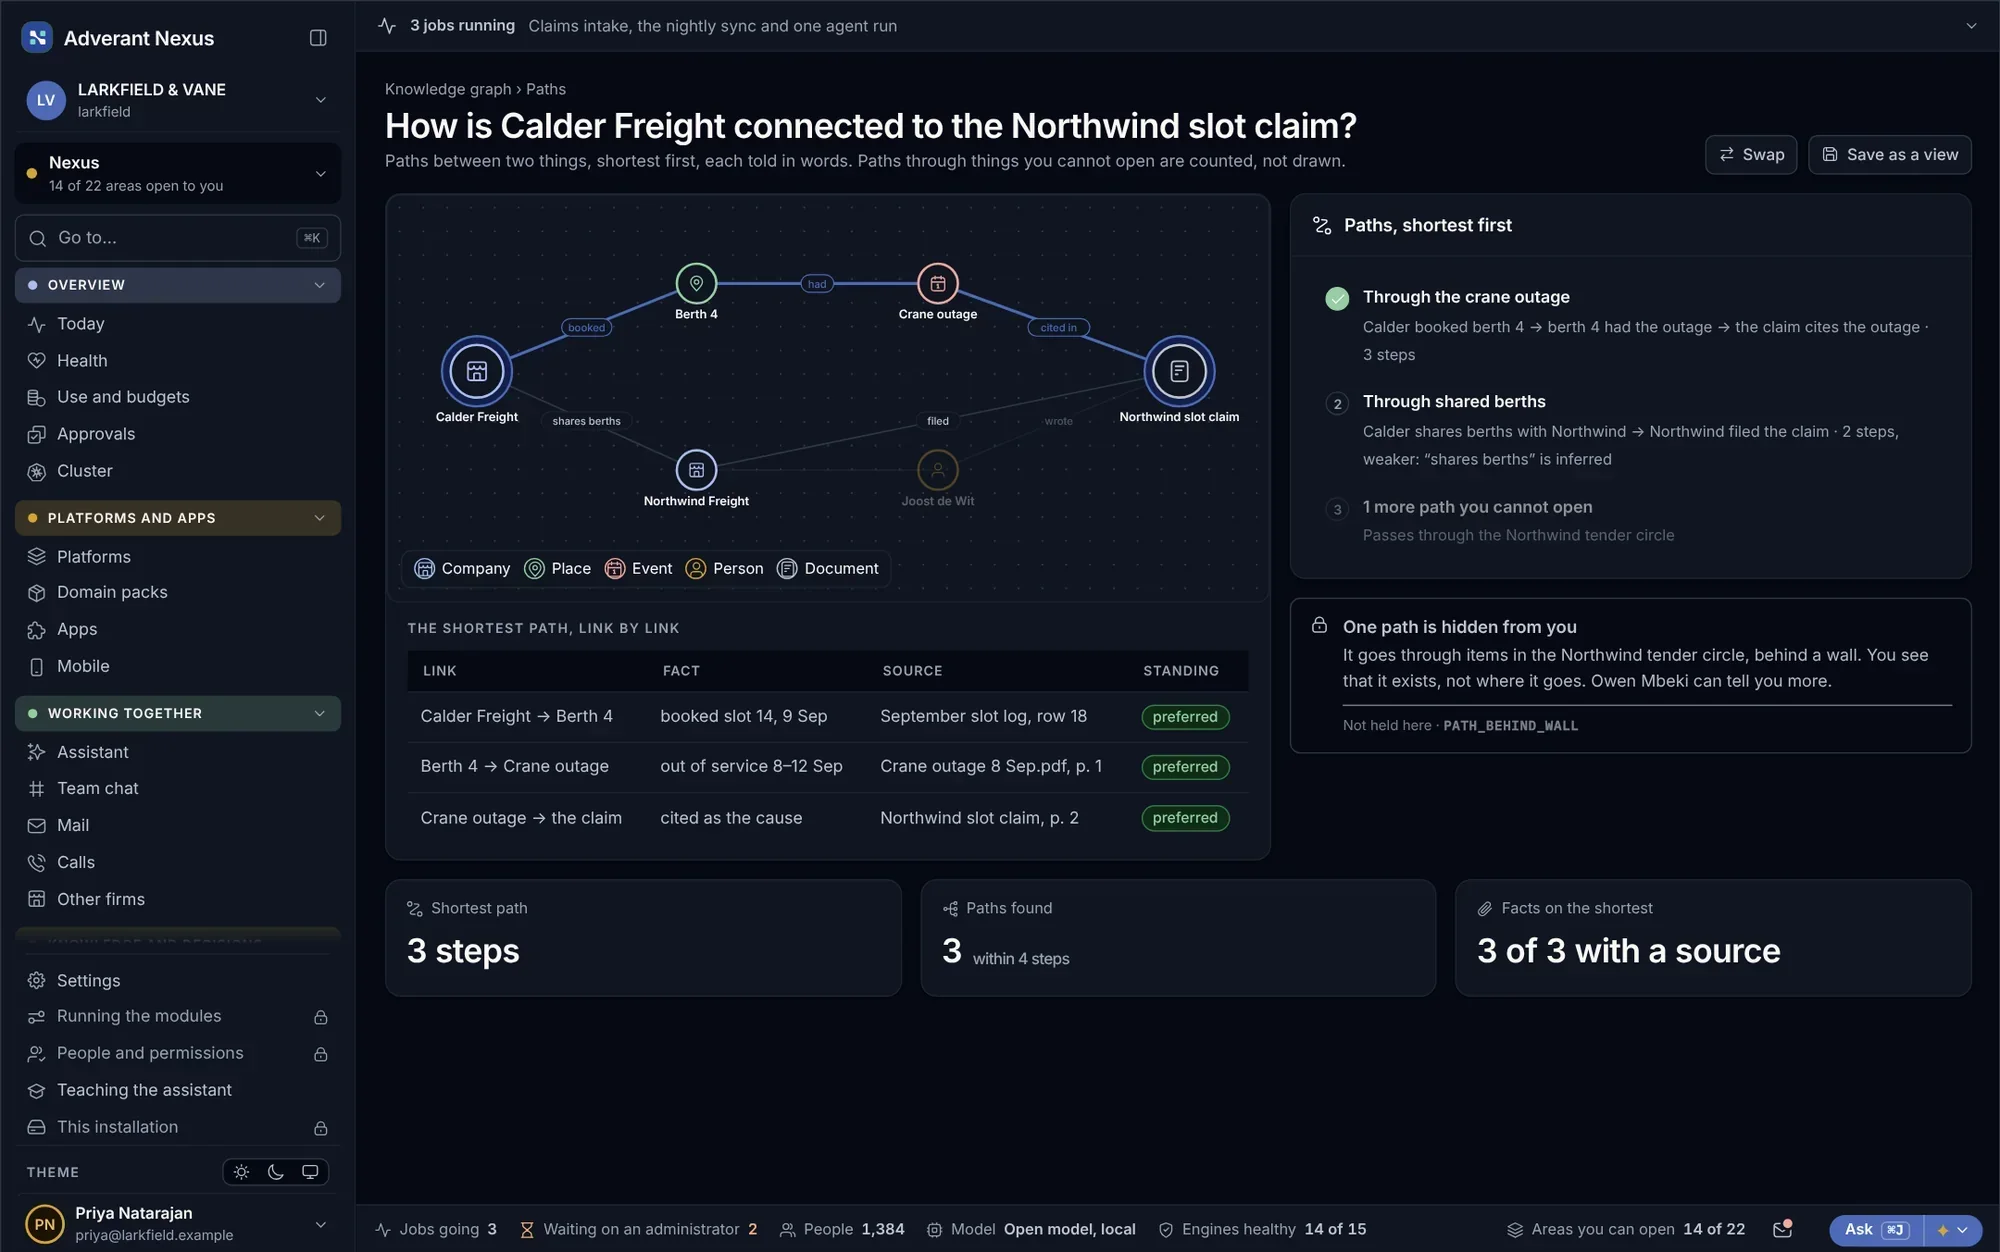
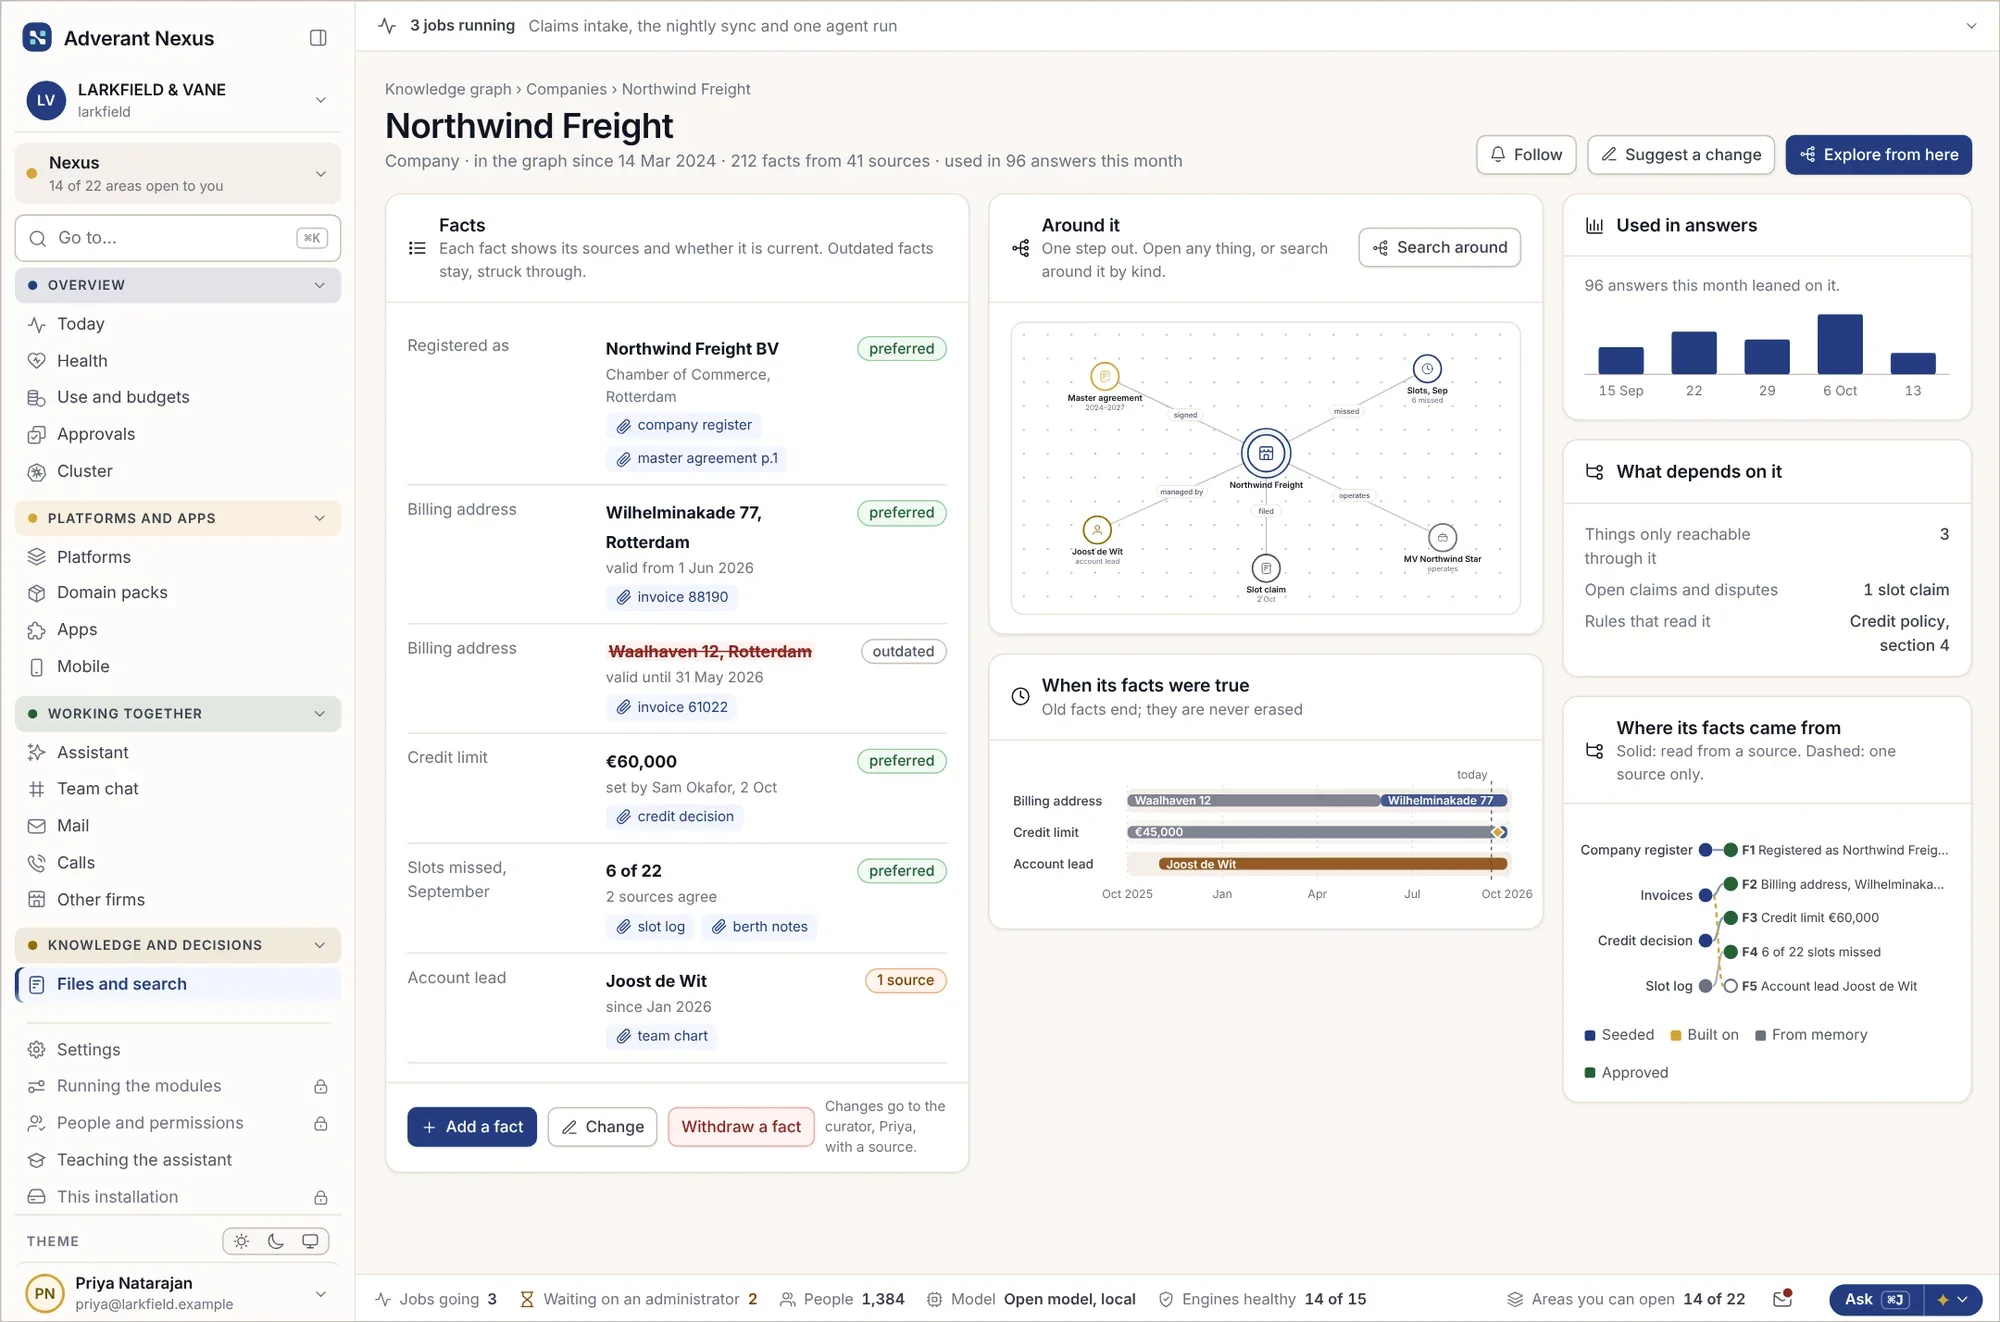
Deschideți o entitate pe o singură pagină înainte de un apel. Explorați elementele din jurul ei și salvați vizualizarea pentru echipă. Clarificați neconcordanțele cu ajutorul istoricului fiecărei informații.
O entitate, pe o singură pagină
Ce știm despre o companie înainte de un apel: de unde și de când.
- Totul despre o entitate
- Surse pe fiecare rând
- Corectați o informație exact unde o găsiți
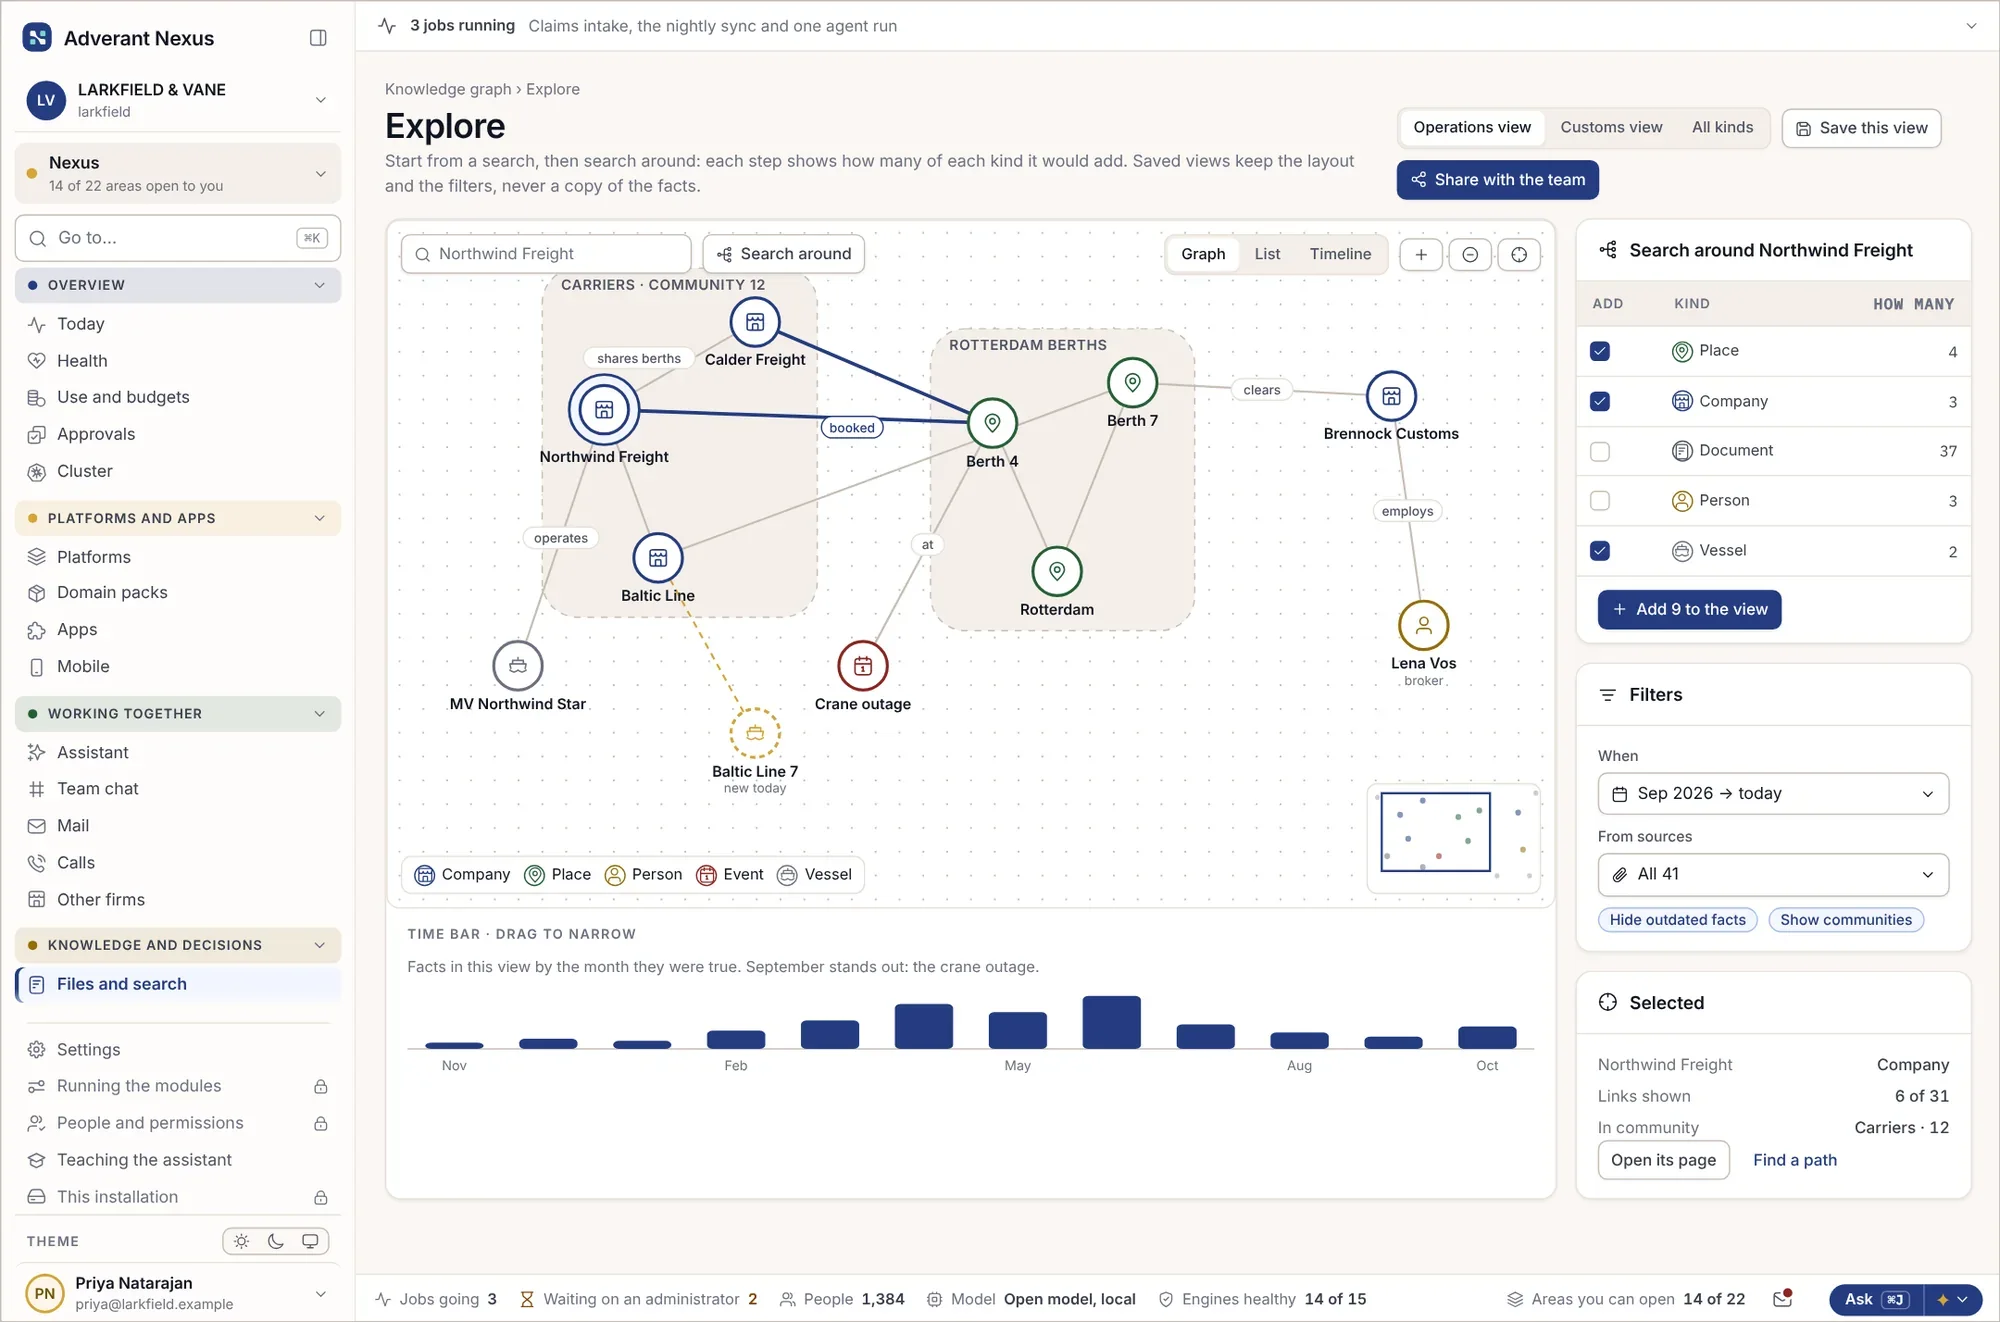
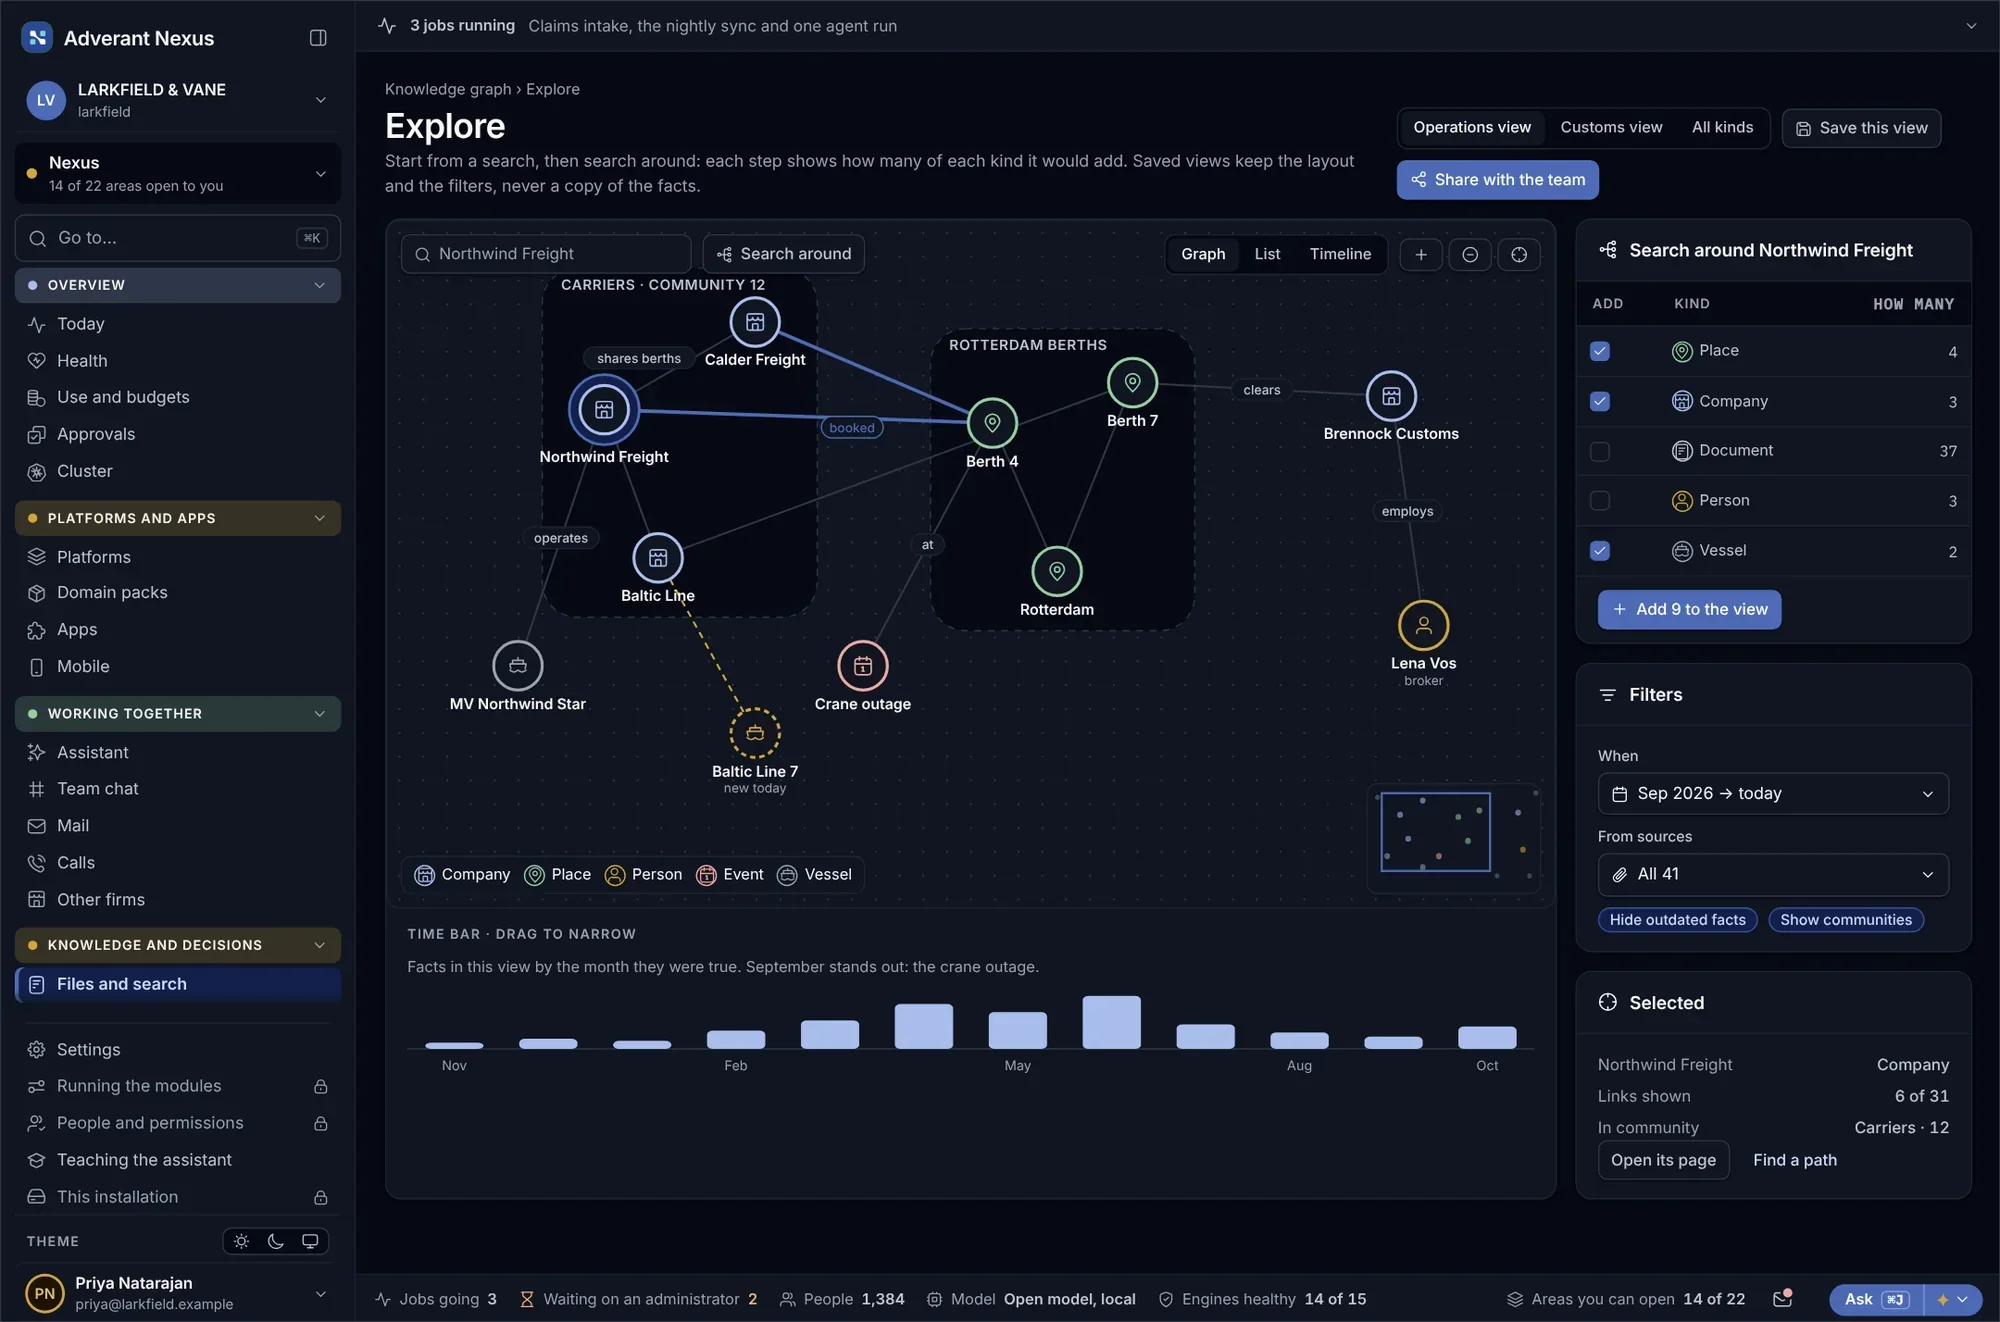
Explorați în jurul unei entități
Porniți de la o navă, un client sau o dană și vedeți ce se află în jurul lor.
- Explorare vizuală
- Vizualizări salvate și partajate
- Perspectivele decid ce vede fiecare rol
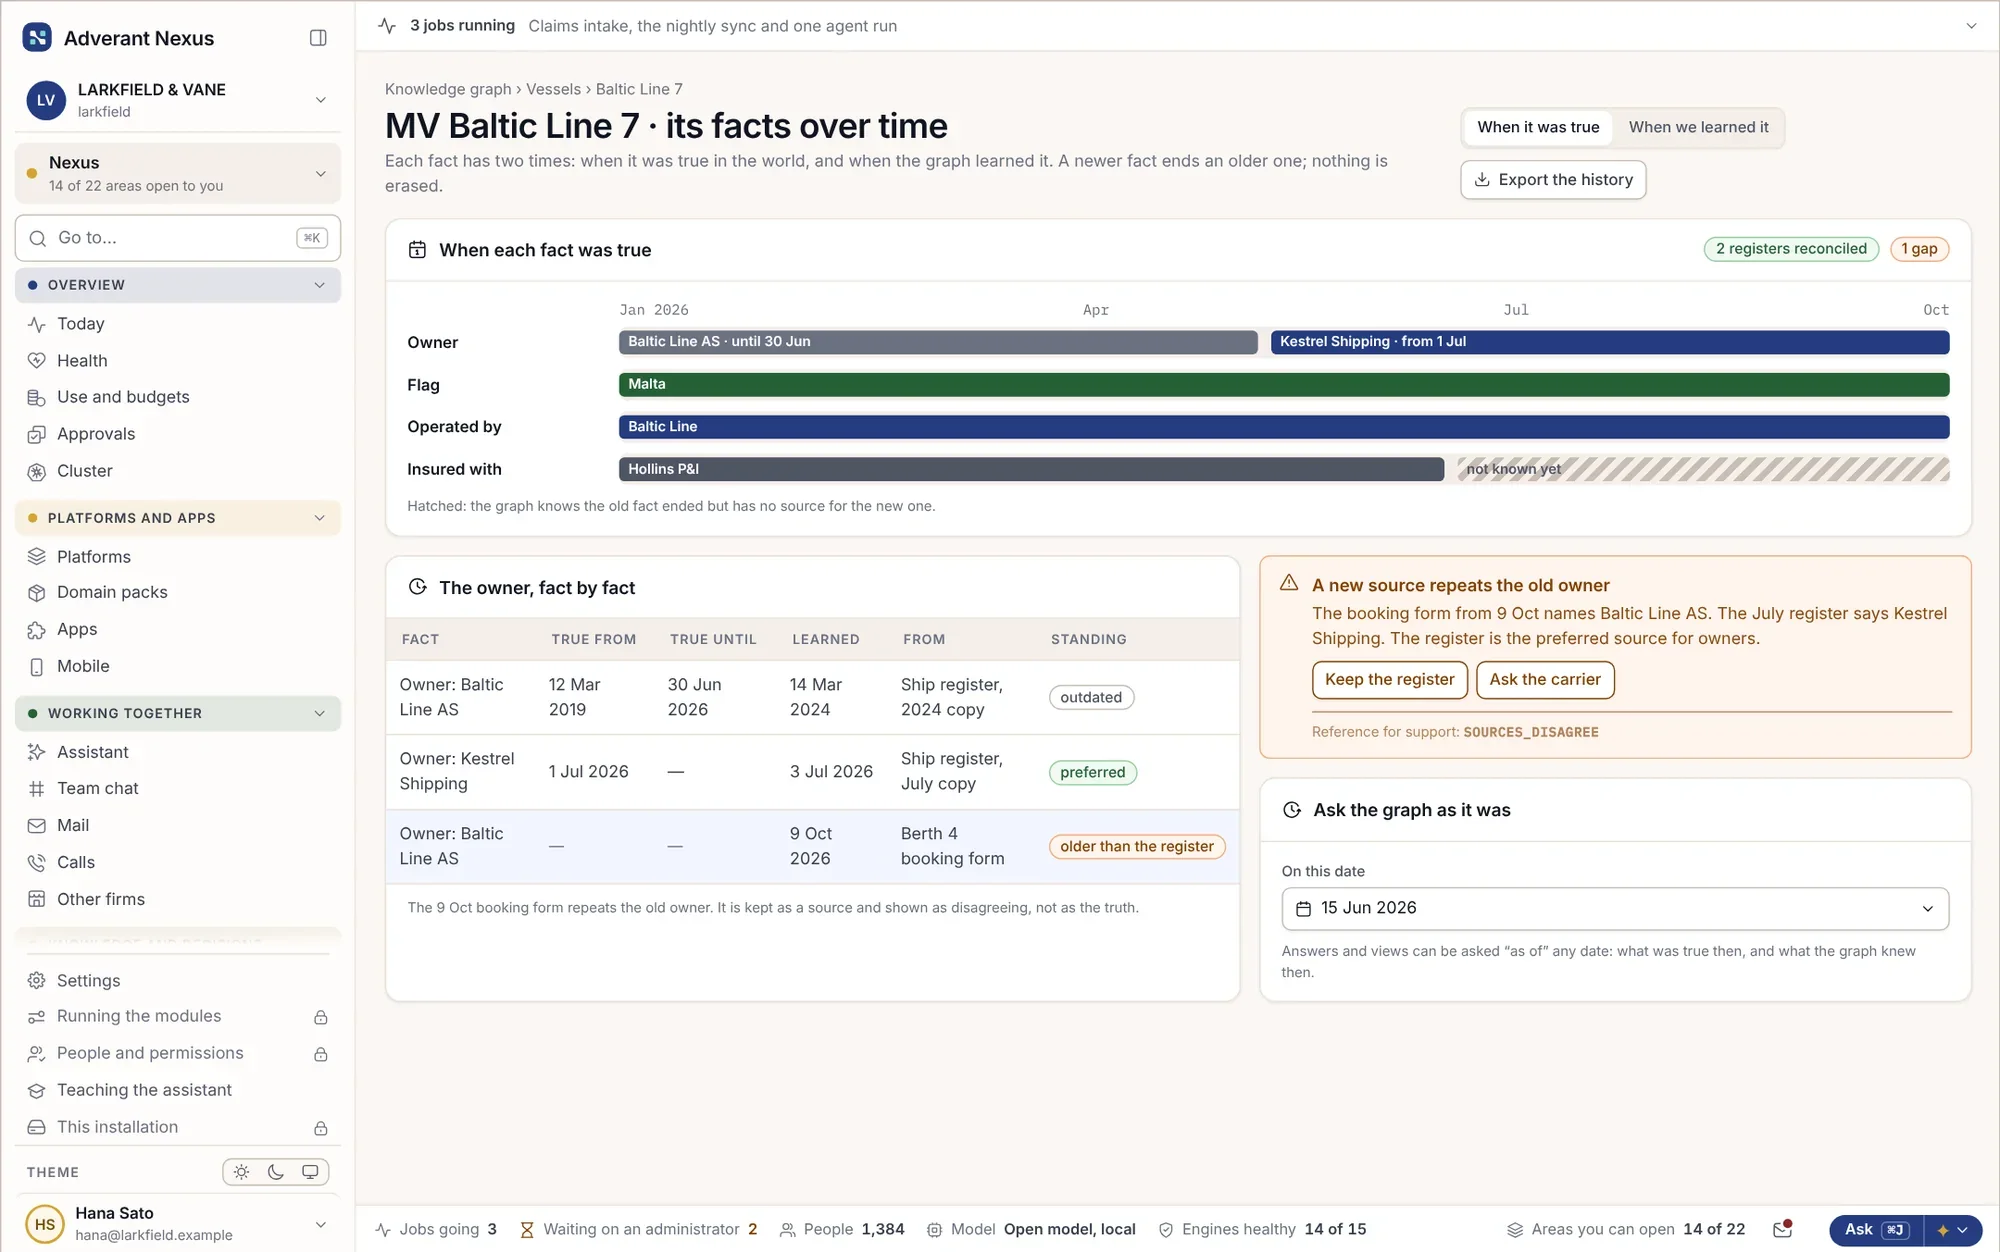
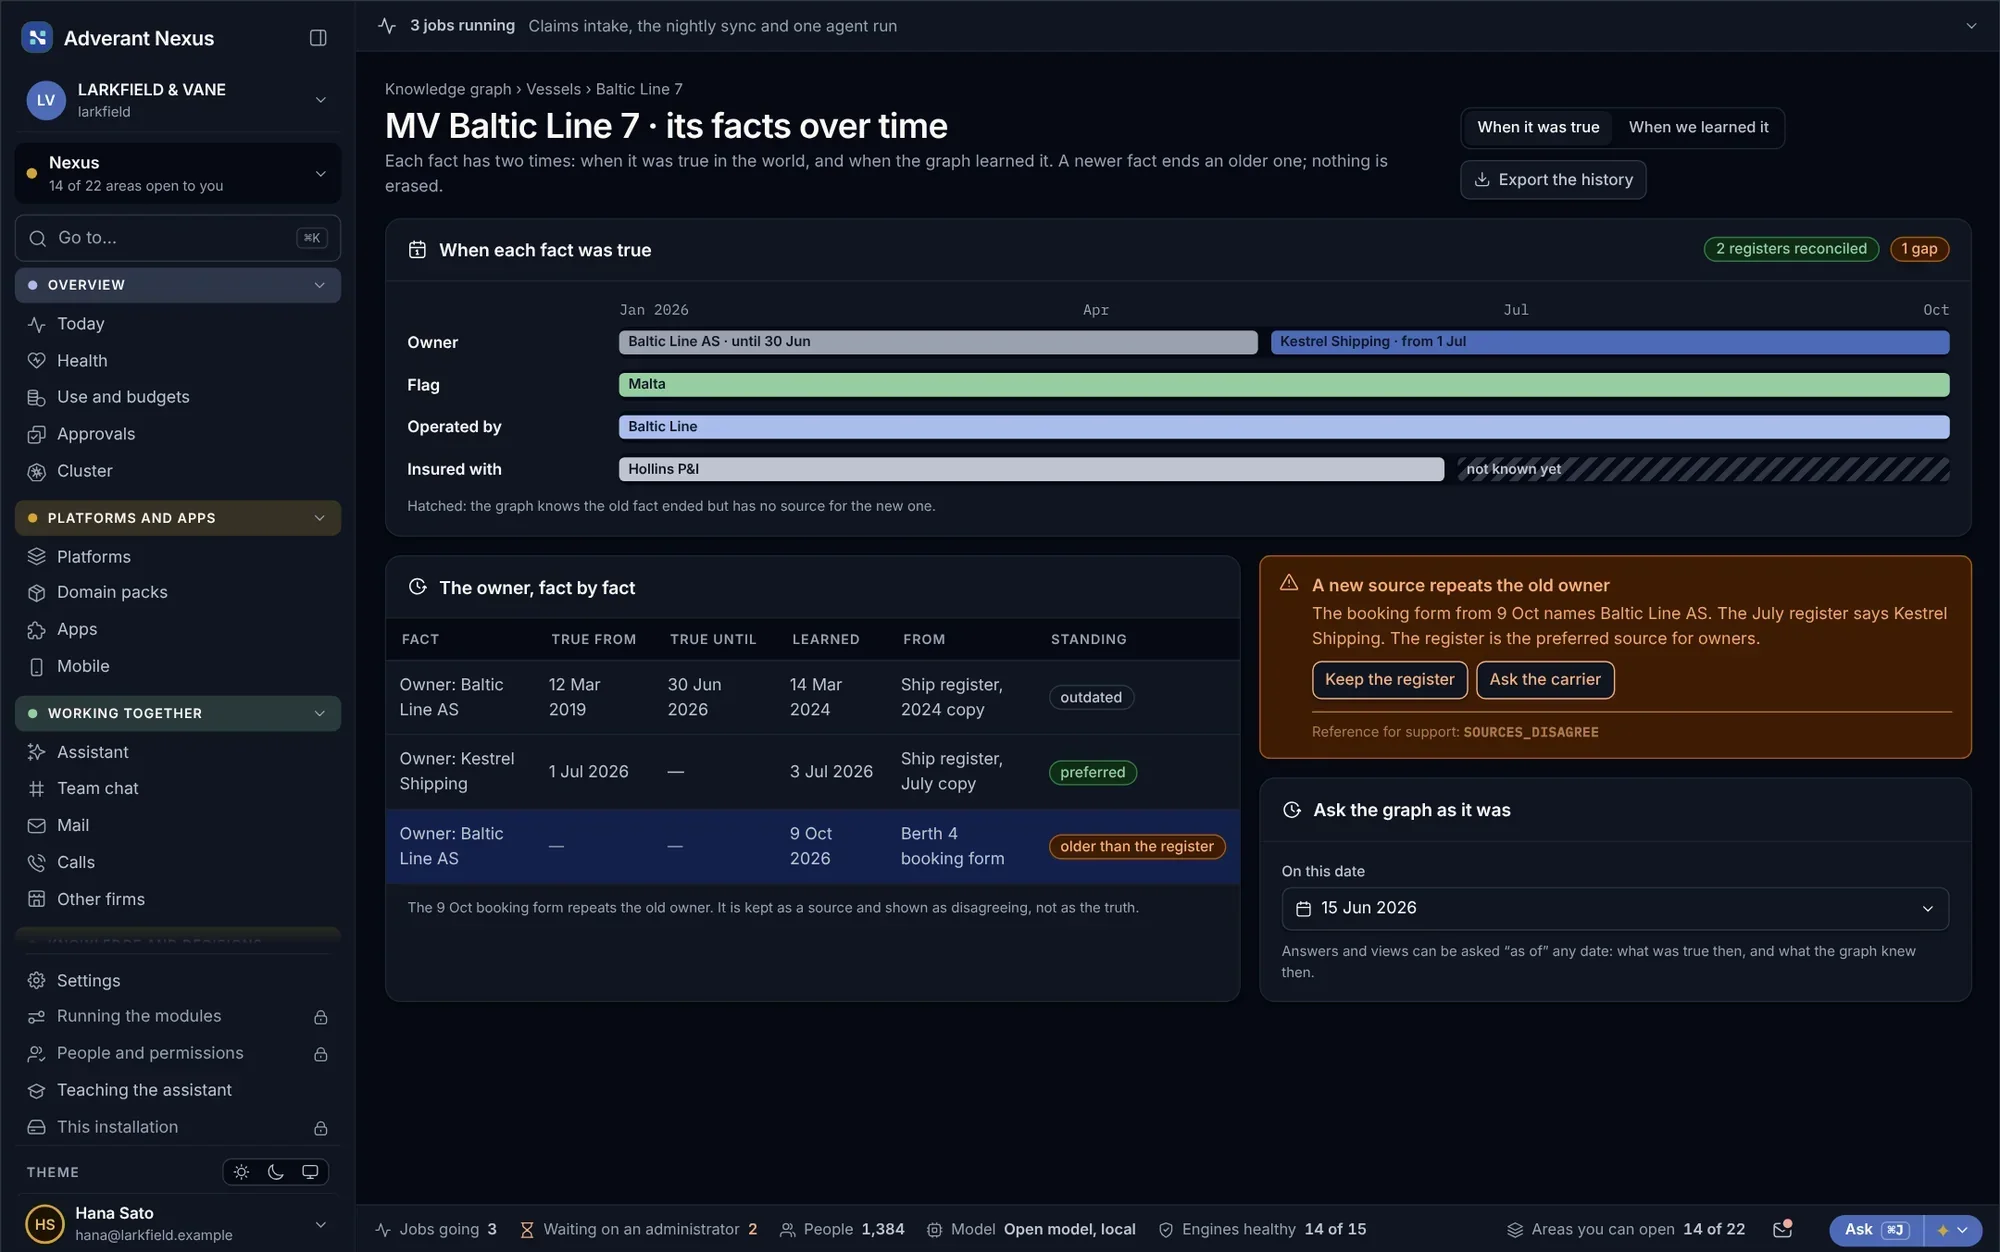
Evoluția informațiilor
Două registre se contrazic în privința proprietarului unei nave. Clarificați situația pe bază de dovezi.
- Istoric pentru fiecare informație
- Surse alăturate
- Clarificat de o persoană, cu motivare
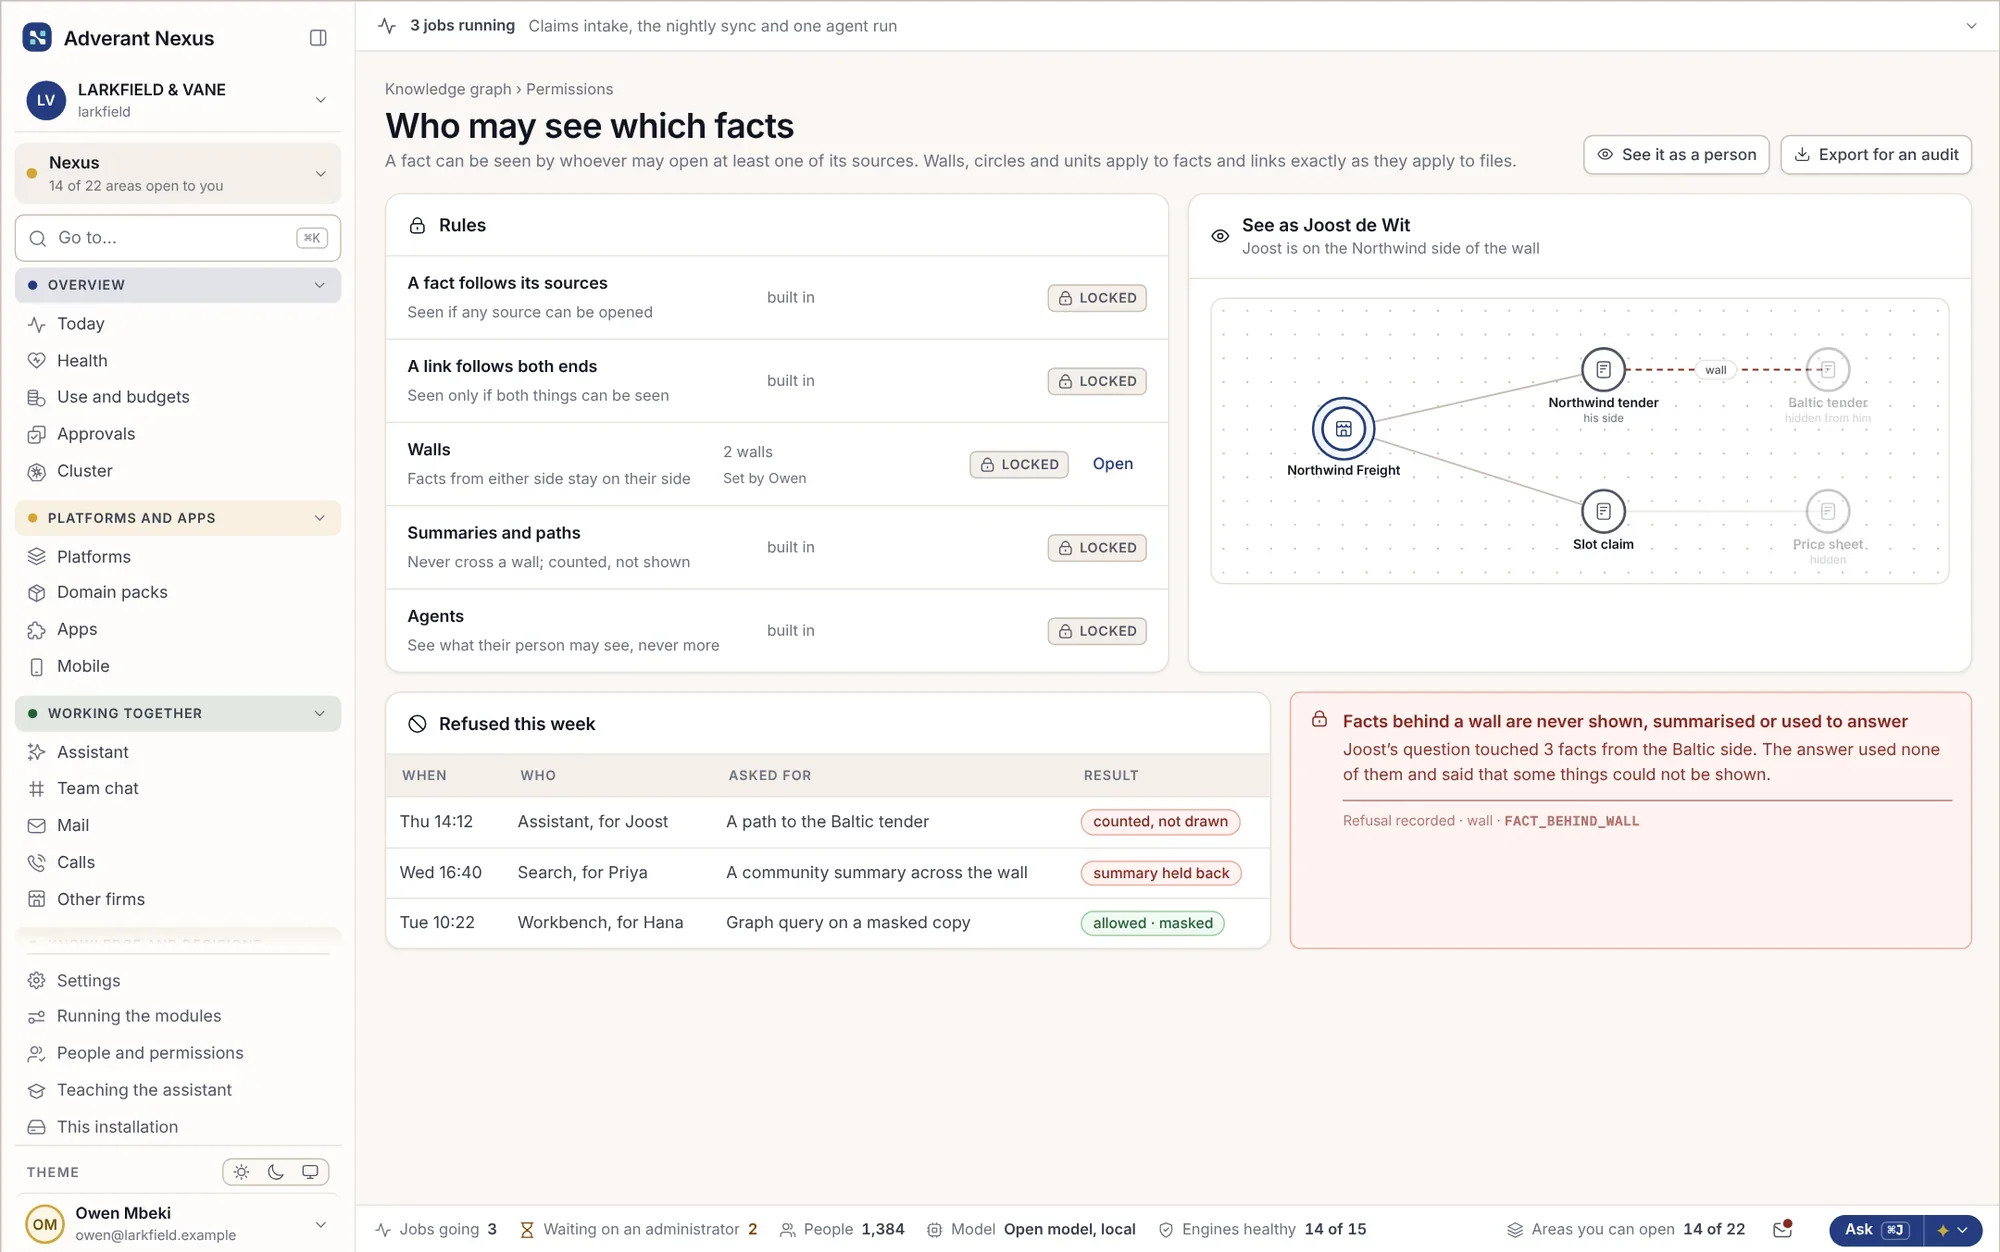
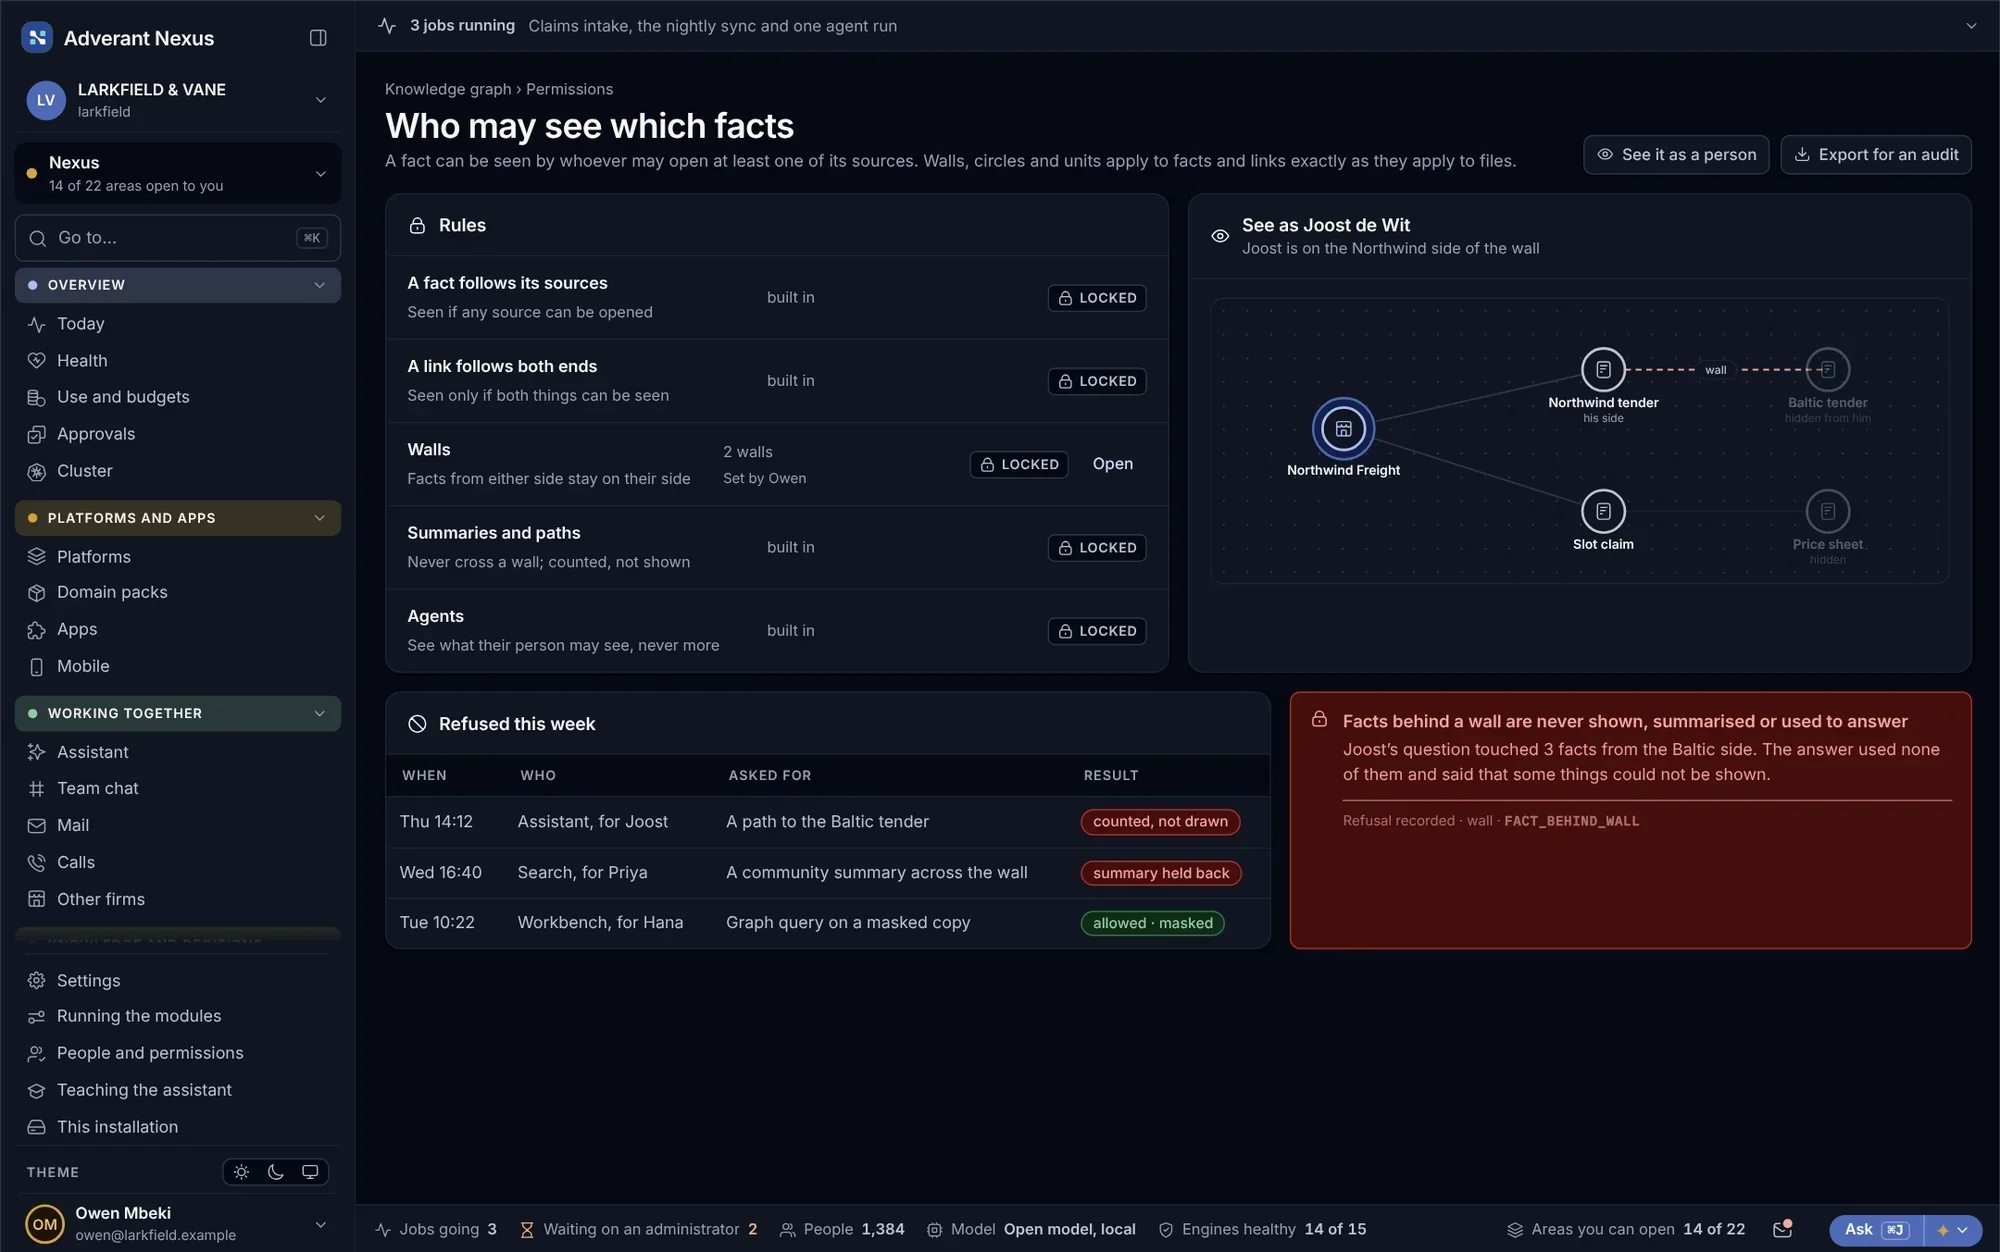
Protejat informație cu informație.
Permisiunile și barierele informaționale se aplică la nivel de informație individuală, nu doar la nivel de document. Două echipe de ofertare pot lucra pe același graf fără ca vreuna să vadă datele celeilalte, iar IA răspunde exclusiv pe baza informațiilor pe care solicitantul are dreptul să le vadă.
- Permisiuni la nivel de informație
- Barierele se mențin în interiorul grafului
- Răspunsuri bazate doar pe informații vizibile
Despre graful de cunoștințe.
Ce este GraphRAG?
O metodă de regăsire pentru IA care operează pe un graf de cunoștințe în loc de text nestructurat. Găsește informațiile legate de o întrebare din întreaga companie și le oferă modelului împreună cu sursele lor, astfel încât răspunsurile se bazează pe mult mai mult context decât poate cuprinde o instrucțiune (prompt).
Avem nevoie de o ontologie înainte de a începe?
Nu. Puteți porni de la modelul oferit de un pachet de domeniu sau de la ceea ce găsește Nexus în documentele dvs., rafinându-l pe parcurs.
Construirea grafului ne afectează sistemele?
Nu. Nexus doar citește din sistemele dvs.; nu scrie în ele. Graful este construit în paralel cu acestea.
Putem exporta baza de cunoștințe?
Da, sub forma unui pachet semnat, de exemplu pentru a o muta pe un cluster de testare.
Aflați mai multe
Priviți-vă compania ca pe un graf.
Aduceți un registru și câteva documente. Vom construi împreună prima versiune a modelului dvs. și îi vom pune întrebări.